Учим нейросеть на меньшем, но с умом экспресс
Белков в природе — как песчинок на пляже, и у каждого своя работа: одни расщепляют пищу, другие строят клетки. Но чтобы понять, чем именно занят конкретный белок, его нужно изучить в лаборатории — а это медленно и дорого. Нейросети умеют угадывать функцию белка по его «тексту» — последовательности аминокислот, но их обучение требует огромного числа размеченных примеров. Проблема в том, что размеченных белков мало: на каждый проверенный в лаборатории приходится миллион неизвестных.
Группа исследователей предложила подход, похожий на умного студента, который не зубрит весь учебник, а спрашивает учителя только о самых трудных местах. Такой метод называется активным обучением: модель сама выбирает белки, в которых она наименее уверена, и просит человека-эксперта дать им правильную метку. Затем модель дообучается на этих избранных примерах. Учёные собрали систему, которая объединяет несколько стратегий выбора «трудных» белков и позволяет человеку вручную проверять и корректировать предсказания.
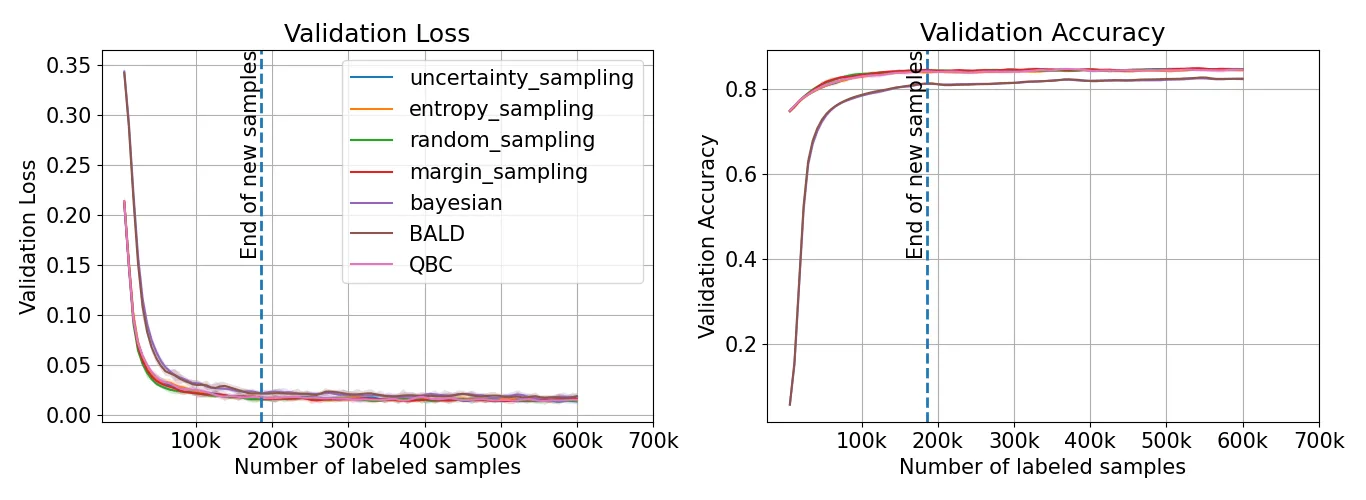
Результаты сравнили с обычным обучением, когда модели скармливают все данные подряд. Оказалось, что активное обучение достигает той же точности предсказаний, но при этом требует меньше обновлений модели, обрабатывает меньше данных и заметно экономит вычислительные ресурсы. Для исследователей это означает, что изучать функции белков можно быстрее и дешевле, не теряя в качестве.
Такой подход особенно важен сейчас, когда базы данных белковых последовательностей растут взрывными темпами, а экспериментальная проверка не поспевает. Вместо того чтобы ждать годы, пока каждый новый белок изучат в лаборатории, учёные могут сосредоточиться на самых загадочных и перспективных кандидатах. Это как искать алмазы в куче песка, просеивая не всё подряд, а только те места, где блеск уже заметен.
Самый большой банк белковых последовательностей содержит сотни миллионов записей, но лишь крошечная доля из них проверена экспериментально — меньше одного процента.