Когда код не рождается из статьи экспресс
Переводчик, который никогда не был на совещании, переводит дословно — и теряет половину смысла. Он не знает, что кивок начальника означает «сделайте как в прошлый раз», а фраза «ну, посмотрим» — вежливый отказ. Так и языковая модель, которая пишет код по научной статье: уравнения она прочитает, а вот негласные договорённости — нет.
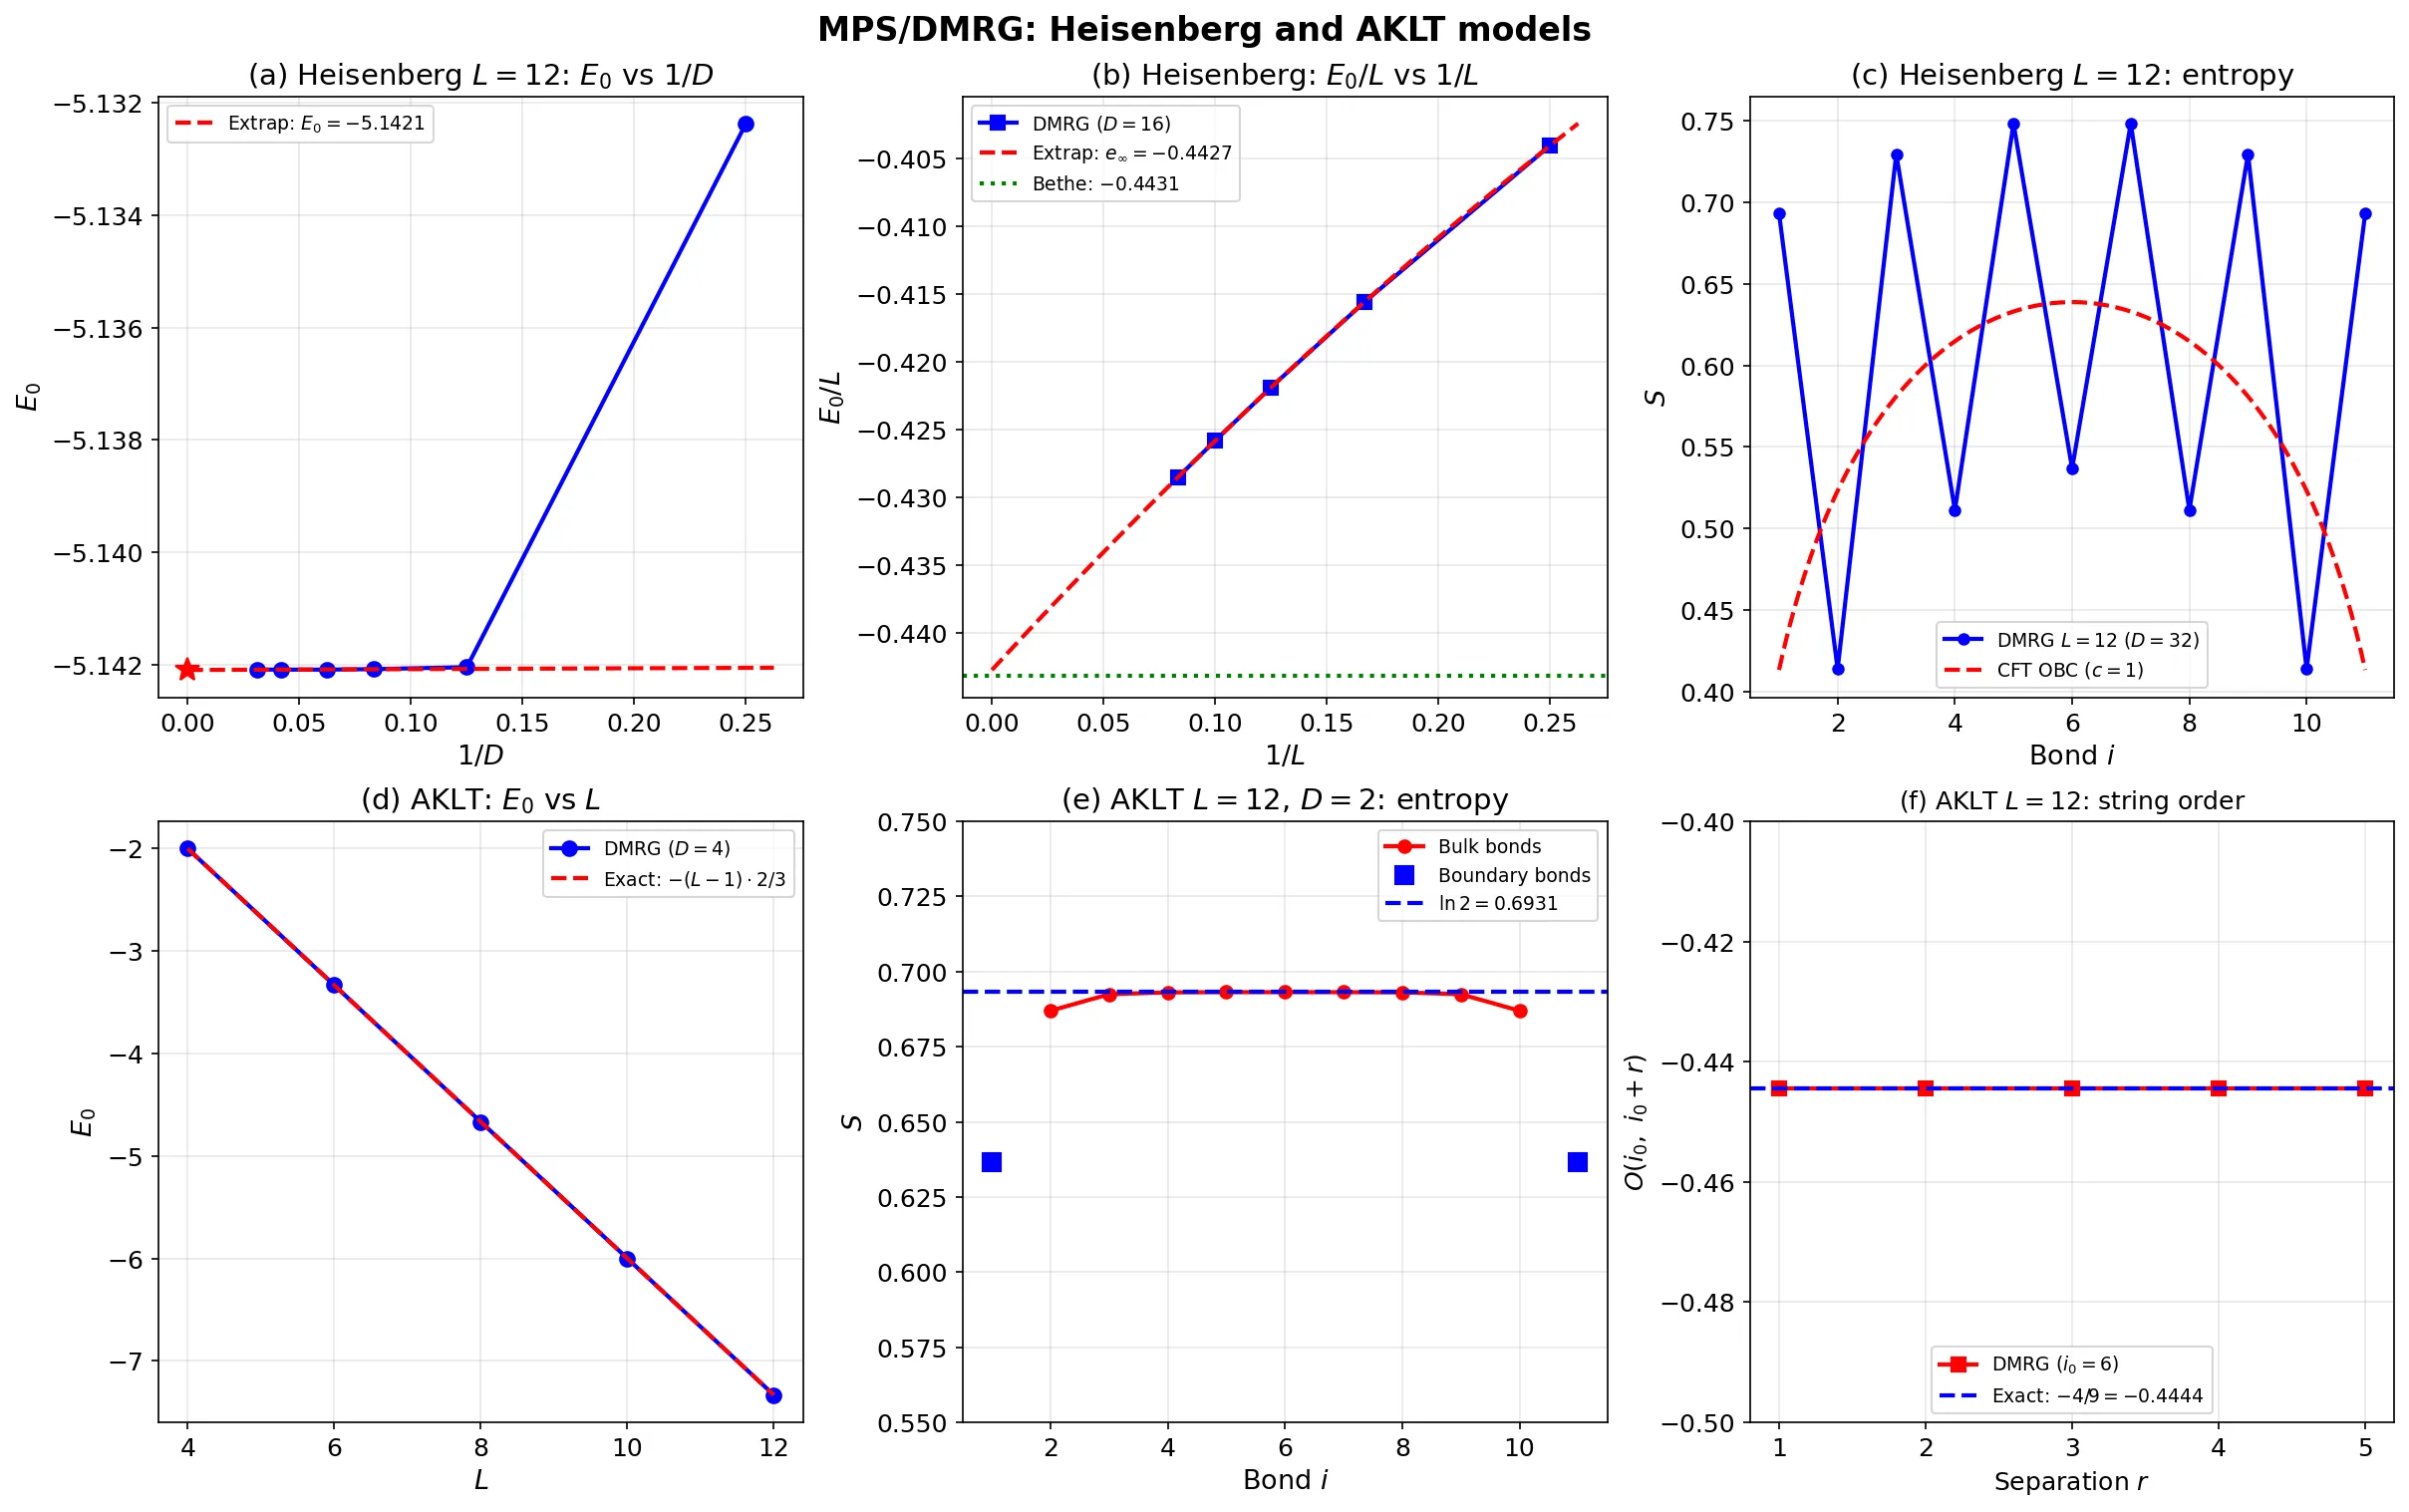
Авторы работы решили проверить, можно ли научить ИИ вытаскивать эти скрытые правила из текста. Они взяли две задачи из квантовой физики многих тел — области, где частиц так много, что считать их по одной бессмысленно. Для первой задачи, попроще, человек и машина вместе составили подробную спецификацию: какие индексы куда ставить, какой знак перед слагаемым, в каком порядке перемножать. После этого программа заработала во всех шестнадцати вариантах. Без такой подготовки — только в шести из тринадцати.
Вторая задача оказалась крепким орешком. Там нужно было перестроить сложную математическую конструкцию, и скрытых правил было больше: знаки, калибровки, порядок, ограничения на размер. Даже после совместного составления спецификации программы работали лишь в одиннадцати случаях из двадцати шести. А без подготовки — вообще ни разу.
Любопытная деталь: спецификации, составленные одной моделью, отлично реализовывались другой, но наоборот — не получалось. Это значит, что проблема не только в понимании статьи, но и в способности самой модели писать корректный код. Два узких места.
Такой подход — не просто способ получить программу. Это ещё и диагностический инструмент: он показывает, где именно ИИ спотыкается. И, возможно, подскажет, как делать модели умнее.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2604.04089
Large language models can write scientific code, but direct paper-to-program translation remains fragile when correctness depends on tacit conventions rather than explicit equations. We frame this as a knowledge-externalization problem: index choices, gauges, fermionic signs, contraction order, validation gates, and scaling constraints must be made explicit before code generation. We evaluate a multi-stage, human-in-the-loop workflow on two quantum many-body tasks. DMRG from Schollwoeck's pedagogical review serves as calibration: specification-guided implementations pass in all 16 model pairings, compared with 6/13 direct attempts, and a prose-specification ablation shows that externalized content, not LaTeX form, is the active ingredient. Pfaffian conversion of HFB states to MPS from the five-page Letter by Jin et al. serves as the stress test: the archived runs use a closed-world NumPy/SciPy/Matplotlib protocol, with no TeNPy, TeMFpy, or external implementation code supplied to the agents, so success depends on reconstructing tacit sign, gauge, ordering, and scalability conventions within a restricted dependency setting. Here the workflow yields 11/26 audited passes, while direct prompting yields none. Cross-specification transfer is asymmetric: non-GPT specifications implemented by GPT 5.5 pass 4/4, whereas GPT 5.5 specifications implemented by the tested non-GPT models fail 4/4. The contrast supports a two-bottleneck picture. Externalization resolves the first bottleneck -- paper-to-code ambiguity -- well enough to make DMRG reproducible and Pfaffian-MPS auditable. The remaining failures expose a second bottleneck in implementation-model capability. Iterative meta-specification moves this boundary but does not eliminate it. The resulting Paper-to-Program Many-Body skill is both a reusable implementation protocol and a diagnostic instrument for AI-assisted many-body programming.
В работе использовали модель под названием GPT 5.5 — это вымышленная модель, а не реальная. Авторы намеренно скрыли настоящие названия, чтобы сосредоточиться на методе, а не на конкретных продуктах.
В рассказе Айзека Азимова «Как поймать кролика» робот не может выполнить задачу, потому что не понимает негласное правило — и это приводит к сбою. Здесь похожая история: ИИ нужно не просто знание, а понимание контекста.