Un grafo en lugar de pesos: cómo seleccionar los mejores pronósticos de El Niño ✛
Contexto
El trabajo se sitúa junto a investigaciones donde las redes neuronales ya intentan reforzar el pronóstico de El Niño: unas aprenden sobre grafos, otras captan la señal en el débil lente gravitacional o en el ruido de los detectores. Aquí la tarea es distinta: no entrenar un modelo nuevo, sino entender un conjunto ya formado de 80 pronósticos. Antes se promediaban simplemente con pesos según la precisión general de los módulos, pero no se observaba cuán similares eran los pronósticos individuales entre sí. Los autores introducen una estructura de grafo donde la similitud entre pronósticos se vuelve explícita, lo que permite filtrar el ruido y conservar un núcleo coherente.
Métodos
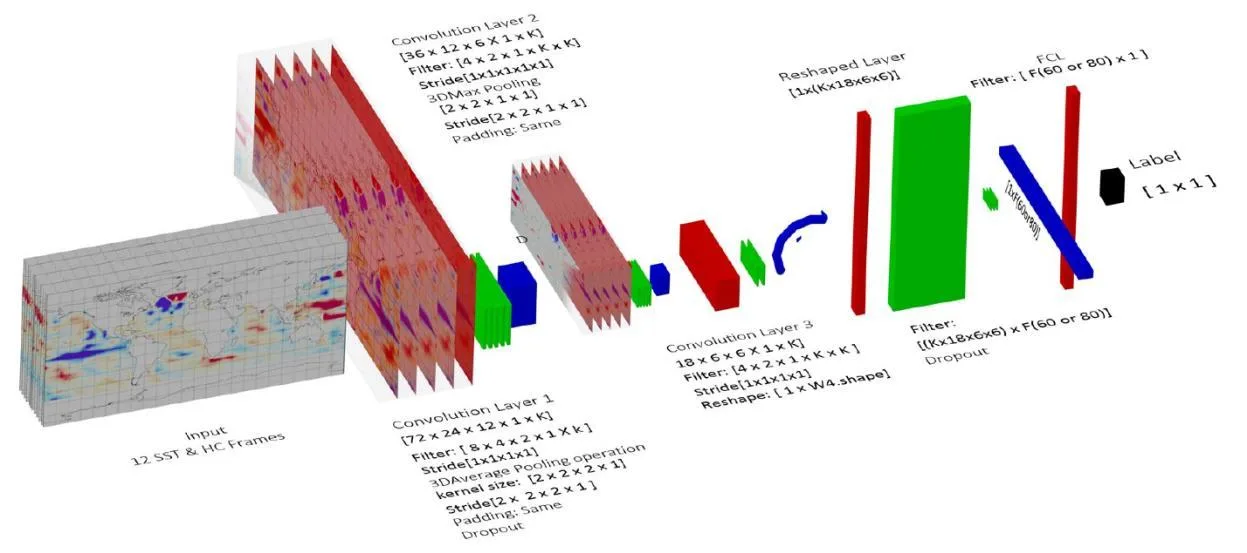
Primero, el modelo MEF produce 80 pronósticos: 40 de la red convolucional 3D, que procesa mapas de anomalías de temperatura del océano como si fueran video, y 40 del módulo de series temporales. Luego, cada pronóstico se convierte en un nodo de un grafo ponderado no dirigido. El peso de la arista entre dos pronósticos se calcula según su similitud: se utilizan el error cuadrático medio y la correlación de Pearson. A los nodos se les añaden características como el error y la suavidad de la serie temporal. Después, un algoritmo de grafos detecta comunidades, es decir, grupos de pronósticos que se comportan de manera similar. Del grupo más denso y preciso se toman 20 pronósticos y se promedian. Los cálculos se realizaron en tarjetas gráficas NVIDIA Tesla A100 en Google Colab, con datos de aproximadamente un terabyte provenientes de 21 modelos CMIP5 y observaciones GODAS.
Resultados
La selección basada en grafos mejoró la correlación del pronóstico en aproximadamente un 10% en comparación con el modelo MEF original, especialmente en plazos superiores a un año. Para todos los horizontes de 1 a 23 meses, la correlación se mantuvo por encima de 0.4, y a los 23 meses el modelo capturó casi la mitad de todos los eventos de El Niño y La Niña. Los 20 pronósticos seleccionados no solo resultaron más precisos individualmente: también mostraron menor dispersión del error entre diferentes plazos, transiciones más suaves entre fases y una conectividad más densa en el grafo. Sin embargo, el enfoque de grafo no siempre supera al MEF base en cada escenario particular, pero ofrece resultados más estables y coherentes, especialmente en casos complejos con horizonte largo.
Implicaciones
A diferencia de trabajos vecinos donde las redes neuronales de grafo aprenden a predecir por sí mismas o mejoran modelos individuales, aquí el grafo se usa como meta-herramienta: no hace el pronóstico, sino que pone orden en un conjunto ya formado. Esta es la primera verificación de que la similitud estructural entre pronósticos puede servir como filtro de ruido sin modificar el modelo en sí. Este enfoque es agnóstico al modelo y transferible a cualquier sistema de conjunto, desde modelos climáticos dinámicos hasta esquemas estadísticos híbridos.
Desarrollo futuro
El análisis de conjuntos mediante grafos podría convertirse en una etapa estándar de posprocesamiento en la predicción estacional y subestacional. Si se aprende a construir rápidamente grafos de similitud para miles de miembros de un conjunto, la selección del núcleo coherente se volvería una operación rutinaria. A continuación, se podrían probar diferentes medidas de similitud: deformación dinámica del tiempo, distancia coseno, características de entropía. Un interés particular es comprender por qué los pronósticos seleccionados forman una comunidad densa y qué mecanismos físicos subyacen a ello.
Impacto
El método es aplicable a cualquier sistema que genere múltiples pronósticos: desde modelos climáticos hasta conjuntos financieros o epidemiológicos. En la predicción operativa de El Niño, podría aumentar la fiabilidad de las alertas de sequías, inundaciones y calor anómalo con varios meses de antelación.
Próximos pasos
Probar el método en otros sistemas de conjunto, por ejemplo, en los modelos dinámicos de C3S o en pronósticos subestacionales. Investigar cómo la elección de la medida de similitud y del tamaño de la comunidad afecta la calidad de la selección.
Problemas abiertos clave
El trabajo aborda un viejo problema de la climatología: la barrera de previsibilidad primaveral, cuando la habilidad de los modelos cae bruscamente al cruzar la primavera. La selección mediante grafos no elimina la barrera por completo, pero hace que el pronóstico sea más robusto en plazos largos, donde los métodos clásicos se degradan. Es un paso hacia la comprensión de cómo extraer señal de un conjunto ruidoso en condiciones de creciente variabilidad climática después del año 2000.
La mirada de la máquina del conocimiento
Esta sección está dirigida al autor del trabajo y a sus colegas. Los trabajos vecinos los encontró la búsqueda por significado en nuestro archivo, no por coincidencia de palabras. No evaluamos: mostramos el campo alrededor.
Qué hace el trabajo
Los autores tomaron un conjunto de 80 pronósticos del modelo MEF (40 de una red convolucional 3D y 40 del módulo de series temporales), construyeron un grafo donde los nodos son los pronósticos y las aristas su similitud en error y correlación, luego identificaron comunidades y seleccionaron los 20 pronósticos más coherentes y precisos. Promediar este núcleo mejoró la correlación en aproximadamente un 10% en horizontes largos y mantuvo la habilidad por encima de 0.4 para todos los plazos hasta 23 meses.
Dónde está su fuerza
El trabajo introduce el grafo como una metaherramienta para filtrar el ruido en un conjunto ya existente, sin modificar el modelo en sí. Este enfoque es agnóstico al modelo y transferible a otros sistemas de conjunto.
Hacia dónde puede avanzar
- Podría ser interesante observar cómo se comporta la selección por grafos en otros pronósticos de conjunto de El Niño, por ejemplo, en un trabajo donde una red neuronal predice El Niño con un año y medio de anticipación. Transferir el método a su conjunto permitiría comprobar la universalidad del enfoque.se apoya en: El Niño puede predecirse con año y medio de antelación arXiv:2601.12251
- Cerca hay un trabajo sobre pronóstico del tiempo en una sola tarjeta gráfica, que utiliza una arquitectura eficiente. Se podría intentar combinar la selección por grafos con su modelo rápido para obtener una ventaja tanto en velocidad como en calidad del conjunto.se apoya en: Pronóstico del tiempo con una sola tarjeta gráfica arXiv:2603.21284
- En el archivo hay un trabajo sobre compresión de redes donde los caminos se convierten en puntos; allí también se seleccionan elementos según su conectividad. Quizás sus métricas de importancia de nodos puedan ayudar a mejorar la identificación de comunidades en el grafo de pronósticos.se apoya en: Comprimiendo redes: cuando las carreteras se convierten en puntos arXiv:2607.14834
Vale la pena probar
- Probar otras métricas de similitud entre pronósticos, por ejemplo, correlación dinámica o distancia en el espacio de estados.
- Verificar cómo depende el resultado del tamaño del núcleo seleccionado (no solo 20 de 80).
- Aplicar la selección por grafos a un conjunto de diferentes modelos (CMIP5 y observaciones), no solo a los pronósticos de un único modelo.
Por qué puede importar
Si la selección basada en grafos realmente mejora de manera consistente los pronósticos a largo plazo de El Niño, podría convertirse en un postprocesamiento estándar para conjuntos en el modelado climático, aumentando la confiabilidad de las predicciones de eventos extremos.
Trabajos cercanos en nuestro archivo
- El Niño puede predecirse con año y medio de antelacióncercanía 0.49
- La red neuronal que detecta la tensión en cualquier pieza, sin importar su formacercanía 0.49
- Una red neuronal aprende a leer moléculas por su firma de carbonocercanía 0.49
- Pronóstico del tiempo con una sola tarjeta gráficacercanía 0.47
- Escultor de redes neuronales: cómo leer una lente gravitacional a partir de cuatro puntoscercanía 0.47
- SpecFANN: un boceto relámpago del espectro estelarcercanía 0.47
- Comprimiendo redes: cuando las carreteras se convierten en puntoscercanía 0.46
El archivo está vacío alrededor de este trabajo: el análisis más cercano queda en 0.49, frente a un 0.64 habitual. Parece que aquí al lado casi nadie ha perforado.
El modelo se entrenó con datos de 1875 a 1975 y se validó con datos de 2000 a 2017. Entre estos períodos hay un cuarto de siglo que el modelo nunca vio. Esta brecha se dejó deliberadamente para evitar el efecto de la memoria del océano y comprobar si el pronóstico funciona en condiciones completamente diferentes.
Cifras clave
- miembros del conjunto en total: 80
- pronósticos seleccionados: 20
- horizonte de pronóstico: hasta 23 meses
- correlación en todos los plazos: superior a 0.4
- mejora de la correlación: alrededor del 10%