La estimación por máxima verosimilitud (EMV) es una piedra angular de la inferencia estadística. Proporciona una forma fundamentada de elegir los parámetros de una distribución de probabilidad que mejor expliquen los datos observados. Dado un conjunto de puntos de datos y un modelo candidato (por ejemplo, una distribución normal con media y varianza desconocidas), la EMV selecciona los valores de los parámetros que hacen que los datos observados sean más probables bajo ese modelo. Esta 'mayor probabilidad' se cuantifica mediante la función de verosimilitud, que mide cuán probable son los datos en función de los parámetros.
Historia
El método fue introducido por Ronald Fisher en la década de 1920, basándose en trabajos anteriores de Carl Friedrich Gauss y otros. Fisher formalizó el concepto y estableció sus propiedades deseables, como la consistencia y la eficiencia.
Cómo funciona
La función de verosimilitud L(θ | datos) se construye como el producto de las probabilidades (o densidades de probabilidad) de cada punto de datos observado, dado el vector de parámetros θ. La EMV encuentra el θ que maximiza este producto. En la práctica, a menudo se maximiza la log-verosimilitud (el logaritmo natural de L) porque convierte el producto en una suma, lo que facilita la diferenciación y es numéricamente estable. El máximo se encuentra igualando a cero la derivada de la log-verosimilitud con respecto a θ y resolviendo, o mediante algoritmos de optimización numérica iterativos cuando no existe una solución cerrada.
En la práctica
La EMV es omnipresente en ciencia e ingeniería: sustenta el análisis de regresión, el entrenamiento de redes neuronales (mediante la pérdida de entropía cruzada) y la estimación de parámetros en experimentos de física, desde la física de partículas hasta la cosmología.
Dato curioso
La EMV no siempre es insesgada: por ejemplo, la estimación por máxima verosimilitud de la varianza de una distribución normal está sesgada hacia abajo por un factor de (n-1)/n, razón por la cual la varianza muestral utiliza n-1.
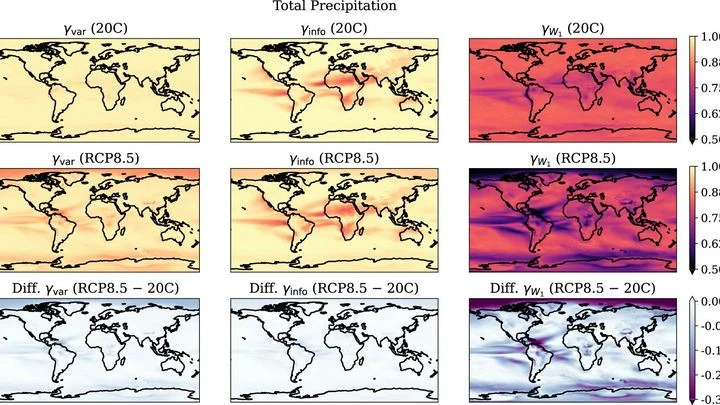
En invierno, en un barrio de la ciudad cae el triple de nieve que en el vecino. Un año hace calor, otro frío. Son los caprichos del tiempo. Pero a lo largo de décadas se observa otro cambio, más lento: los inviernos, en promedio, se vuelven más suaves. Distinguir uno de otro es la tarea principal de los climatólogos.
En 1998, el matemático David Boyd notó algo extraño. Estudiaba la medida de Mahler de un polinomio —una cantidad que mide la "complejidad" de sus raíces— y descubrió que para una familia de curvas siempre se expresa como un número racional especial racional multiplicado por el valor de la derivada de la función L.
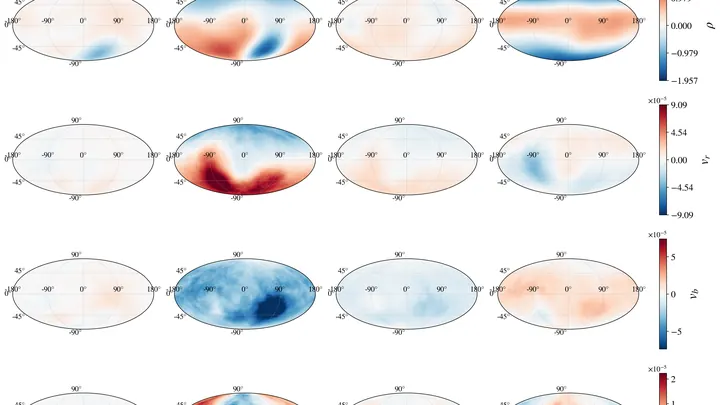
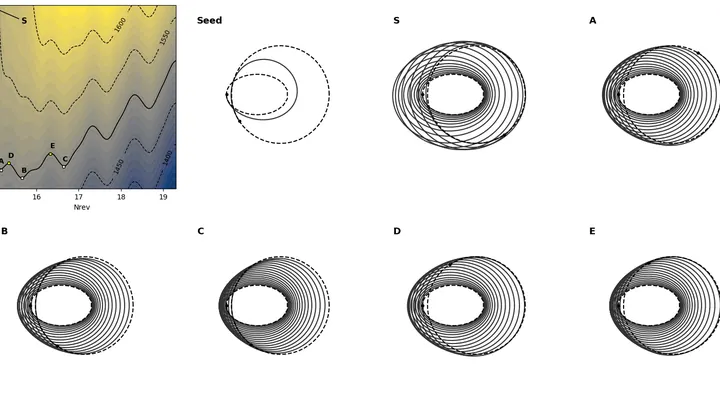
Dos galaxias — nuestra Vía Láctea y su compañera, la Gran Nube de Magallanes — giran lentamente una alrededor de la otra. Su atracción gravitacional sacude las lejanas afueras de la Vía Láctea, como una piedra lanzada a un estanque hace ondular el agua.
Doscientos millones de estrellas. En el centro de la Galaxia, donde apuntará el futuro estudio del telescopio Nancy Grace Roman, unas 250 veces durante la misión la luz de una de ellas temblará por un toque invisible.
4 610 universos — exactamente esa cantidad de modelos cosmológicos necesitaron los astrofísicos para demostrar que la familiar máscara gaussiana ya no funciona para los datos de nueva generación.
Reconstruir una imagen completa a partir de fragmentos es como distinguir la melodía de una orquesta en una sala ruidosa. Este tipo de tareas se presentan en la fotometría, donde a partir de un tenue centelleo se recupera el brillo de una estrella. Los métodos tradicionales requieren información precisa sobre el ruido, que casi nunca se conoce.
Un libro de cocina se reescribe de generación en generación, pero un día la receta del gazpacho recibe un ingrediente secreto de un pastelero. A partir de ese momento, el sabor recuerda no solo a los ancestros, sino también al vecino. En el modelo estándar de la evolución, los genes se comportan de la misma manera.
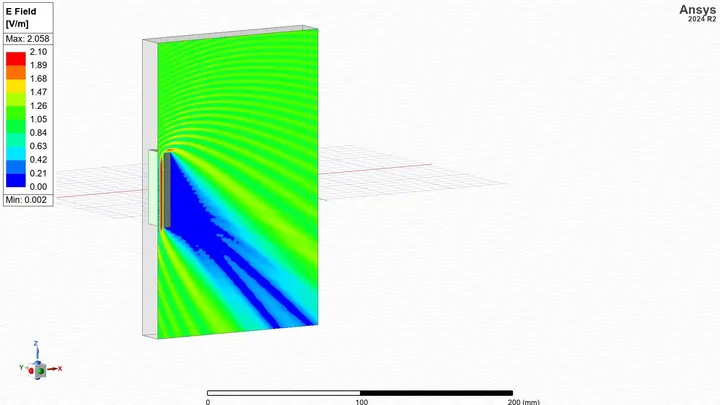
Cuando una onda de radio encuentra un edificio en su camino, no solo se refleja o se absorbe: lo rodea, igual que las olas del mar bordean una roca dejando agua tranquila detrás. En radiofísica, este fenómeno crea una sombra de radio: un patrón complejo de zonas de refuerzo y atenuación de la señal que los científicos llaman retrato de radio.
Los neurochips funcionan de manera distinta a los ordenadores convencionales, construidos según los planos de von Neumann con memoria y procesador separados.
Los asistentes de programación suelen actuar como un cocinero que, para hervir un solo huevo, relee el libro de cocina entero. Al recibir la tarea de hacer una pequeña corrección, vuelven a abrir decenas de archivos y verifican vínculos ya conocidos. Esto es trabajo innecesario: energía que se desperdicia.
Los científicos tomaron 16 actividades cotidianas — desde lavar platos hasta hacer sentadillas — y descompusieron los movimientos en componentes elementales, como un espectroscopio descompone la luz en un espectro. Comparando tres enfoques, encontraron una clave inesperada para el reconocimiento: basta con un fotograma congelado promediado.
Mira el cielo nocturno: no es un puñado de luces, sino un manuscrito de múltiples capas. Bajo la brillante tinta de las estrellas y las galaxias aflora un texto pálido, casi borrado.
La luz fluye como un río invisible. Si colocas un obstáculo en el camino del flujo, el agua se arremolina en remolinos. Así, las superficies especiales crean 'torbellinos' de luz que atrapan nanopartículas como astillas.
Un remolcador espacial con motor iónico acelera lentamente, pero gasta muy poco combustible. Para pasar de una órbita a otra hay que resolver un problema complicado: cuánto tiempo encender el motor y hacia dónde dirigirlo. Normalmente se busca el vuelo más rápido para una masa dada de la nave.
Un médico hojea el historial clínico y ve una línea: «El fármaco reduce el riesgo». Pero, ¿hasta qué punto se puede creer? ¿Se basa la afirmación en un par de casos de la práctica o en decenas de miles de pacientes en un estudio ciego? De la respuesta depende el tratamiento.
El Universo no está en silencio: está lleno de un continuo rumor de ondas gravitacionales. Dentro de una década, el observatorio espacial LISA afinará sus «oídos» al rango de milihercios, y la fuente más rica resultará ser nuestra Galaxia: decenas de miles de pares de enanas blancas girando en una danza…
Un agujero negro no es un vacío congelado, sino un motor magnético vivo. Su 'corazón' — el disco de acreción — palpita: inhalación — la materia se arremolina en un vórtice, exhalación — la reconexión magnética rompe las líneas de campo y el plasma sale disparado lejos del horizonte.
Estamos acostumbrados a pensar que notar solo las confirmaciones de nuestras suposiciones es un error. Pero cálculos recientes, inspirados en el comportamiento de las ondas, le dan la vuelta a esta visión. Resulta que el hábito de buscar lo familiar es la mejor manera de reducir el ruido informativo (los científicos lo llaman entropía).
Fotografiar una telaraña finísima temblando al viento: así es más o menos la tarea de mirar dentro de los vasos de un cerebro vivo. La microscopía de localización ultrasónica (ULM) convierte el ultrasonido ordinario en una herramienta capaz de ver capilares individuales, pero solo si se ajustan los parámetros con mucha precisión.
Una red social se parece a una ciudad: hay barrios gigantes y callejones diminutos. Cuando un algoritmo busca grupos cohesionados, a menudo identifica un par de grupos enormes y muchos fragmentos pequeños. Pero el cliente —por ejemplo, un municipio— necesita barrios de tamaño similar para distribuir uniformemente centros de salud o escuelas.
Una grabación de dictáfono de una plaza urbana. Se oye el murmullo de la multitud, pasos, fragmentos de conversaciones, el ruido de los coches. En algún lugar de esa mezcla de sonidos, un músico callejero toca una melodía simple con una flauta. No es fácil oírla: hay demasiado mezclado.
Una fábrica donde cientos de diminutas líneas de montaje trabajan sin parar. Cada línea es un motor molecular que convierte combustible químico en movimiento. Para que el motor vaya más rápido o en la dirección deseada, el ingeniero cambia los ajustes: la forma de las piezas, la fuerza de las interacciones.
Pruebas un plato en un restaurante, pero no has visto el menú. Le haces preguntas al camarero: ¿está muy salado? ¿qué especias tiene? — y por las respuestas intentas adivinar qué chef lo preparó.
El termostato mantiene la habitación a 20 grados. Abre la ventana en invierno y encenderá la calefacción para recuperar el equilibrio. El cerebro hace algo parecido: predice constantemente lo que ocurrirá en el instante siguiente y se corrige si se equivoca. Así aprende.
Los cálculos cuánticos son una receta con ingredientes perfectos, pero el chef naturaleza cocina a su manera. Los modelos de máquina de los átomos aprenden la receta de memoria y predicen las propiedades de la materia en segundos en lugar de semanas.
Una biblioteca de 27 mil libros, y todos sobre hormigón. En cada uno, la receta de la mezcla, la temperatura, la resistencia. Pero los datos están dispersos en párrafos, tablas y notas al pie. A una persona le llevaría años reunirlos. El programa lo hizo en una hora.
Una película delgada para una batería solar o una pantalla es como una multitud apretada en una plaza: cada persona está girada hacia un lado, y de hacia dónde miran todos depende si la luz atraviesa la multitud o se queda atascada. En la electrónica orgánica, el papel de los transeúntes lo juegan las moléculas.
Una epidemia no es solo un virus, sino también millones de decisiones personales. Una persona sigue viajando en metro, otra se encierra en casa. Los modelos clásicos describen el comportamiento promedio de la multitud, pero no preguntan por qué cada uno actúa así.
Cuando un neutrón o un protón penetra en un núcleo atómico, se comporta como una pelota que golpea una pared irregular: puede rebotar de muchas maneras, dependiendo de dónde impacte.
Una pinza láser es un haz de luz que atrapa y mueve objetos diminutos, como bacterias o motas de polvo. Si hay que llevar una partícula del punto A al punto B, se podría tirar de ella directamente. Pero eso gastaría más energía que una ruta ingeniosa con rodeos.
Una partícula activa es un objeto microscópico que se impulsa a sí mismo, como un nadador diminuto.
Un químico que busca un nuevo fármaco se parece a un cocinero sin receta: tiene una lista de propiedades deseadas, pero millones de ingredientes posibles. Cada prueba cuesta caro y lleva tiempo, así que hay que probar con inteligencia.
El nuevo programa SEISMO actúa como un cocinero que prueba el plato tras cada paso y decide al instante qué añadir después.
Cuando un quark top nace en un detector de partículas, se desintegra inmediatamente en una cascada de otras partículas. Captar en esa cascada un indicio de nueva física es como escuchar un susurro en un concierto de rock. No basta con un buen micrófono: hay que saber restar el estruendo de los amplificadores y el rumor del público.
Los electrones — diminutas partículas en las moléculas — maniobran constantemente, evitando colisiones, como pasajeros en hora pico. Para calcular su comportamiento, los científicos establecen una regla de distancia personal: una función matemática que indica qué tan cerca puede acercarse un electrón a su vecino.
En una sala con 80 asesores, cada uno grita lo suyo, y si simplemente escuchas a todos y tomas el promedio, obtienes un batiburrillo. Lo mismo ocurre con los pronósticos de El Niño: el modelo produce 80 futuros posibles, pero no todos son igualmente útiles. Unos fallan menos, otros más, y otros hablan de algo completamente distinto.