Météo contre climat : comment distinguer le bruit du signal express
En hiver, dans un quartier de la ville, il tombe trois fois plus de neige que dans le quartier voisin. Une année, c'est la canicule, l'autre, le froid. Ce sont les caprices de la météo. Mais sur des décennies, on observe un autre glissement, plus lent : les hivers deviennent en moyenne plus doux. Distinguer l'un de l'autre est la tâche principale des climatologues.
Dans cette nouvelle étude, on propose de calculer combien de fluctuations aléatoires et combien de changement durable se trouvent dans les données de température ou de précipitations. On utilise des modèles informatiques que l'on fait tourner de nombreuses fois avec des conditions initiales légèrement différentes – on obtient ainsi tout un éventail de climats possibles. Ensuite, on compare la dispersion entre ces variantes et le décalage provoqué par une perturbation externe, comme l'augmentation du dioxyde de carbone.
Il s'avère que la nouvelle méthode fonctionne de manière plus fiable que les précédentes, même lorsque les données sont très « dispersées » ou contiennent des valeurs extrêmes rares. L'essentiel est que l'ensemble comporte au moins quarante variantes de calcul. Lorsque la perturbation s'intensifie, la part de hasard diminue, et cela se voit particulièrement nettement.
Un tel outil aide à séparer le bon grain de l'ivraie : comprendre ce qui, dans les prévisions climatiques, est réellement dû à l'activité humaine, et ce qui n'est que variabilité naturelle, comme une chute de neige inattendue en mai.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2608.14455v1
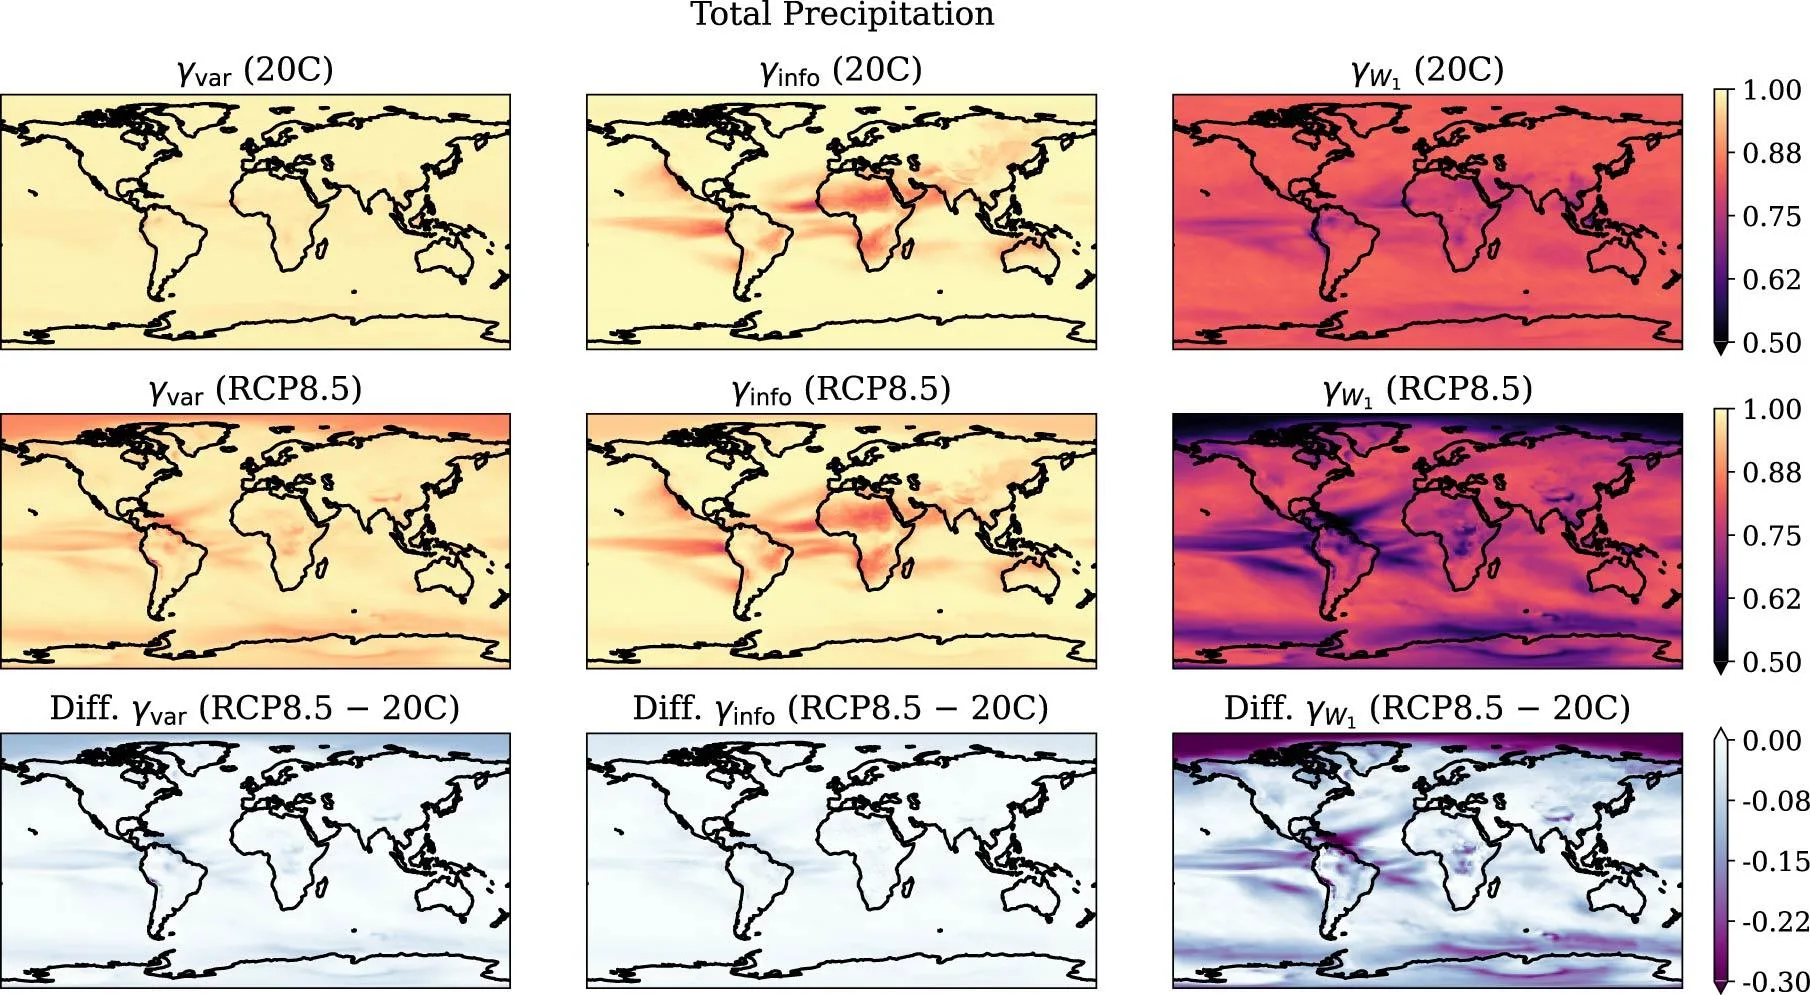
Quantifying forced and internal variability in climate data is fundamental to detecting the climate change signal and assessing uncertainty in climate projections. We propose a metric that quantifies the relative magnitude of internal variability in single-model initial-condition large ensembles (SMILEs). We measure forced and internal variability by two 1-Wasserstein distances, a form of optimal transport cost. The proposed metric is the distance for internal variability divided by the sum of the two. Computing this ratio requires only sorting the samples and differencing the resulting quantiles, with no additional parameters. The metric reflects the entire distribution shape and applies to non-Gaussian variables, because the 1-Wasserstein distance quantifies the difference between any two probability distributions. We validate the metric with synthetic climate data from Gaussian, uniform, and lognormal distributions. Unlike the two existing metrics, the proposed metric gives stable estimates irrespective of the distribution shape and the presence of outliers, provided that the ensemble has about 40 members or more. We then apply the proposed and existing metrics to the 2 m air temperature and total precipitation of the Community Earth System Model Large Ensemble (CESM-LE) under two different forcing scenarios. All the metrics indicate that the relative contribution of internal variability decreases as the forcing increases, but the proposed metric shows this response most clearly. The 1-Wasserstein distance thus provides a simple and useful tool for analyzing large-ensemble datasets.
Dans l'un des scénarios de simulation, le réchauffement était si fort que les fluctuations aléatoires de température ont presque cessé d'influencer la tendance générale – le signal du changement climatique est devenu évident.