L'erreur standard est une mesure de la précision avec laquelle vous connaissez une quantité estimée, telle que la moyenne d'un ensemble de données. Ce n'est pas la dispersion des points de données individuels (c'est l'écart type), mais plutôt l'incertitude de l'estimation elle-même. Si vous preniez à plusieurs reprises de nouveaux échantillons et calculiez la moyenne à chaque fois, l'erreur standard vous indique à quel point ces moyennes varieraient. C'est l'écart type de la distribution d'échantillonnage de la statistique.
Histoire
Le concept a été formalisé par le statisticien britannique Ronald Fisher dans les années 1920, qui a introduit le terme « erreur standard » pour le distinguer de l'écart type des données elles-mêmes.
Comment ça marche
L'erreur standard est calculée en prenant l'écart type des données et en le divisant par la racine carrée de la taille de l'échantillon (ES = σ/√N). Cette formule découle du fait que la moyenne de nombreuses mesures indépendantes réduit le bruit aléatoire. Plus vous avez de données, plus la distribution des moyennes possibles devient étroite, donc l'erreur standard diminue. C'est le nombre clé pour construire des intervalles de confiance et effectuer des tests d'hypothèse.
En pratique
Elle est utilisée dans tous les domaines scientifiques qui rapportent des moyennes — des essais cliniques (les barres d'erreur sur l'efficacité des médicaments) à l'économie (l'incertitude dans les estimations du taux de chômage).
Anecdote
L'erreur standard de la moyenne est toujours plus petite que l'écart type des données, ce qui explique pourquoi le calcul de la moyenne est un outil si puissant pour réduire le bruit.
L'orchestre joue sans chef. Chaque instrument entre selon son propre calendrier : le violon le lundi, la flûte le mercredi, les timbales le samedi. Les astronomes n'entendent pas la musique, mais des notes isolées, éparpillées sur le calendrier. Le télescope ne voit l'étoile que lorsqu'elle est au-dessus de l'horizon et que le calendrier lui a accordé du temps.
Dans les années 1980, le concours DARPA de reconnaissance vocale a mis fin au débat entre les méthodes statistiques et les règles écrites à la main, établissant une norme unique pour tout le domaine.
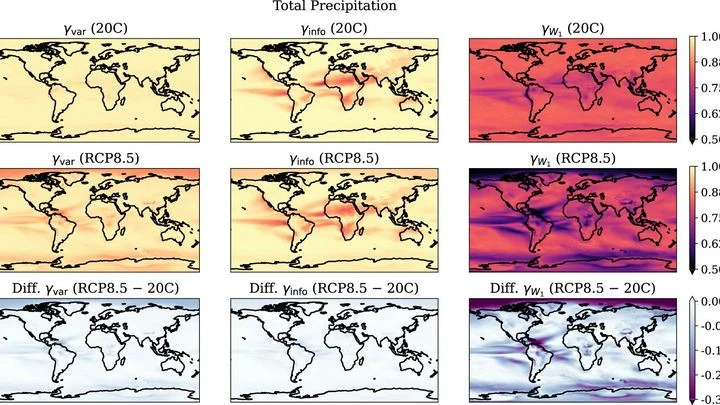
En hiver, dans un quartier de la ville, il tombe trois fois plus de neige que dans le quartier voisin. Une année, c'est la canicule, l'autre, le froid. Ce sont les caprices de la météo. Mais sur des décennies, on observe un autre glissement, plus lent : les hivers deviennent en moyenne plus doux. Distinguer l'un de l'autre est la tâche principale des climatologues.
En tournant lentement le bouton de réglage d'un vieux poste de radio, vous entendez le son émerger du bruit non pas progressivement, mais par un saut brusque, au moment où l'antenne entre en résonance avec l'onde. C'est à peu près ainsi que se comportent les gènes dans une cellule vivante.
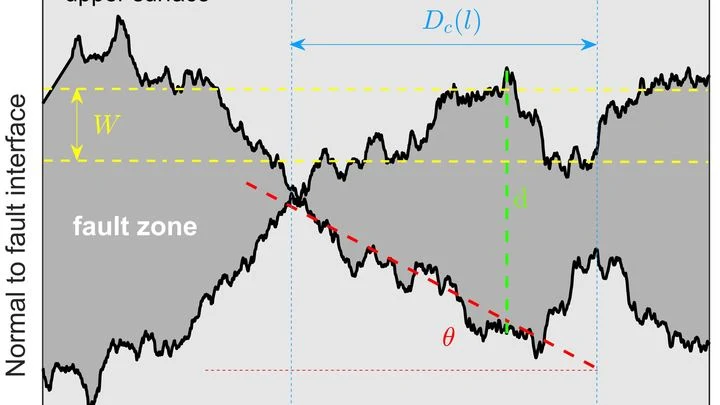
Deux morceaux de papier de verre pressés l'un contre l'autre. Dès qu'on les fait glisser, ils s'accrochent d'abord par leurs aspérités, puis glissent brusquement. C'est à peu près ainsi que se comporte une faille terrestre lors d'un séisme. Mais il y a un détail important : de combien faut-il déplacer les bords pour que l'adhérence cède ? Cette distance est appelée glissement critique.
Un système stable fonctionne comme une balle dans un bol : une poussée, et elle roule vers le fond. L'éventail des trajectoires possibles — l'incertitude — se resserre avec le temps. Mais la vitesse dépend de l'inclinaison des parois. Pour les systèmes complexes, ce « bol » présente des zones de pentes différentes.
Quand on entreprend des travaux, on n'achète pas la peinture au jugé, mais en fonction de la surface des murs. En science, le calcul du nombre d'échantillons est une estimation similaire, mais les enjeux sont plus élevés. En dessous du compte, l'étude devient une loterie : on peut passer à côté d'un effet réel, ou prendre du bruit pour une découverte.
Une pierre tombe dans un étang – et les ondulations à la surface racontent longtemps où elle a coulé. Avec un trou noir, il semblerait que ce soit différent : tout ce qui franchit l'horizon (la frontière au-delà de laquelle même la lumière ne peut s'échapper) disparaît sans laisser de trace.
Dans un orchestre où chaque musicien joue la même note, le son se fond en un puissant unisson. C'est ainsi que naît le condensat de Bose-Einstein : une multitude de particules bosoniques, à température extrêmement basse, se comportent comme un tout.
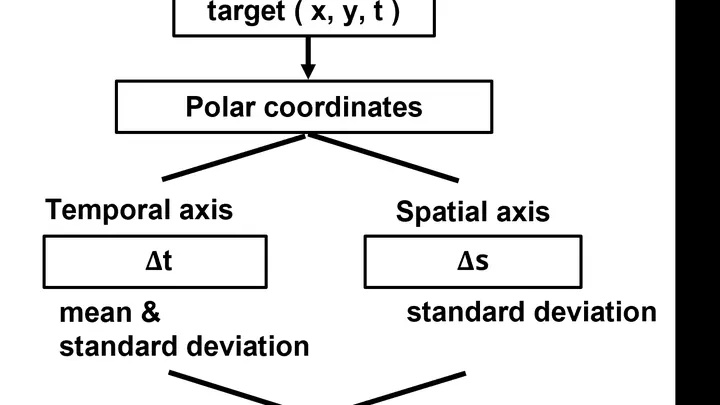
Les yeux suivent un point qui trace doucement une courbe complexe sur l'écran. Chez la plupart des gens, le regard reste proche de ce point, mais chez certains, il semble glisser ou accuser un retard. Autrefois, ces particularités se noyaient dans les moyennes : si l'on additionne tout le monde et que l'on divise, la différence disparaît presque.
L'Univers a longtemps été considéré comme un cuisinier strict : on pensait que dans chaque recoin, les étoiles étaient mélangées selon une seule recette — pour chaque étoile géante, on trouvait à peu près le même nombre de naines, peu importe où elles étaient nées.
L'eau qui tourbillonne dans un entonnoir finit par perdre sa surface lisse : apparaissent alors de l'écume et des éclaboussures. Les mathématiciens décrivent ces écoulements par des équations, mais celles-ci cachent un mystère — parfois la solution « explose », devient infinie, et personne ne sait pourquoi.
Une étoile à neutrons est une boule de la taille d'une ville, mais elle pèse autant qu'une fois et demie le Soleil. À l'intérieur d'une telle boule, la matière est si comprimée qu'une cuillère à café pèserait des milliards de tonnes. Mais de quoi est exactement faite cette matière, les physiciens ne le savent pas encore.