La taille de l'échantillon est le nombre d'observations individuelles, de participants ou de points de données inclus dans une étude. C'est un paramètre fondamental en statistique car il influence directement la précision des estimations et la puissance des tests d'hypothèses. Une taille d'échantillon plus grande réduit généralement l'erreur d'échantillonnage, rendant les résultats plus fiables et plus susceptibles de refléter l'effet réel de la population, tandis qu'une taille plus petite augmente le risque de manquer des effets réels ou d'en produire de fallacieux.
Histoire
Le concept formel de la taille de l'échantillon et de son rôle dans l'inférence s'est développé au début du XXe siècle, notamment grâce aux travaux de Ronald Fisher dans les années 1920 et 1930, qui a établi le cadre de la conception expérimentale et des tests d'hypothèses.
Comment ça marche
L'inférence statistique repose sur l'idée qu'un échantillon se rapproche de la population dont il est tiré. L'erreur type d'une estimation diminue à mesure que la racine carrée de la taille de l'échantillon augmente, de sorte que doubler la taille de l'échantillon réduit approximativement de moitié la marge d'erreur. L'analyse de puissance, qui détermine la taille minimale de l'échantillon nécessaire pour détecter un effet d'une taille donnée, équilibre le niveau de signification souhaité, la taille de l'effet et la puissance statistique.
En pratique
Les calculs de taille d'échantillon sont courants dans les essais cliniques, les enquêtes en sciences sociales et le contrôle qualité pour garantir que les études ne soient ni sous-dimensionnées ni inutilement vastes.
Anecdote
Dans certains domaines, le problème du « p-hacking » — où les chercheurs collectent des données jusqu'à ce que les résultats deviennent significatifs — exploite le fait qu'augmenter la taille de l'échantillon peut transformer un résultat non significatif en un résultat significatif, même lorsque l'effet réel est nul.
Un orchestre de trente-six instruments joue presque à l'unisson. Le chef d'orchestre tente de discerner quelle voix mène la mélodie, mais les sons se confondent, et chaque mesure suivante n'ajoute que du doute.
Un poisson solitaire voit une ombre au-dessus de sa tête. Fuir ? Si ce n'est qu'une feuille, il aura gaspillé son énergie et se sera révélé à un prédateur. Si c'est un héron, l'hésitation est mortelle. C'est le compromis éternel de l'individu isolé : réagir vite signifie beaucoup de fausses alertes, être prudent signifie risquer de se faire dévorer.
Dans un banc, c'est différent.
En hiver, dans un quartier de la ville, il tombe trois fois plus de neige que dans le quartier voisin. Une année, c'est la canicule, l'autre, le froid. Ce sont les caprices de la météo. Mais sur des décennies, on observe un autre glissement, plus lent : les hivers deviennent en moyenne plus doux. Distinguer l'un de l'autre est la tâche principale des climatologues.
Un flacon de parfum n'est pas simplement du verre avec un liquide. C'est une empreinte du temps, une mélodie figée composée de notes odorantes. De 1900 à 2024, des dizaines de milliers de ces « mélodies » se sont accumulées, et on peut désormais les étudier comme un organisme unique.
D'habitude, la complexité des systèmes — du mouvement des satellites aux rythmes cardiaques — est évaluée par l'entropie moyenne (une mesure de l'imprévisibilité, telle que la concevait Ludwig Boltzmann).
Les modèles habituels considèrent que l'infection ressemble à un flux d'eau uniforme qui baigne tout le monde de la même manière. En réalité, le malade émet un flux variable : après l'infection, il suinte à peine, puis se transforme en pluie torrentielle, et enfin s'apaise.
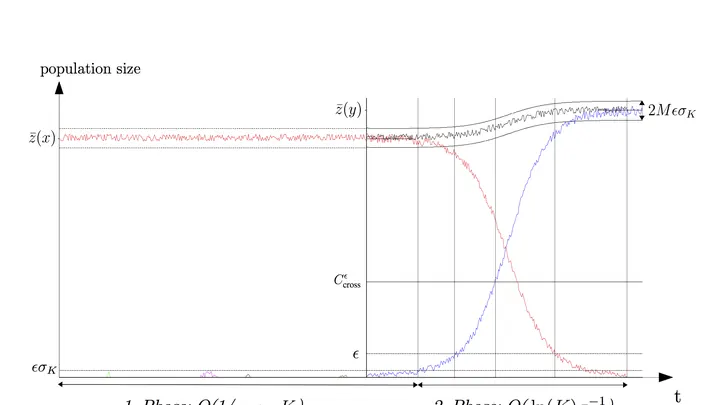
L'évolution coule comme l'eau. Dans une large rivière, les changements sont lents et progressifs, tandis qu'un torrent de montagne bouillonne à chaque pierre. La taille de la population et la fréquence des mutations tracent le lit : large et calme, ou étroit et plein de rapides.
Imaginez un bal dans une salle inconnue : deux invités partent de coins opposés. Leurs mouvements ne sont pas une valse gracieuse, mais une improvisation chaotique à la recherche de trésors rares. Contrairement à l'intuition, ce n'est pas le rythme qui décidera de l'issue, mais la géométrie du parquet.
Les cent vingt habitants de Montelago ne sont pas des personnes, mais des personnages numériques. Chacun, en plus de son nom et de sa biographie, possède trois coordonnées cachées : la confiance envers les autorités municipales, l'évaluation de la fiabilité de la source, la pertinence perçue de l'information.
Quand on entreprend des travaux, on n'achète pas la peinture au jugé, mais en fonction de la surface des murs. En science, le calcul du nombre d'échantillons est une estimation similaire, mais les enjeux sont plus élevés. En dessous du compte, l'étude devient une loterie : on peut passer à côté d'un effet réel, ou prendre du bruit pour une découverte.
En 1948, l'ingénieur Claude Shannon a posé les fondations de la théorie de l'information. Le théorème de Nyquist-Shannon a apporté une première réponse : pour ne pas perdre le signal, il faut effectuer deux fois plus de mesures que sa composante la plus rapide. En 2006, la méthode du sondage compressé (compressed sensing) a assoupli cette exigence.
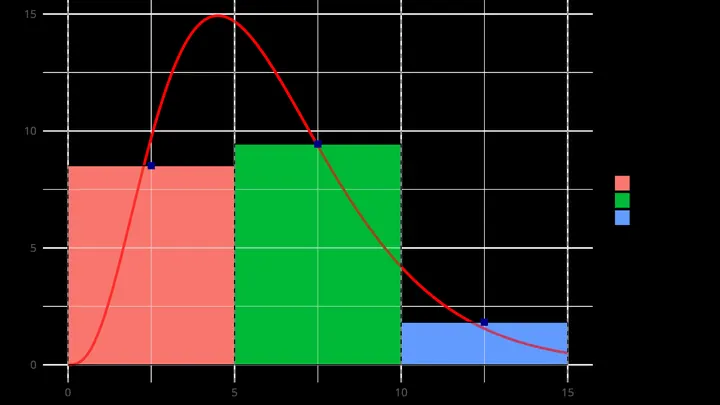
Étalons une poignée de pièces sur une table. Chaque pièce représente un résultat possible : pile, face, ou autre chose. Si l'on connaît le degré de chaos de cet ensemble (son entropie), quelles combinaisons de probabilités rencontrera-t-on le plus souvent ? Il s'avère que la réponse dépend de la quantité de chaos que l'on autorise.
De minuscules aimants sur un réseau — le modèle d'Ising classique — décrivent généralement comment les voisins s'influencent mutuellement. Mais que se passe-t-il lorsque le système est étroitement surveillé ? Chaque mesure de l'énergie de liaison est comme un regard qui force les aimants à « se décider » sur leur état.
La main repose sur la table, et deux courtes vibrations arrivent au poignet, l'une après l'autre. Il faut dire laquelle est la plus forte. La tâche semble simple, mais la réponse dépend de la vibration qui vient en premier. Si la première est faible et la seconde forte, la différence paraît plus grande que lorsqu'on les inverse.
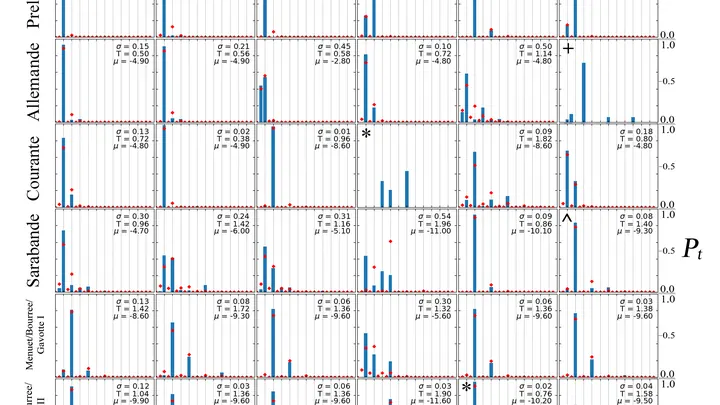
La musique repose sur la répétition : nous attendons que l'accent revienne, comme le refrain revient. Mais si l'on répète trop longtemps la même chose, l'ennui s'installe. Le compositeur semble marcher sur un fil tendu entre le familier et l'inattendu.
Les scientifiques ont traduit cet équilibre dans le langage de la physique.
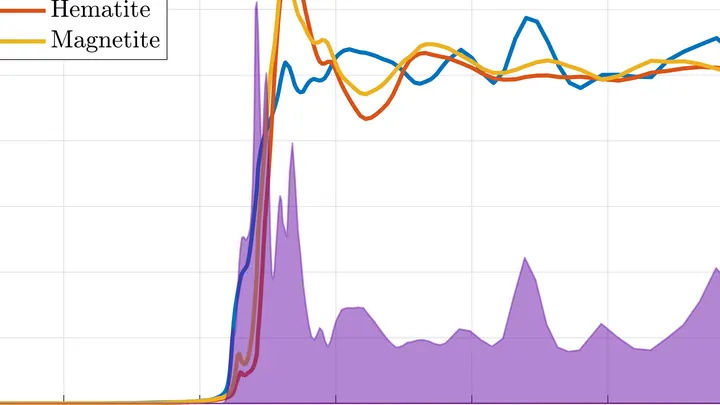
La carte chimique d'un échantillon ressemble à une mosaïque : chaque point a sa propre couleur, sa propre composition chimique. Pour assembler une telle mosaïque, le spectromicroscope scanne l'échantillon point par point, enregistrant en chaque point un spectre — une « empreinte » de la manière dont la matière absorbe ou émet la lumière.
Un chimiste à la recherche d'un nouveau médicament ressemble à un cuisinier sans recette : il a une liste de propriétés souhaitées, mais des millions d'ingrédients possibles. Chaque essai coûte cher et prend du temps, il faut donc procéder avec méthode.
Le nouveau programme SEISMO agit comme un cuisinier qui goûte le plat après chaque étape et décide aussitôt quoi ajouter ensuite.
Le diagnostic génétique, c'est un peu comme comparer deux photos prises avec des appareils différents. Si l'un des appareils a légèrement décalé les couleurs, la photo révèle des « défauts » qui n'existent pas dans la réalité.