FPGA acelera el cielo radioeléctrico: síntesis directa de imágenes para conjuntos de antenas gigantes ✛
Contexto
La radioastronomía moderna está experimentando una explosión de descubrimientos de transitorios rápidos: desde ráfagas de radio de milisegundos hasta los destellos posteriores de estallidos de rayos gamma. Para capturar estos fenómenos se necesitan instrumentos con un enorme campo de visión y reacción instantánea. Los conjuntos de apertura formados por miles de antenas pequeñas proporcionan ese campo, pero generan una avalancha de datos. Los correlacionadores clásicos, que calculan todas las correlaciones por pares de las señales, requieren O(N²) operaciones, lo que para N en decenas de miles se vuelve inmanejable. Junto a este trabajo, en el archivo hay investigaciones sobre algoritmos cuánticos y sistemas cuánticos complejos, pero este artículo se destaca: resuelve un problema de ingeniería en tiempo real para radiotelescopios terrestres. La síntesis directa de imágenes mediante la transformada de Fourier espacial promete un escalado O(N log N), y las primeras implementaciones en GPU ya han mostrado una aceleración de dos órdenes de magnitud, pero chocan con el ancho de banda de la memoria. El paso a FPGA elimina esta limitación.
Métodos
Los autores construyen un prototipo en la tarjeta comercial AMD Alveo V80 con 32 GB de memoria HBM2e y cuatro interfaces de 200 GbE. En la tarjeta se cargan los voltajes complejos calibrados de los elementos del conjunto de antenas. El núcleo EPIC realiza tres pasos: gridding (interpolación de los voltajes en una cuadrícula regular con un paso menor que media longitud de onda), la transformada rápida de Fourier bidimensional y la elevación al cuadrado píxel a píxel para obtener imágenes de polarización. Para la verificación se crearon datos sintéticos según la disposición de la estación AAVS2 (prototipo de SKA-Low) a una frecuencia de 159 MHz: tres fuentes constantes y un transitorio, cada uno con su propia aleatoriedad, sin ruido térmico. Los voltajes se digitalizaron con 8 bits para las partes real e imaginaria. La simulación en AMD Vivado confirmó la corrección de los tiempos y la FFT.
Resultados
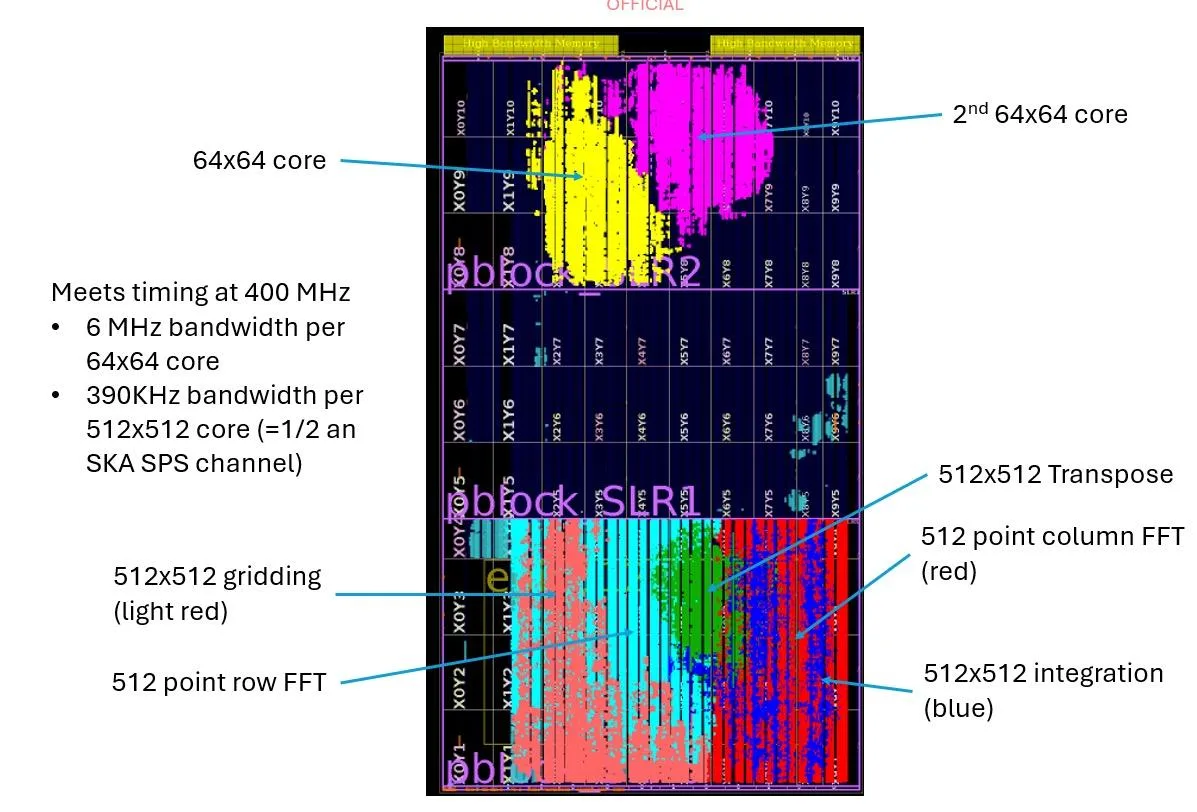
El prototipo genera cuadros de 64×64 píxeles con una cadencia de 5,12 microsegundos: cada cuadro se acumula a partir de cuatro intervalos de 1,28 microsegundos con un ancho de canal de 780 kHz. Las imágenes de salida recuperan todas las fuentes en sus posiciones correctas, incluido el transitorio inyectado. La estimación de recursos muestra que un núcleo de 64×64 procesa aproximadamente 6 MHz de ancho de banda, y en una sola tarjeta caben ocho de estos núcleos, lo que da un total de 50 MHz. Alternativamente, un núcleo de 512×512 procesa un canal grueso de 780 kHz. La tarjeta puede manejar un conjunto de aproximadamente 20 000 elementos con dos polarizaciones, lo que equivale a 20–30 estaciones del núcleo de SKA-Low. En comparación con la implementación en GPU en LWA-Sevilleta, que producía cuadros cada 80 ms con un ancho de banda de 19,2 MHz, el nuevo enfoque gana en ancho de banda por un factor de varios y potencialmente por un orden de magnitud en el tamaño del conjunto, la resolución temporal y el tamaño de la imagen.
Implicaciones
Este trabajo traslada el método de síntesis directa de imágenes de las GPU a la lógica programable, donde las FFT de baja precisión se ejecutan en paralelo y con menor consumo de energía. A diferencia de los trabajos vecinos sobre algoritmos cuánticos, que exploran límites teóricos, aquí se aborda un problema práctico de escalado para telescopios en construcción. No es solo una aceleración, sino un cambio de paradigma arquitectónico: en lugar de almacenar correlaciones, se calcula directamente la imagen, lo que reduce drásticamente los requisitos de memoria y ancho de banda. Para SKA-Low, donde un correlacionador y formador de haces ya utiliza las mismas tarjetas Alveo V80, el enfoque propuesto abre el camino hacia la unificación del procesamiento.
Desarrollo futuro
El siguiente paso es probar el prototipo con datos reales de la estación AAVS2 en funcionamiento en el Observatorio de Murchison. Será necesario integrar el sistema de calibración y resolver los problemas de entrada/salida en la transmisión por flujo. En el futuro, la arquitectura podría escalar a imágenes de aproximadamente un megapíxel y conjuntos de decenas de miles de elementos, si se optimizan la precisión y la distribución de la memoria. Es posible combinar varias tarjetas para procesar anchos de banda más amplios o crear mosaicos de varios campos de visión.
Impacto
La tecnología afectará directamente a los estudios radioastronómicos del cielo: SKA-Low, MWA, LOFAR y futuros instrumentos como HIRAX podrán realizar un monitoreo continuo de todo el cielo con resolución temporal de milisegundos. Esto también acelerará la búsqueda de ráfagas de radio rápidas y de contrapartidas electromagnéticas de eventos de ondas gravitacionales.
Próximos pasos
La tarea más cercana es poner en marcha el prototipo con el flujo de datos real de AAVS2 y comparar la sensibilidad con el correlacionador tradicional. Luego, se optimizará la precisión para reducir el consumo de energía y se probará en una estación SKA-Low a gran escala.
Problemas abiertos clave
Para la radioastronomía, el problema clave no resuelto es el procesamiento en tiempo real de datos de conjuntos con más de diez mil elementos sin pérdida de sensibilidad. Este trabajo propone una vía concreta, pero quedan abiertas las cuestiones de la precisión del gridding para disposiciones arbitrarias de antenas y el efecto de la baja precisión en el rango dinámico de las imágenes.
La mirada de la máquina del conocimiento
Esta sección está dirigida al autor del trabajo y a sus colegas. Los trabajos vecinos los encontró la búsqueda por significado en nuestro archivo, no por coincidencia de palabras. No evaluamos: mostramos el campo alrededor.
Qué hace el trabajo
Los autores implementaron el método de síntesis directa de imágenes (EPIC) en una FPGA AMD Alveo V80, utilizando gridding, FFT bidimensional y elevación al cuadrado píxel a píxel. El prototipo procesa datos de una estación de 256 elementos de SKA-Low, generando imágenes de 64×64 píxeles cada 5,12 microsegundos. Las estimaciones muestran que una sola tarjeta puede atender hasta 20 000 antenas, lo que supera en un orden de magnitud a las soluciones basadas en GPU.
Dónde está su fuerza
Trasladar EPIC a una FPGA elimina la limitación de ancho de banda de memoria típica de las GPU y demuestra escalabilidad a grandes conjuntos de antenas con alta cadencia y bajo consumo energético.
Hacia dónde puede avanzar
- Podría ser interesante ver cómo los enfoques de PhySR que combinan modelos físicos con redes neuronales pueden complementar la síntesis directa de imágenes: por ejemplo, usar modelos entrenados para mejorar la calidad de reconstrucción o acelerar el procesamiento.se apoya en: PhySR: la física ayuda a la red neuronal a ver en el radioespectro arXiv:2607.27750v1
- Existe un trabajo relacionado sobre síntesis directa de imágenes en GPU con un tiempo de síntesis de 14 segundos; compararlo con este podría ayudar a identificar vías para optimizar la precisión y los recursos al migrar a FPGA.se apoya en: 14 segundos para tejer una estrella: la síntesis directa regresa arXiv:2607.24141v1
- En el archivo hay una investigación sobre calibración de grandes conjuntos de antenas mediante un robot; integrar métodos de calibración similares con la implementación de EPIC en FPGA podría aumentar la precisión de las imágenes generadas.se apoya en: Cómo un robot enfocó 5000 ojos de radio arXiv:2604.17448
Vale la pena probar
- Probar el uso de FFT de baja precisión con coma flotante en bloques para mejorar la exactitud sin aumentar significativamente los recursos.
- Verificar la posibilidad de redistribuir dinámicamente los recursos entre los núcleos para adaptarse a diferentes anchos de banda y tamaños de imagen.
- Considerar la integración con métodos de aprendizaje automático para suprimir artefactos y mejorar el rango dinámico en tiempo real.
Por qué puede importar
La implementación de EPIC en FPGA abre el camino a sistemas de procesamiento de datos económicos y energéticamente eficientes para conjuntos de antenas gigantes, algo crítico para futuros proyectos como SKA y para la captura de ráfagas rápidas de radio.
Trabajos cercanos en nuestro archivo
- Luz en lugar de cables: un chip fotónico que calcula más rápidocercanía 0.56
- Red neuronal al oído: cómo capturar la energía de una partículacercanía 0.52
- 14 segundos para tejer una estrella: la síntesis directa regresacercanía 0.51
- Director digital de ondas gravitacionales: una red neuronal dirige las fusiones de agujeros negroscercanía 0.51
- PhySR: la física ayuda a la red neuronal a ver en el radioespectrocercanía 0.51
- La antena crece en volumencercanía 0.50
- Cómo un robot enfocó 5000 ojos de radiocercanía 0.49
El archivo está vacío alrededor de este trabajo: el análisis más cercano queda en 0.56, frente a un 0.64 habitual. Parece que aquí al lado casi nadie ha perforado.
La tarjeta AMD Alveo V80 utilizada en el prototipo es idéntica a la que ya está en el correlacionador y formador de haces de SKA-Low. Es decir, el mismo acelerador puede calcular correlaciones y construir imágenes directamente.
La idea de 'fotografiar' instantáneamente todo el cielo recuerda al sistema de monitoreo en la novela 'Contacto' de Carl Sagan, donde un conjunto de radiotelescopios escanea continuamente el cielo en busca de señales. Solo que aquí, en lugar de buscar inteligencia extraterrestre, se cazan explosiones cósmicas rápidas.
Cifras clave
- cadencia de cuadros: 5,12 microsegundos por cuadro (195 000 cuadros por segundo)
- tamaño de imagen: 64×64 píxeles en el prototipo, hasta 512×512 en la versión extendida
- número de elementos: 256 en el prototipo, hasta 20 000 en una sola tarjeta
- ancho de banda procesado: 50 MHz por tarjeta para 64×64, 780 kHz para 512×512
- aceleración frente a GPU: varias veces en ancho de banda, hasta un orden de magnitud en tamaño del conjunto