Сжатие данных — это искусство и наука представления информации меньшим числом бит, чем в оригинале. Это основополагающая технология цифровой эпохи, обеспечивающая всё — от потокового видео до хранения геномов. Основная идея заключается в использовании избыточности: большинство реальных данных содержат закономерности, повторения или статистические регулярности, которые можно описать более компактно, чем сами исходные данные. Алгоритмы сжатия находят эти закономерности и кодируют их, позволяя восстановить исходную информацию (без потерь) или приближенно (с потерями) из сжатой формы.
История
Эта область началась с работы Клода Шеннона 1948 года «Математическая теория связи», которая заложила основы теории информации и ввела понятие энтропии как меры информации. За ней последовали ранние практические алгоритмы, такие как кодирование Хаффмана (1952) и Лемпеля-Зива (1977).
Как это работает
Сжатие работает путем моделирования структуры данных. Методы без потерь, такие как кодирование Хаффмана или LZ77, строят словарь часто встречающихся символов или фраз и заменяют их более короткими кодами. Методы с потерями, такие как JPEG или MP3, отбрасывают информацию, к которой человеческий глаз или ухо нечувствительны, используя преобразования (например, дискретное косинусное преобразование) для концентрации энергии в нескольких коэффициентах. В физике и обработке сигналов сжатие часто связано с теорией информации: минимальное число бит, необходимое для описания сигнала, — это его энтропия, и сжатие приближается к этому пределу, устраняя статистическуюизбыточность.
Где применяется
Сжатие данных используется практически во всех цифровых средах: форматы изображений (JPEG, PNG), аудио (MP3, FLAC), видео (H.264) и архиваторы файлов (ZIP). В научных исследованиях оно обеспечивает эффективное хранение и передачу огромных наборов данных, например, от ускорителей частиц или секвенаторов генома.
Любопытный факт
«Zip-бомба» — это сжатый файл, предназначенный для распаковки в огромный размер, что использует тот факт, что высокоповторяющиеся данные можно сжать почти до нуля.
Рентгеновская вспышка проносится сквозь вещество за миллиардные доли секунды. Чтобы её запомнить, физики заставляют атомы на короткое время впитать этот свет, а потом выпустить обратно. Но достать фотон по команде — всё равно что вытащить из шкафа нужную книгу, когда полки двигаются сами по себе.
В трёхмерной сцене каждая точка подобна конфете с переливающейся обёрткой: её цвет меняется в зависимости от угла зрения. Чтобы описать эту игру оттенков, для каждой точки хранят десятки чисел — специальную математическую функцию, разложение в ряд, предложенное ещё Жозефом Фурье.
Обычная дорожная карта с данными о трафике — это колоссальный массив чисел. Передавать их в исходном виде слишком накладно. Но объём можно радикально сократить, не теряя значимой информации. Исследователи предложили изящный подход: сначала выполняется преобразование графа — улицы становятся вершинами (точками), а перекрёстки — рёбрами (перемычками) между ними.
Трёхмерные миры состоят из миллионов полупрозрачных пятнышек — как гигантский гобелен, сотканный из светящихся капель. Чтобы передать такое полотно, обычно требуется много времени и мощный канал связи. SpeedyGS умещает его в крохотный файл, и оно разворачивается мгновенно, словно выдёргиваешь шнурок из мешка.
Обучение масштабной нейросети на сотнях вычислительных узлов напоминает коллективное приготовление супа: каждый «повар» пробует блюдо и сообщает остальным свои корректировки.
В 1948 году инженер Клод Шеннон заложил основы теории информации. Теорема Найквиста–Шеннона дала первый ответ: чтобы не потерять сигнал, измерений должно быть вдвое больше, чем самая быстрая его деталь. В 2006 году метод сжатого зондирования (compressed sensing) ослабил это требование.
Классический компьютер сортирует данные подобно человеку, методично перебирающему песчинки разного цвета — одну за другой. Квантовый процессор действует иначе, заимствуя принцип у природы: подобно тому как капля воды разлагает солнечный свет на радугу, демонстрируя весь спектр оттенков одновременно, новый алгоритм мгновенно схватывает суть гигантских массивов информации.
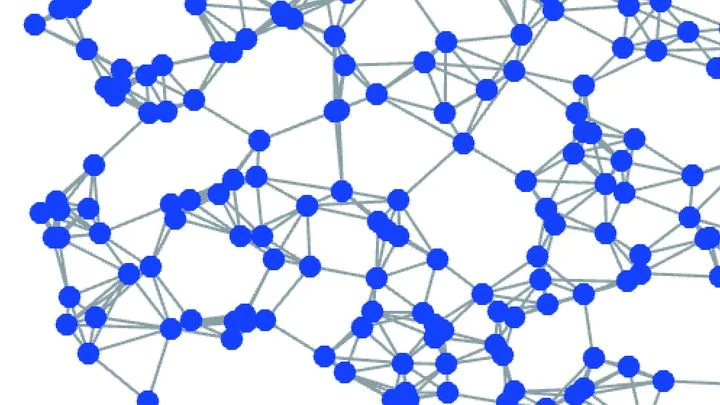
Густая сеть знакомств: каждый связан почти с каждым, и в этой паутине трудно понять, кто действительно важен. Слишком много нитей — компьютер задыхается, моделирование буксует. Учёные придумали, как прореживать такие сети, не теряя главного.
Идея в том, чтобы убирать связи, которые не участвуют в кратчайших путях.
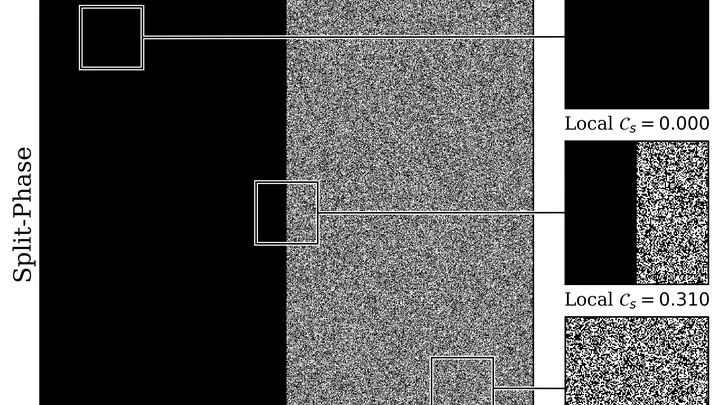
Магнитная плёнка, разбитая на крошечные ячейки-стрелки, ведёт себя как толпа на площади. Пока холодно, все стрелки смотрят в одну сторону — идеальный порядок. Нагрейте плёнку, и стрелки начнут метаться, как прохожие, потерявшие цель. Где-то между этими крайностями есть момент, когда система перестаёт быть однородной, но ещё не рассыпается в случайный шум.
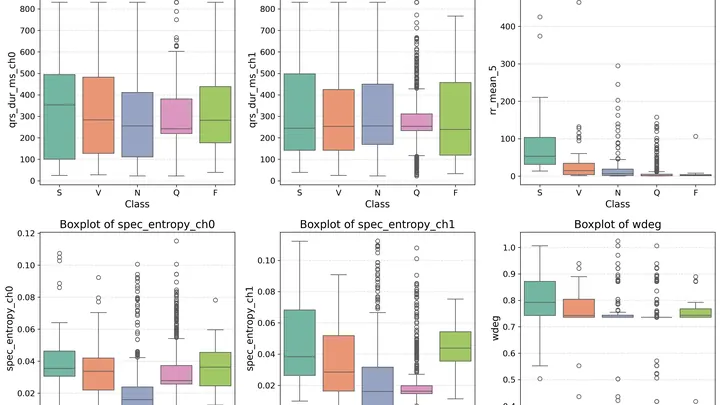
Электрокардиограмма похожа на партитуру, где каждая нота — удар сердца. Врач слышит мелодию и замечает фальшивые ноты — аритмию. Но слушать партитуру часами утомительно, поэтому у кровати больного ставят умный датчик.