معالجة الصوت والكلام eess.AS

23 مقالات

مقالات

كيف تتعلم الآلة تمييز أصوات الكلام
المعلمة في الفصل تشرح الفرق بين «دوم» و«توم»: ضع يدك على حلقك واستشعر الاهتزاز. الآلة التي تتعرف على الكلام تفعل الشيء نفسه تقريبًا، لكن بدل الحلق، يوجد بداخلها قوائم طويلة من الأرقام. واتضح أن هذه الأرقام يمكن ترتيبها على رفوف — مثل مكعبات الحروف في غرفة الأطفال. أخذ العلماء نموذجًا دُرِّب على 96 لغة، ووجدوا بداخله اتجاهات مسؤولة عن خصائص معينة للأصوات. على سبيل المثال، هناك اتجاه «الجهر».
الصوت2026-03-071 دarXiv:2603.07215سريع
سماعة طبية تسمع الأمعاء
الأمعاء تتحدث مع الطبيب، ولكن بصوت خافت جدًا. أصوات القرقرة والفقاعات تستمر لأجزاء من الثانية وتضيع بسهولة بين أصوات الرئتين والقلب. السماعة الطبية تلتقط جزءًا صغيرًا فقط، لذا يعتمد التشخيص على خبرة وسمع الطبيب نفسه. المستشعر القابل للارتداء SonicGuard، المثبت على البطن، يستمع بشكل مستمر ويسجل كل حفيف. ثم يأتي دور الخوارزمية.
الإخفاء الصوتي: عندما يستبدل الصوت الواقع
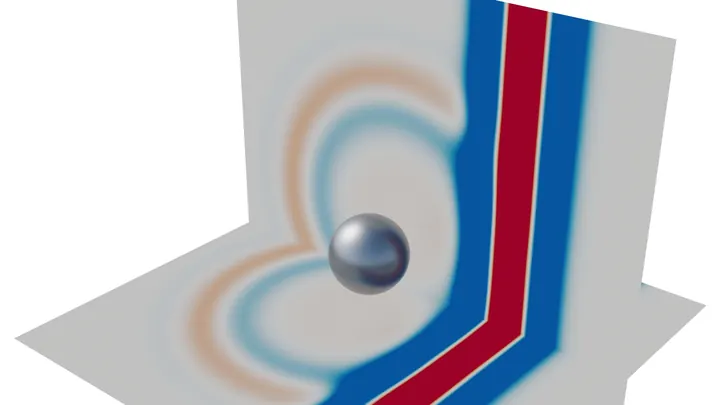
إذا صفّقت بيديك في غرفة فارغة، سيخبرك الصدى عن أبعادها وشكلها. كل جسم — كرسي، كتاب، إنسان — يضيف بصمته الخاصة إلى هذا الصدى: فالصوت ينعكس عنه بطريقة مميزة. ابتكر مؤلفو المقال طريقة لإعادة كتابة هذه البصمة الصوتية بالكامل. فقد أحاطوا منطقة من الفضاء بسطح مغلق من الميكروفونات ومكبرات الصوت. تلتقط الميكروفونات الصوت القادم، وترد مكبرات الصوت فورًا بإشارة تجعل الداخل صامتًا — وكأن لا شيء هناك. تقوم الفكرة على أساس بسيط.
هوائي كروي: كيف توقفت الميكروفونات عن الخطأ
الميكروفون العادي ذو النمط القلبي (cardioid) — وهو جهاز بنمط اتجاهي يشبه القلب — يشبه الأذن البشرية، حيث يتمتع بأقصى حساسية من الأمام، لكن قراءاته تتشوه عند سقوط الصوت من الجانب. الحل الذي اقترحه المهندسون يتمثل في تجميع عدة من هذه "الآذان" في كرة — مما ينشئ مصفوفة مكانية تسجل الإشارة الصوتية من جميع الاتجاهات في وقت واحد.
الشك يفضحه الصمت: الذكاء الاصطناعي يقرأ التوقفات
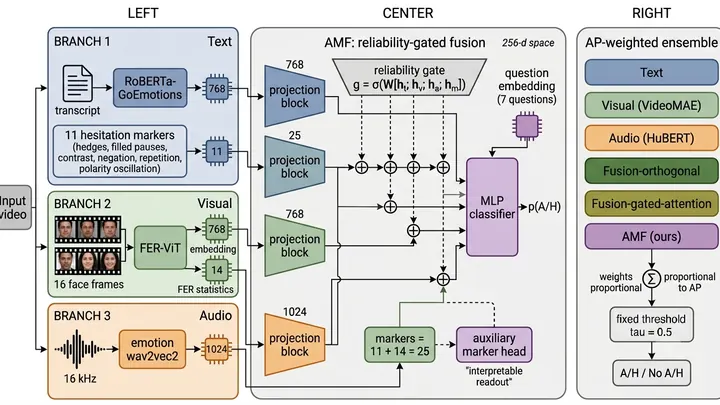
يقوم نظام جديد بتحليل مقابلة قصيرة للتعرف على شكوك الشخص، من خلال دمج النص والصوت وتعابير الوجه. لكن المفتاح الرئيسي لعدم اليقين كان المادة المظلمة للكلام - التوقفات وكلمات الحشو التي تُمحى من أنظمة الكلام القياسية كما يمحو الثقب الأسود كل شيء. هذه الفجوات، التي تُعتبر عادةً نفايات، قدّمت الإشارة غير اللفظية الأكثر استقلالية.
صوت نقي: لماذا الجهارة أهم من الطور
تنظيف الكلام من الضوضاء يشبه محاولة ضبط تلفاز قديم: بمجرد أن تُفرط في تدوير مقبض التباين، تصبح الوجوه غير طبيعية. تمكن الباحثون من ضبط «الجهارة» و«الإزاحة الزمنية» لكل تردد صوتي على حدة، كما لو قاموا بتفكيكه إلى ألوان قوس قزح – وهي طريقة تُعرف باسم التحليل الطيفي. واتضح أن المقبض الأساسي هو الجهارة، وليس تزامن الطور.
فقدان الذاكرة اللغوية في الشبكات العصبية: كيف ينقذ الإسقاط المتدرج الموحد النماذج متعددة اللغات
شبكة عصبية كبيرة، مثل Whisper، التي تتقن مئات اللغات، تشبه النموذج القياسي في فيزياء الجسيمات الأولية — نظامًا متناسقًا حيث كل شيء في توازن دقيق. ولكن بمجرد البدء في تدريبها على لغة نادرة، ينهار هذا التوازن: تتحول اللغة المستهدفة إلى ثقب أسود — منطقة تجذب بلا هوادة جميع موارد التدريب.
مركز الصوت: كيف ننقل الكلام دون بتات زائدة
النهج القياسي لرقمنة الكلام، الذي يقوم عليه النموذج القياسي للاتصالات الحديثة، هو أخذ عينات مباشر: آلاف المرات في الثانية يتم تسجيل شدة الإشارة اللحظية. تخيل أنك تتذوق المرق بملعقة صغيرة — كل رشفة تعطي لمحة خافتة عن الطعم، ولإدراك النكهة الكاملة عليك أن تغرف مرارًا وتكرارًا. وهكذا هنا: تتدفق البيانات وتتضخم، رغم أن الحمل الدلالي فيها ضئيل.
تعلم الآلة2026-07-141 دarXiv:2607.12417سريع
شبكة عصبية تدرك الطور: من السمع إلى الحوسبة الكمومية
من الملائم تمثيل الإشارة الصوتية بعدد مركب: معامله (السعة) يعكس شدة الصوت، ووسيطه (الطور) يحدد موضع الموجة في الزمن وإزاحتها اللحظية. الشبكات العصبية التقليدية تقسم هذا الوصف الموحد إلى إحداثيين مستقلين – ببساطة، تحدد عنوانًا في شبكة ديكارتية: «خطوتان شرقًا وخطوة شمالًا».
ZipL-Dialog: أصبح تركيب الكلام أكثر كفاءة بـ 11 مرة
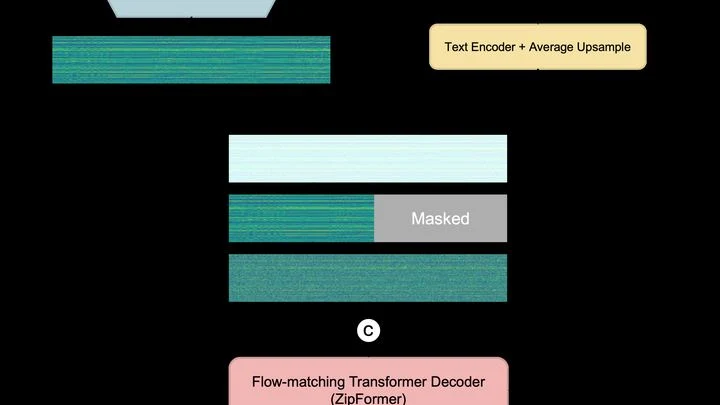
كان تحويل النصوص الطويلة إلى كلام، مثل الكتب الصوتية، يتطلب في السابق من الحاسوب الاحتفاظ بصورة مفصلة جداً لكل ثانية من الصوت — كما لو كان عليك رسم خطة دقيقة بمقياس المليمتر لمسار رحلة تستغرق ساعة كاملة. كانت هذه 'الخرائط' ضخمة، وحتى الأجهزة القوية كانت تتعثر أثناء تجميع الكلام قطعة قطعة. أما طريقة ZipL-Dialog فتتبع نهجاً مختلفاً: فهي تضغط الصوت أولاً إلى صورة موجزة — مثل زنبرك مشدود يختزن طاقة كامنة.
أجهزة السمع تتعلّم تذوّق الصوت
تشبه أجهزة السمع التقليدية طاهياً يطبخ بوصفة وهو مغمض العينين. تحلل الفوضى الصوتية الفوضى القادمة من الميكروفون، وبناءً عليها تضخّم الكلام. في مقهى صاخب، كثيراً ما يخطئ هذا الأسلوب. يتصرّف النظام الجديد كطاهٍ خبير: يعالج الإشارة أولاً ثم يتذوق النتيجة. إن لم يكن الكلام نقياً، يعدّل الإعدادات، مثل إضافة الملح إلى حساء جاهز.
كيف يتعلم الكمبيوتر سماع الجميع في غرفة صاخبة
في غرفة صاخبة، يميز الإنسان الصوت المطلوب بفضل الأذنين اللتين تلتقطان الفرق في وصول الصوت. يعمل الكمبيوتر المزود بعدة ميكروفونات بالطريقة نفسها: يحصل على تلميحات مكانية — من أين يتحدث كل شخص. في السابق، كانت هذه التلميحات تُستخدم للتركيز على اتجاه واحد، مثل شعاع المصباح. لكن عند تداخل الأصوات، كان التركيز يتشتت ويُفقد جزء من الإشارة — كما لو كنا نحاول رؤية ممثلَين في نفس شعاع الكشاف دفعة واحدة.
التدوين الصوتي: كيف يلتقط الخوارزم أي حدث صوتي دون معرفة مسبقة
الأذن البشرية مصممة بحيث يبرز الدماغ في المقام الأول الأنماط المألوفة — صوت المحاور، وصوت المطر، وإشارة السيارة. لكن النظام الجديد يعمل بمبدأ مختلف: فهو يسجل أي طفرة صوتية، حتى تلك التي لم تُسمع من قبل. يُسمى هذا النهج بالتدوين الصوتي (audio diarization) — وهو ليس مجرد البحث عن ضوضاء محددة، بل تقسيم التسجيل الصوتي بأكمله إلى مقاطع مع تحديد واضح لبداية ونهاية كل حدث صوتي.
كيف تعلمت السماعات رؤية مصدر الضوضاء
إلغاء الضوضاء النشط ينتج 'صوتًا مضادًا' لإخماد الضوضاء. لكن الأنظمة التقليدية عمياء: فهي لا تعرف من أين يأتي الصوت. في الغرف ذات الصدى، يشبه ذلك محاولة قيادة سفينة في عاصفة دون بوصلة — تكتم الصوت بشكل عشوائي. اكتشف مبدأ إخماد الموجات في القرن السابع عشر العالم كريستيان هوغنس، لكن التوجيه المكاني أضيف الآن فقط. الطريقة الجديدة تمنح النظام بصرًا.
كيف تخلصت الشبكة العصبية المولدة للأصوات من وزنها الزائد
الشبكة العصبية التي تولد الأصوات من النصوص تشبه مطبخاً يحضّر فيه عشرات الطهاة كل «طبق». كثير منهم لا يضيفون شيئاً سوى الإشارات الخاطئة وإهدار الموارد. أجرى العلماء مراجعة: باستخدام مطيافية (تحليل طيف المعلمات) حددوا من هو ضروري حقاً، واستغنوا عن الزائدين — بإزالة الوصلات غير المفيدة. بعد هذا التنظيف، تخلص النموذج من 83% من معلماته وأصبح يعمل أسرع بنسبة 39%.
كيف توقف الذكاء الاصطناعي عن الخلط بين الأصوات في السيناريو
النماذج التي تحول النص إلى صوت تتقن إعادة إنتاج الأصوات المنفردة، لكنها تحتار عندما يتضمن السيناريو عدة أحداث. على سبيل المثال، وفقًا للسيناريو يأتي رنين الجرس أولاً، ثم خطوات الأقدام، ثم صوت إغلاق الباب. قد يعيد المولد ترتيب الأحداث، فيسمع المستمع خطوات الأقدام قبل رنين الجرس. وجد الباحثون حلاً غير متوقع: بدلاً من برمجة قواعد معقدة، أخذوا شبكة عصبية 'تفهم' الصوت، وجعلوها مراقبًا صارمًا.
الأفق الموسيقي: كيف يكتسب اللحن بُعدًا
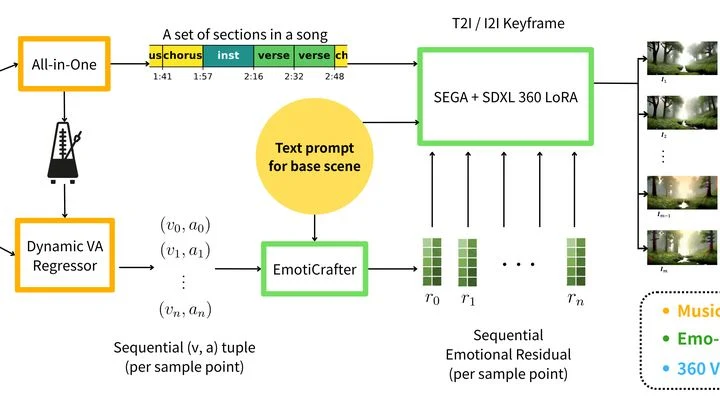
قائد الأوركسترا لا يحمل عصا، بل فرشاة، وكل إيماءة تولّد لونًا وشكلًا. هذا التشبيه يساعد على فهم التقنية الجديدة: فهي تحوّل الديناميكية العاطفية للأغنية إلى فيديو بانورامي يحيط بالمستمع — تمامًا كما يحوّل الفنان فكرته إلى لوحة مجسمة. أولًا، يقوم الخوارزمية، مثل التحليل الطيفي — وهو أسلوب لتحليل الضوء إلى أطوال موجية — بتفكيك المقطع إلى مكونات عاطفية.
الصوت2026-07-151 دarXiv:2607.13477سريع
قضاة الذكاء الاصطناعي يستمعون بالعلامات لا بالآذان
حكّام الكلام الآليون هم خوارزميات تُقيّم النطق والعواطف. لكنهم غالبًا ما يعملون كناقد طعام يُصدر حكمه بعد قراءة القائمة دون تذوّق الطبق. فبدلاً من تحليل الصوت، يتشبث النموذج بالمؤشرات النصية — كما لو كان يحكم على طبق من خلال وصفتها لا مذاقها. أظهرت التجارب أنه إذا قمت ببساطة بتبديل تسجيلين صوتيين، فإن حكم الذكاء الاصطناعي يغيّر درجته، رغم بقاء الصوت كما هو.
تقييم حاسوبي للنطق دون بيانات موسومة
إن إتقان لغة أجنبية يشبه ضبط آلة موسيقية. تعمل التقنية الجديدة كموالف ذكي: فهي تستقبل تسجيلك الصوتي وخطاب الناطق الأصلي المرجعي، ثم تمدد أو تضغطهما زمنيًا بشكل ديناميكي — تمامًا كما تُشدّ أوتار الآلة لمطابقة النغمات بدقة — لمحاذاة الإشارات بشكل مثالي، وتقيّم ثلاثة معايير رئيسية: نقاء الأصوات (النطق)، والدقة الإيقاعية، والمنحنى التنغيمي.
طهي صوت حي: مجموعة بيانات روسية تعلّم المساعدين الشعور
غالباً ما تشبه المساعدات الصوتية طبّاخاً يقرأ وصفة من ورقة دون ذرة شهية. أرشيف الحوارات الروسية الجديد 'ديالوغي' يغيّر القواعد: ثلاثة ممثلين في الاستوديو، مثل طهاة ماهرين، مزجوا 20 ساعة من المحادثات الحية باثنتي عشرة 'تابلة' عاطفية. حصلت كل جملة على وسم للأسلوب والعاطفة – فتشكّل كتاب نكهات متكامل.
WanSong: توليد الموسيقى من الضوضاء في مسار واحد
تُنشئ WanSong الموسيقى تمامًا كما ينحت النحات تمثالًا من كتلة رخام: نقطة البداية هي الضوضاء — صوت فوضوي يذكرنا بهدير الشلال — ومنه تزيل الخوارزمية خطوة بخطوة كل ما هو زائد، حتى تظهر النوتات النقية والأصوات. هذه الطريقة تسمى الإنتروبيا وهي عملية تعكس الفوضى إلى نظام، كما لو نشاهد انتشار الحبر في الماء ولكن بترتيب عكسي.
كيف تنتقي صوت صديقك من بين جلبة الحديث
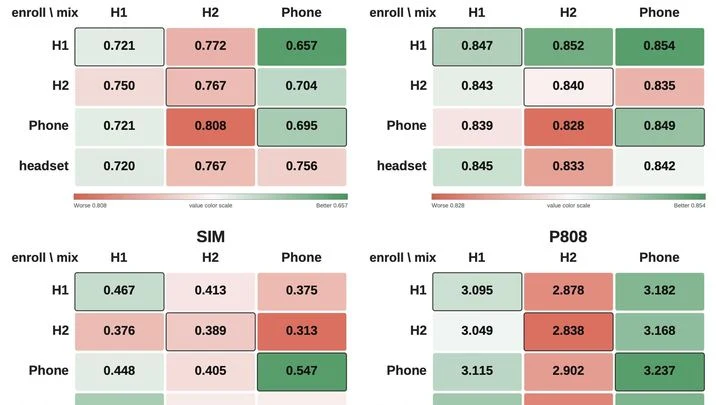
يستخلص الإنسان دون عناء الصوتَ المطلوب من جلبة الحفل. أما بالنسبة للحاسوب، فما زال الأمر في حدود المستطاع. كانت البرامج السابقة تتدرب على تسجيلات عقيمة، لا صدى فيها ولا طنين أجهزة. لكنّ الحوار الحقيقي يشبه تيارًا عارمًا: المتحاورون يقاطعون، ويبتعدون عن الميكروفون، وفي الخلفية أزيز ماكينة القهوة. مسابقة REAL-TSE الجديدة ترمي بصنارتها لأول مرة في هذه المياه العكرة.
وهم الدقة: كيف يخدع اختبار الذكاء الاصطناعي في الصوتيات
الذكاء الاصطناعي الذي يتنبأ بصوتيات قاعة ما يشبه طالباً في امتحان يحفظ الإجابات دون فهم. إذا كانت نقاط الفحص هي نفسها نقاط التدريب، يقوم النموذج ببساطة بحفظ "البصمة" الصوتية لكل موضع – كطالب يتعرف على ورقة الأسئلة من ثنية صغيرة فيها. شَدِّد القواعد – جمِّع البيانات حسب المواقع وأخفِ الدلائل الترددية – وستنهار الدقة من 85% إلى 9–57%.