Обработка аудио и речи eess.AS

23 статей

Звук и речь: обработка звуковых сигналов, распознавание и синтез речи.

статей

Как машина учится различать звуки речи
Учительница в классе объясняет разницу между «дом» и «том»: приложите руку к горлу и почувствуйте вибрацию. Машина, которая распознаёт речь, делает примерно то же самое, только внутри у неё не горло, а длинные списки чисел. Оказалось, эти числа можно разложить по полочкам — как кубики с буквами в детской.
Звук2026-03-071 минarXiv:2603.07215экспресс
Стетоскоп, который слышит кишечник
Кишечник разговаривает с врачом — но очень тихо. Урчание и бульканье длятся доли секунды и легко теряются среди звуков лёгких и сердца. Стетоскоп улавливает лишь малую часть, поэтому диагноз зависит от опыта и слуха конкретного врача. Носимый датчик SonicGuard, закреплённый на животе, слушает непрерывно и записывает каждый шорох. Затем в работу вступает алгоритм.
Прикладная физика2026-06-072 минarXiv:2606.08524экспресс
Акустическая маскировка: звук подменяет реальность
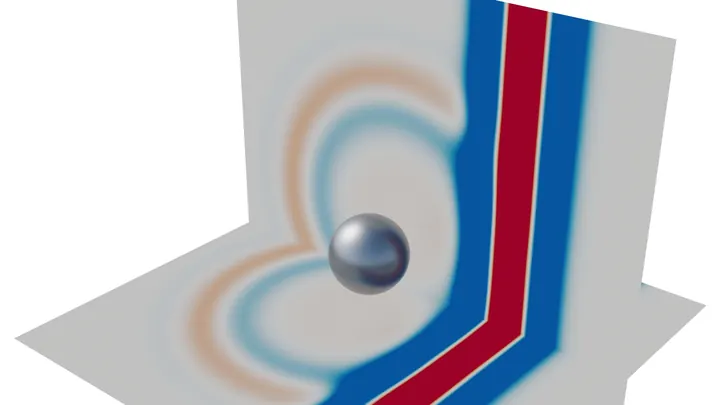
Если хлопнуть в ладоши в пустой комнате, эхо расскажет о её размерах и форме. Каждый предмет — стул, книга, человек — добавляет в это эхо свою подпись: звук отражается от него особым образом. Авторы статьи придумали, как полностью переписать эту звуковую подпись. Они окружили область пространства замкнутой поверхностью из микрофонов и динамиков.
Сферическая антенна: как микрофоны перестали ошибаться
Обычный кардиоидный микрофон — устройство с диаграммой направленности, напоминающей сердце, — подобно человеческому уху, обладает максимальной чувствительностью спереди, но его показания искажаются при боковом падении звука.
Компьютерное зрение2026-07-131 минarXiv:2607.11120экспресс
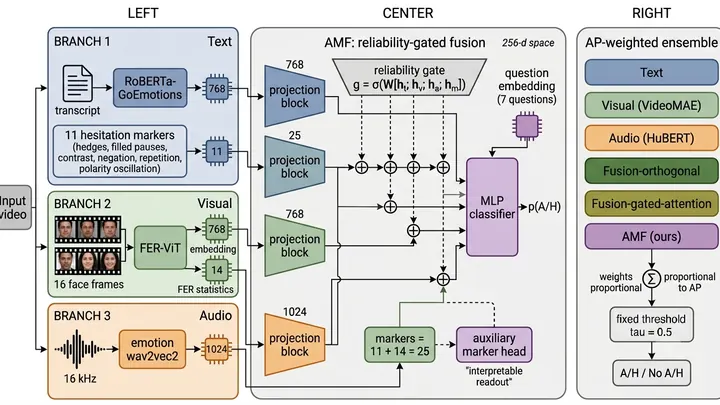
Сомнение выдаёт тишина: ИИ читает паузы
Новая система анализирует короткое интервью, чтобы распознать сомнения человека, объединяя текст, голос и выражение лица. Но главным ключом к неуверенности оказалась тёмная материя речи — паузы и слова-паразиты, которые стандартные речевые системы стирают, словно чёрная дыра, поглощающая всё без следа.
Чистый звук: почему амплитуда важнее фазы в шумоочистке речи
Очистка речи от шумов напоминает настройку старого телевизора: перекрутишь ручку контрастности — и лица становятся неестественными. Исследователи применили метод, позволяющий раздельно регулировать амплитуду (громкость) и фазовый сдвиг (сдвиг по времени) для каждой частоты звука — это спектроскопия, разложение сигнала на частотные…
Языковая амнезия нейросетей: как Unified Gradient Projection спасает многоязычные модели
Крупная нейросеть, такая как Whisper, владеющая сотнями языков, напоминает стандартную модель физики элементарных частиц — стройную систему, где всё находится в тонком равновесии.
Звуковой концентрат: как передать речь без избыточных битов
Стандартный подход к оцифровке речи, лежащий в основе современных телекоммуникаций, — это прямая дискретизация: тысячи раз в секунду фиксируется мгновенная громкость сигнала. Представьте, что вы пробуете бульон чайной ложкой — каждый глоток даёт лишь слабый намёк на вкус, а чтобы уловить букет, приходится черпать снова и снова.
Машинное обучение2026-07-141 минarXiv:2607.12417экспресс
Нейросеть, воспринимающая фазу: от слуха к квантовым вычислениям
Звуковой сигнал удобно представлять комплексным числом: его модуль (амплитуда) отражает громкость, а аргумент (фаза) — положение волны во времени, её мгновенный сдвиг. Традиционные нейросети расщепляют это единое описание на две независимые координаты — грубо говоря, задают адрес в декартовой сетке: «два шага на восток, один на север».
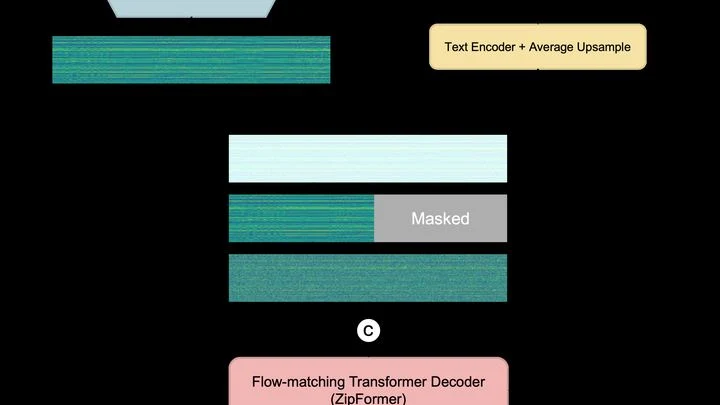
ZipL-Dialog: одиннадцатикратное снижение стоимости синтеза речи
Озвучивание протяжённого текста — например, аудиокниги — прежде требовало от компьютера удерживать в оперативной памяти детализированную картину каждой секунды звука. Аналогия: чтобы воспроизвести часовой разговор, приходилось вычерчивать миллиметровый план всего маршрута. Подобные «карты» были колоссальными, и даже мощные машины захлёбывались, собирая речь фрагментами.
Слуховые аппараты с обратной связью: как технология «пробует» звук на вкус
Традиционные слуховые аппараты напоминают повара, который готовит по рецепту вслепую. Они анализируют звуковой беспорядок с микрофона и на его основе усиливают речь. В шумном кафе такой подход часто ошибается. Новая система ведёт себя как опытный кулинар: сначала обрабатывает сигнал, а затем «пробует» результат.
Пространственная геометрия звука: как алгоритм учится слышать каждого в шумной комнате
В шумной комнате человек выделяет нужный голос благодаря бинауральному слуху: два уха улавливают микроскопическую разницу во времени прихода звуковых волн и их интенсивности. Компьютер с массивом микрофонов действует аналогично — он извлекает пространственные подсказки, вычисляя направление на каждый источник звука.
Аудиодиаризация: как алгоритм улавливает любые звуковые события без предварительного знания
Человеческий слух устроен так, что мозг выделяет в первую очередь знакомые паттерны — голос собеседника, шум дождя, сигнал автомобиля. Однако новая система работает по иному принципу: она фиксирует любой звуковой всплеск, даже тот, что никогда не встречался ранее.
Как наушники обрели пространственное зрение для борьбы с шумом
Активное шумоподавление рождает «антизвук» — волну в противофазе, чтобы погасить нежелательный шум. Но стандартные системы слепы: они не знают, откуда приходит звук. В помещениях, где звук мечется эхом, это подобно боксу с завязанными глазами — глушишь вслепую, часто невпопад.
Как нейросеть, генерирующая звуки, избавилась от 83% параметров без потери качества
Представьте кухню, где каждое «блюдо» — синтезированный по тексту звук — готовят десятки поваров. Многие из них лишь мешают: подают ложные сигналы и бесцельно тратят ресурсы. Именно так устроена полная версия нейросети-генератора звуков: множество её связей не участвуют в деле, но потребляют вычислительную мощность.
Как ИИ перестал путать звуки в сценарии: нейросетевой дирижёр на страже временного порядка
Модели, превращающие текст в аудио, хорошо воссоздают одиночные звуки, но путаются, когда в сценарии их несколько. Например, по сценарию сначала звонок, потом шаги, потом хлопок двери. Генератор может переставить события, и зритель услышит шаги до звонка. Исследователи нашли неожиданное решение: вместо программирования сложных правил они взяли нейросеть, которая «понимает» аудио, и сделали её строгим контролёром.
Компьютерное зрение2026-07-151 минarXiv:2607.13471экспресс
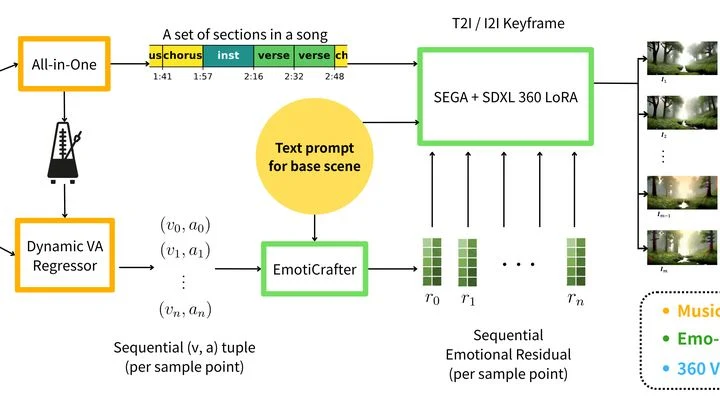
Музыкальный горизонт: как песня обретает объём
Дирижёр держит не палочку, а кисть, и каждый взмах рождает цвет и форму. Эта аналогия помогает понять новую технологию: она преобразует эмоциональную динамику песни в панорамное видео, окружающее слушателя, — подобно тому, как художник превращает замысел в объёмное полотно.
Звук2026-07-151 минarXiv:2607.13477экспресс
ИИ-судьи речи: когда алгоритм оценивает не звук, а текстовые подсказки
Автоматические судьи речи — это алгоритмы, обученные оценивать произношение и эмоциональную окраску голоса. Однако, как показали исследования, они часто ведут себя подобно кулинарному критику, который выносит вердикт, прочитав меню, но не попробовав само блюдо.
Компьютерная оценка произношения без размеченных данных
Освоение иностранного языка сродни настройке музыкального инструмента. Новая технология действует как интеллектуальный тюнер: она принимает вашу аудиозапись и эталонную речь носителя, затем динамически растягивает или сжимает их во времени — подобно тому, как подтягивают струну для точного совпадения тонов, — чтобы идеально совместить сигналы, и оценивает три ключевых параметра: чистоту звуков (артикуляцию)…
«Диалоги»: русский датасет для эмоционального синтеза речи
Голосовые помощники нередко напоминают повара, который монотонно зачитывает рецепт по бумажке, не вкладывая ни капли аппетита. Новый архив русских диалогов «Диалоги» меняет правила игры. Три актёра в студии, подобно шеф-поварам, замешали 20 часов живых разговоров, приправив их двенадцатью эмоциональными «специями».
WanSong: генерация музыки из шума за один проход
WanSong создаёт музыку подобно тому, как скульптор ваяет статую из глыбы мрамора: отправной точкой служит шум — хаотичное звучание, напоминающее рокот водопада, — из которого алгоритм шаг за шагом убирает всё лишнее, пока не проступают чистые ноты и голоса.
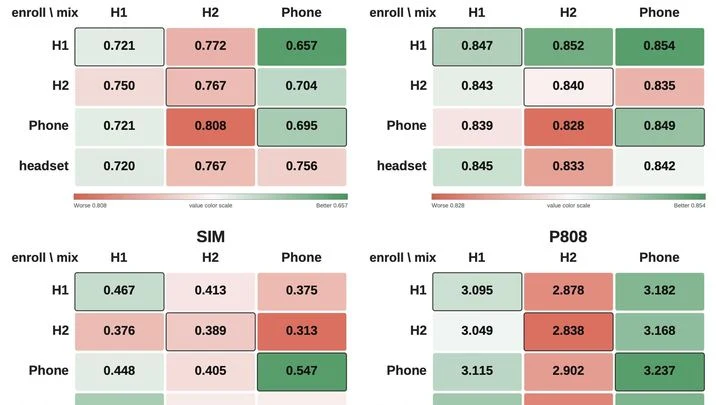
Как выудить голос друга из шумной беседы: вызов REAL-TSE Challenge
Человек без усилий выхватывает нужный голос из гомона вечеринки — наш мозг справляется с этой задачей, словно опытный рыбак, безошибочно узнающий плеск знакомой рыбы в бурном потоке. Для компьютера то же самое — пока задача на пределе возможностей. Прежние программы тренировались на стерильных записях, где нет ни эха, ни звона приборов.
Иллюзия точности: как проверка ИИ в акустике вводит в заблуждение
Искусственный интеллект, предсказывающий акустику помещения, напоминает студента на экзамене со шпаргалкой. Если проверочные точки совпадают с учебными, модель просто запоминает звуковой «отпечаток» каждой позиции — как студент, узнающий билет по загибу уголка.