Контрастивное обучение — это подход в машинном обучении, позволяющий строить качественные представления данных без разметки (self-supervised learning). Оно опирается на понятие контрастной потери: модель притягивает представления (embedding) семантически близких объектов (positive pairs) и отталкивает представления несвязанных (negative pairs). Например, для изображений позитивными парами служат разные ракурсы (аугментации) одного и того же снимка, а негативами — любые другие изображения в мини-пакете. Таким образом, нейросеть учится выделять инвариантные признаки, игнорируя несущественные вариации освещения, поворота, масштаба. Метод лёг в основу многих современных систем распознавания, где зачастую превосходит обучение с учителем при малом количестве меток.
История
Корни уходят в метрическое обучение: сиамские сети (Bromley et al., 1993) для сравнения подписей. В 2006 году Хадселл и Лекун предложили contrastive loss для обучения инвариантных представлений. Возрождение интереса связано с прогрессом в self-supervised learning для изображений: в 2018 году модель InstDisc (Wu et al.) использовала memory bank; прорывными стали MoCo (He et al., 2020) с очередью отрицательных примеров и SimCLR (Chen et al., 2020) с большим размером батча и сильной аугментацией. Эти работы показали, что контрастивное предобучение достигает точности, близкой к обучению с учителем, а иногда и превосходит его при дообучении на малых выборках. Впоследствии подход адаптирован для видео, аудио, графов и многомодальных данных (CLIP, 2021).
Как это работает
Алгоритм включает три этапа: (1) стохастическая аугментация данных создаёт два независимых представления одного входа (например, случайное кадрирование, искажение цвета); (2) кодировщик (ResNet, ViT) отображает их в векторы скрытого пространства; (3) проекционная голова (MLP) преобразует их в более низкоразмерное пространство, где вычисляется контрастная потеря InfoNCE: L = -log[ exp(sim(z_i, z_j)/τ) / ∑_{k=1}^{2N} 1_{k≠i} exp(sim(z_i, z_k)/τ) ], где sim — косинусное сходство, τ — температурный параметр. Оптимизация понижает взаимную энтропию между распределением положительных и отрицательных пар. Чтобы избежать коллапса представлений (вырождения всех векторов в одну точку), применяют механизмы: отрицательные пары из очереди (MoCo), стоп-градиент и предсказатель (BYOL), кластеризацию (SwAV). В итоге скрытое пространство приобретает семантическую структуру, инвариантную к заданным преобразованиям.
Где применяется
Распознавание лиц без меток, поиск похожих снимков в больших архивах, улучшение диагнозов по медицинским изображениям, когда мало размеченных данных.
Любопытный факт
Система CLIP от OpenAI, обученная контрастивно на парах изображение-текст, способна рисовать картины по описанию, хотя её никогда не учили художественному стилю напрямую — она просто уловила взаимосвязи.
Переводчик в зале, где одновременно говорят на трёх языках, сначала слышит лишь общий шум. Но если он начнёт переспрашивать, вслушиваться в интонации и раз за разом уточнять, кто какой фразой ответил, постепенно из какофонии проступят отдельные голоса.
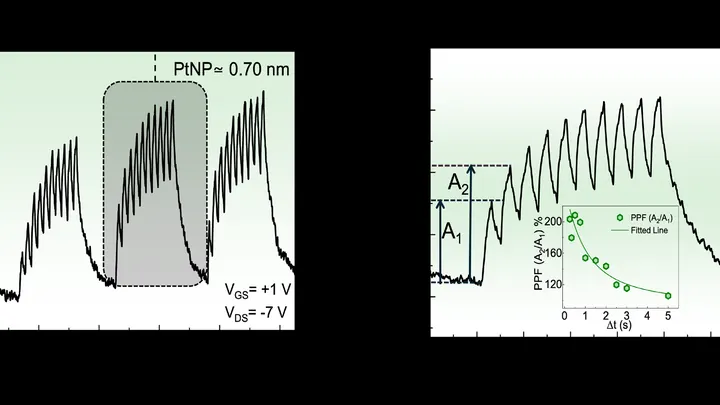
Пластиковая плёнка толщиной с человеческий волос содержит платиновые точки размером меньше миллионной доли миллиметра — так называемые наночастицы. Они расположены на границе двух слоёв транзистора и действуют как ловушки для электрического заряда: подобно губке, впитывающей воду, эти точки захватывают и удерживают электроны.
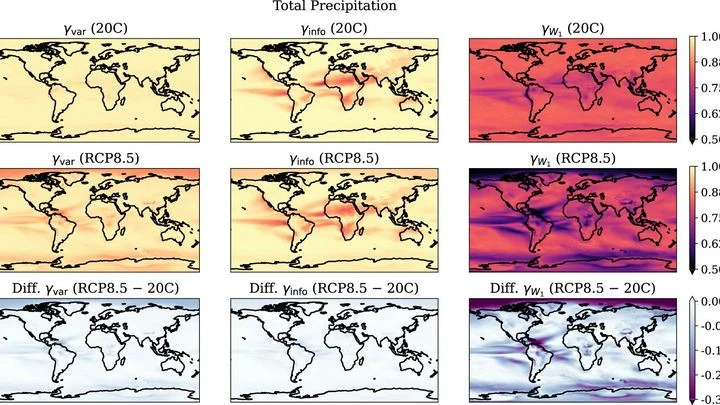
Зимой в одном районе города выпадает втрое больше снега, чем в соседнем. Один год — жара, другой — холод. Это капризы погоды — краткосрочные, хаотичные колебания атмосферы. А за десятилетия виден другой, медленный сдвиг: зимы в среднем становятся мягче. Отличить одно от другого — главная задача климатологов.
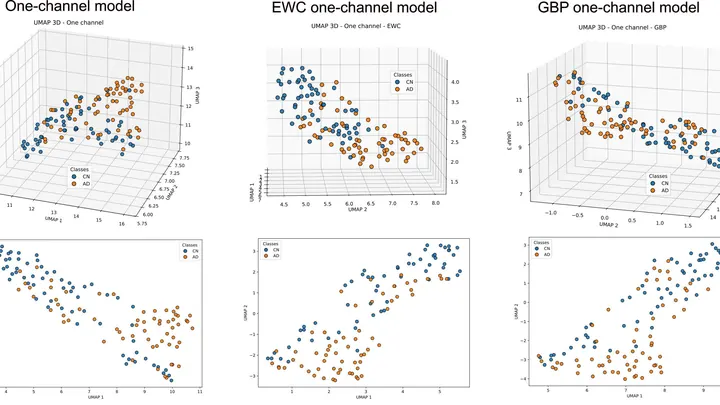
Врач годами учится распознавать болезни по снимкам мозга. Сначала он отлично видит признаки старения, потом осваивает опухоли — и вдруг начинает путаться в том, что знал раньше. Примерно так же ведут себя и многие нейросети: новые знания затирают старые. Это явление называется катастрофическим забыванием — когда модель, обученная на новой задаче, теряет точность на предыдущих.
Представьте склад с коробками яблок и груш. Яблок много, груш мало. Но когда кладовщик говорит «фрукт с гладкой кожурой», мы почему-то чаще вспоминаем редкую грушу, а не частое яблоко. Это проявление эффекта обратной базовой ставки — устойчивого когнитивного искажения, при котором мозг, разрешая неоднозначность между категориями, систематически переоценивает редкие варианты за счёт частых.
В 1998 году математик Дэвид Бойд заметил странную закономерность. Он изучал меру Малера многочлена — величину, которая измеряет «сложность» его корней, — и обнаружил, что для семейства кривых она всегда выражается через специальное рациональное число, умноженное на значение производной L-функции.
Прогноз выхода химической реакции — это попытка предсказать урожай, зная лишь состав почвы. Долгое время химики опирались на длинные колонки чисел, так называемые квантовые дескрипторы, которые описывают энергию электронов, но умалчивают о форме молекулы.
Нейросеть предсказывает будущее динамической системы — например, эволюцию плазмы в магнитном поле или изменение лица на видео. Ошибки неизбежны, и чем дальше модель заглядывает вперёд, тем больше их накапливается. Свериться с правильным ответом в момент работы невозможно: его просто не существует.
Авторы новой работы нашли простой, как всё гениальное, трюк: обучить одну модель двигаться и вперёд, и назад по времени.
Каждое утро десятки телескопов наводятся на Солнце. Их камеры ловят узкую полоску красного света — линию Hα, открытую Иоганном Бальмером. На снимках проступают тёмные, прихотливо изогнутые нити. Они похожи на стежки гигантского гобелена, прошивающего раскалённую корону. Это солнечные волокна.
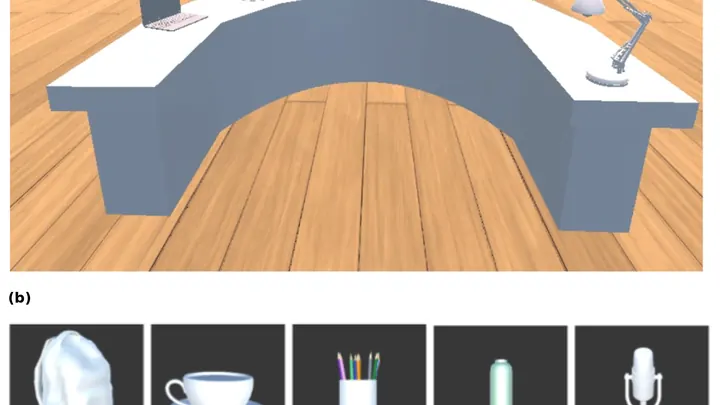
Глазной протез передаёт в мозг не фотографию, а редкий пунктир из светлых точек — фосфенов. Чтобы разглядеть в этой ряби чашку или ключи, человек вынужден водить головой, как фонариком в темноте, и по крупицам собирать очертания предмета. Это медленный процесс, похожий на сбор пазла, где большинство деталей выброшено.
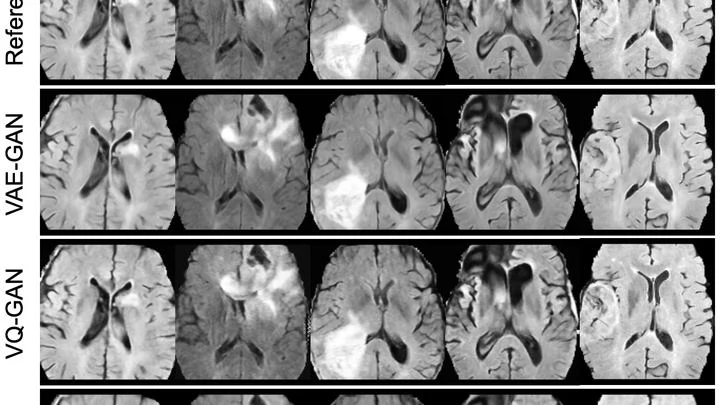
Обычные алгоритмы компьютерного зрения воспринимают медицинские изображения как набор несвязанных фрагментов — любые два несовпадающих снимка для них абсолютно различны. Это напоминает попытку отличить близнецов, не зная об их родстве. В медицине же пациенты с одним заболеванием часто выглядят на МРТ почти идентично, и алгоритм ошибается, путая «родственные» случаи.
Радиосигнал со слоистой модуляцией — представьте: несколько независимых информационных потоков, наложенных друг на друга, — напоминает культурный слой древнего города. Каждый уровень несёт свою историю, но со временем, под воздействием помех и искажений, они спутываются в хаотичную мешанину. Обычные алгоритмы демодуляции теряются в этой смеси, не в силах разделить слои.
Объём данных одного КТ-сканирования сопоставим с несколькими полнометражными фильмами в высоком разрешении. TCAM-Diff — это алгоритмический метод, который обходит это узкое место: программа сжимает трёхмерную картину в три двумерные теневые проекции — словно скульптор восстанавливает объёмную статую по силуэтам, отбрасываемым на три перпендикулярные стены.
Стандартный подход к одному классу задач машинного обучения напоминает пружину, которую растянули и забыли отпустить: стандартные методы искусственно раздувают размер задачи, превращая вычисления в чёрную дыру для памяти и времени.
Мозг общается короткими электрическими разрядами — потенциалами действия. Прежде расшифровка этого языка требовала тысяч размеченных примеров: экспериментатор сопоставлял сигнал с конкретным движением или словом. Метод MOJO предлагает иной подход — подобно изучению языка через погружение, он сначала вслушивается в «поток сознания» без всяких подсказок и самостоятельно выявляет повторяющиеся паттерны.
Представьте водителя на обледенелой трассе: он не знает точной реакции машины на поворот руля и вынужден учиться в процессе, интуитивно сохраняя запас пространства для возможной ошибки. Сходным образом действует адаптивный алгоритм управления.
Ребёнок, осваивая незнакомую квартиру, ползает от предмета к предмету и запоминает, что видно из каждого угла. Так мозг строит мысленную карту — внутреннюю модель пространства. Алгоритм gradCSCG действует по тому же принципу: он получает видеопоток с камеры и самостоятельно рисует схему помещения, опираясь лишь на смену картинок.
Когда вы набираете «салат», а интеллектуальная клавиатура предлагает «цезарь», за кулисами миллионы телефонов совместно обучаются предсказывать слова. Они обмениваются не вашими сообщениями, а лишь улучшениями общего алгоритма — подобно тренеру, который рассылает спортсменам только изменения в плане тренировок: «добавьте 5 отжиманий к вчерашней программе».
Представьте кухню с газовыми конфорками: каждая греет по-своему, и если повар переставит кастрюли, еда может подгореть. Так и в беспроводной сети: антенны-конфорки и пользователи-кастрюли требуют точной расстановки. Обычные нейросети не различают позиции, считая все конфорки одинаковыми, поэтому им трудно оценить качество связи или настроить передачу.
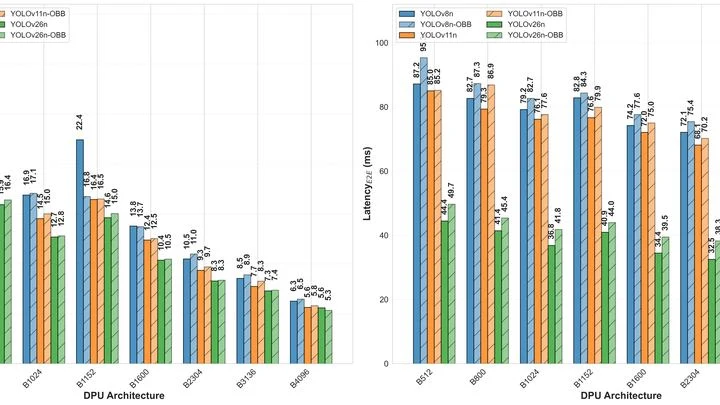
Современные системы машинного зрения обретают автономность: инженерам удалось реализовать алгоритм распознавания образов непосредственно на миниатюрном чипе, избавив камеру от необходимости передавать данные на громоздкий компьютер.
Контактная сеть железной дороги напоминает галактику — сложную структуру, где энергия растекается подобно гравитационным полям, связывающим звёзды. Поезда в этой аналогии становятся планетами — массивными объектами, возмущающими среду своим присутствием.
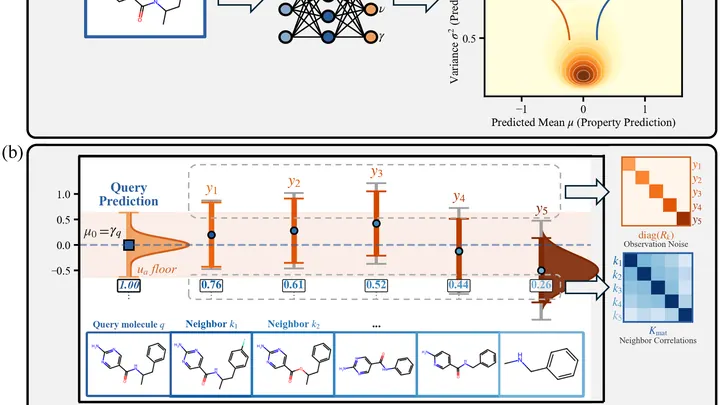
Предсказать свойства новой молекулы — сродни попытке угадать вкус незнакомого блюда. Программа работает как опытный повар: она «пробует» похожие молекулы, чьи свойства уже известны, и на основе их «вкуса» уточняет свою догадку. Например, для воды или углекислого газа алгоритм находит изученные аналоги и корректирует температуру кипения или растворимость.
Крупная нейросеть, такая как Whisper, владеющая сотнями языков, напоминает стандартную модель физики элементарных частиц — стройную систему, где всё находится в тонком равновесии.
Машинное обучение давно перестало быть просто инструментом — оно становится исследователем, самостоятельно выуживающим законы природы из данных. Но как кремниевый разум приходит к пониманию? Чтобы подсмотреть этот процесс, физики обратились к игрушечной, но глубокой модели — решётке Изинга, где спины танцуют под диктовку температуры.
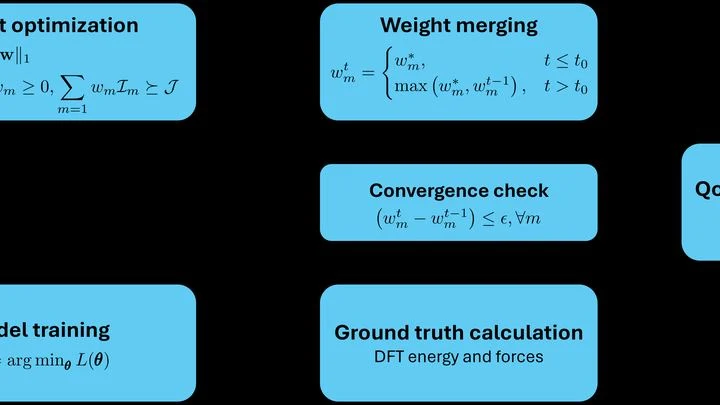
DFTB — это скоростной поезд в мире квантовой химии: в сотни раз быстрее классического DFT, но всё ещё на электронных рельсах. Однако его двигатель — итеративное самосогласование зарядов — порой напоминает оркестр, где каждый инструмент начинает с произвольной ноты.
Гравитационное микролинзирование — удивительный космический эффект, предсказанный Эйнштейном и развитый Цвикки. Массивное тело, проходя между нами и далёкой звездой, искривляет её свет подобно линзе, создавая характерные усиления и искажения.
Глубины космоса не молчат — они полны зашифрованных посланий. Каждая звезда, каждый квазар посылает свой дрожащий световой код: ритмичный, как морзянка цефеиды, или хаотичный, словно взломанный шифр сверхновой. Астрономы перехватывают эти сигналы миллионами каждую ночь — но как прочесть их без ключа?
Золото не лежит на поверхности — оно спрятано в тоннах пустой породы. Чтобы добыть грамм драгоценного металла, старатели просеивают кубометры грунта. Примерно так же обучаются современные большие языковые модели: тысячи ответов-кандидатов прогоняются через дорогую модель-оценщик (оракул — модель, дающая точные оценки), чтобы выбрать один — лучший.
Веками астрономы всматривались в ночное небо, ловя малейшие изменения блеска звёзд. Эти неравномерные ряды — кривые блеска — словно нотные станы: каждая звезда исполняет свою уникальную мелодию. Но сегодня потоки данных с телескопов вроде обзора Веры Рубин (LSST) превратились в оглушительную какофонию — миллиарды «записей» еженощно.
Создание материала с заданными свойствами — искусство, которое долго полагалось на интуицию и везение. Природа не даёт подсказок: десятки элементов в менделеевской таблице, и число их сочетаний уходит в бесконечность. Прежде материаловеды напоминали алхимиков, пробующих всё подряд, или полагались на статистические модели, терявшие силу за границами известного.
Современные холодильники и кондиционеры на фреонах незаметно отравляют атмосферу. Альтернатива — твёрдотельные калорические материалы, охлаждающиеся при быстром изменении давления за счёт барокалорического эффекта.
Мозг не учит каждую задачу с нуля — он переносит опыт с одного дела на другое. Но как узнать, какие задачи действительно родственны? Нейробиологи придумали остроумный ход: дать искусственной сети «подсмотреть» активность мозга во время одной задачи и попробовать предсказать активность во время другой. Если получается хорошо — значит, задачи близки.
Рентгеновские детекторы устроены подобно пчелиным сотам: в шестиугольных ячейках то здесь, то там регистрируются вспышки — следы попадания отдельных фотонов. Традиционные алгоритмы вынуждены растягивать эту естественную гексагональную структуру на прямоугольную сетку, что порождает артефакты — ложные призраки поляризации, искажающие реальную картину.
Танец сотен частиц: одни пары кружатся медленно и плавно, другие дёргаются в бешеном ритме. Чтобы понять суть танца, нужно следить именно за медленными движениями — они и есть главная хореография системы. В науке о молекулах такие медленные движения называют «медленными модами», и именно они определяют, как белок сворачивается в клубок или как лекарство связывается с мишенью.
Шеф-повар не тратит продукты, готовя всё блюдо, чтобы оценить вкус, — он пробует каплю соуса. Та же логика лежит в основе метода «информационного сопоставления» (information matching) для предсказания прочности металлов.
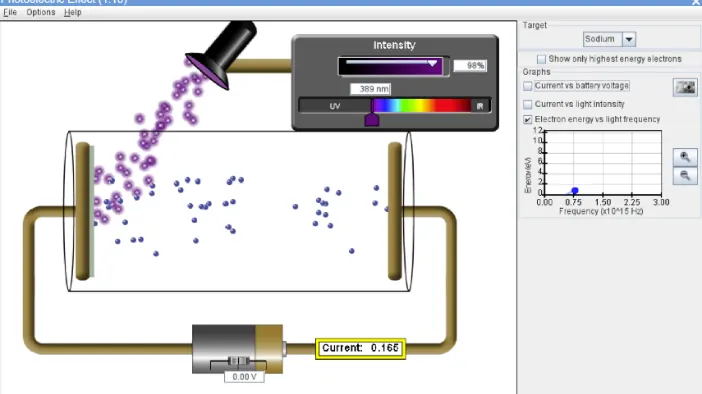
Понять фотоэффект — явление, при котором свет, падая на материал, выбивает из него электроны, — всё равно что учиться готовить без рецепта. На помощь приходят цифровые инструменты: игры дают интуитивное чутьё, симуляции — количественную точность.
Исследователи провели эксперимент с участием 55 студентов, разделив их на две группы.
Переводчик учит язык не по учебнику, а слушая живую речь и сразу видя, что люди делают в ответ на слова. Именно так работает новый метод C3P для чтения бактериальной ДНК. Обычные геномные модели пытаются выучить правила, просто «перечитывая» миллиарды букв генетического кода — и часто путаются. Причина в том, что регуляторные участки ДНК эволюционируют быстро и хаотично, как уличный сленг.
В океане банковских транзакций мошенничества встречаются реже, чем нейтронные звёзды в космосе — всего 0,1% от всех операций. Обычный детектор, обученный на таких несбалансированных данных, привыкает к чистому потоку и теряет способность распознавать редкие аномалии.
На помощь приходит гибридная система Q-SYNTH, включающая квантовый генератор.
Вы пробуете блюдо в ресторане, но меню не видели. Задаёте официанту вопросы — слишком солёное? с какими специями? — и по ответам пытаетесь угадать, что за повар его готовил. Примерно так же исследователи изучают современные нейросети, когда доступ к ним есть только через API (программный интерфейс, где можно задать вопрос и получить ответ, но нельзя заглянуть внутрь).
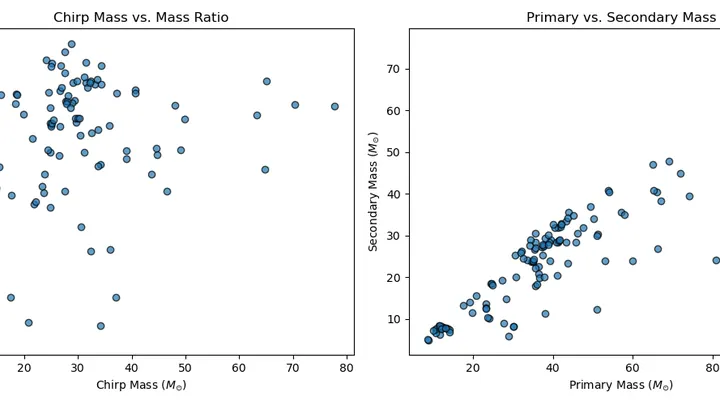
Симфония звучит, но в партитуру вкралась едва заметная фальшивая нота. Примерно так физики ищут отклонения от общей теории относительности в «звуках» Вселенной — гравитационных волнах от слияния чёрных дыр. Эти волны, словно круги на воде от брошенного камня, расходятся по ткани пространства-времени и доходят до детекторов на Земле.