Traitement audio et de la parole eess.AS

23 articles

articles

Comment une machine apprend à distinguer les sons de la parole
Dans une salle de classe, l'institutrice explique la différence entre « dom » et « tom » : posez la main sur la gorge et sentez la vibration. La machine qui reconnaît la parole fait à peu près la même chose, sauf qu'à l'intérieur, ce n'est pas une gorge, mais de longues listes de nombres.
Son2026-03-071 minarXiv:2603.07215express
Un stéthoscope qui écoute les intestins
L'intestin parle au médecin, mais très doucement. Les gargouillements et les bulles ne durent que des fractions de seconde et se perdent facilement parmi les sons des poumons et du cœur. Un stéthoscope ne capte qu'une petite partie, si bien que le diagnostic dépend de l'expérience et de l'oreille de chaque médecin.
Physique appliquée2026-06-072 minarXiv:2606.08524express
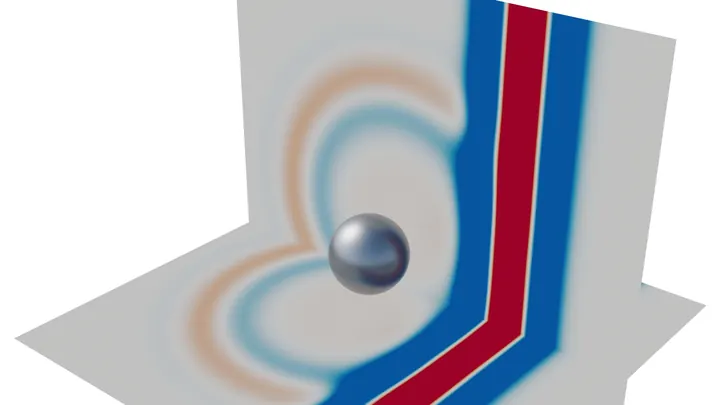
Masquage acoustique : quand le son réécrit la réalité
Si vous frappez dans vos mains dans une pièce vide, l'écho révélera sa taille et sa forme. Chaque objet — une chaise, un livre, une personne — ajoute sa signature à cet écho : le son s'y réfléchit d'une manière particulière. Les auteurs de l'article ont imaginé comment réécrire entièrement cette signature sonore.
La sphère sonore : quand les micros arrêtent de se tromper
Un micro cardioïde ordinaire, comme une oreille, entend mieux devant lui, mais ses mesures se brouillent si le son vient de côté. La solution ? Rassembler plusieurs de ces « oreilles » sur une sphère. On obtient ainsi une boule sonore qui capte le signal dans toutes les directions.
Le doute se trahit par le silence : l'IA lit les pauses
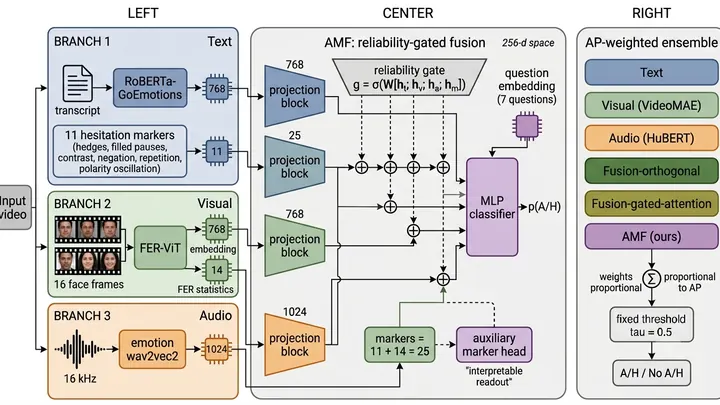
Un nouveau système analyse un court entretien pour reconnaître les doutes d'une personne, en combinant texte, voix et expressions faciales. Mais la clé principale de l'incertitude s'est révélée être la matière noire de la parole : les pauses et les mots de remplissage que les systèmes vocaux standard effacent comme un trou noir.
Un son propre : pourquoi le volume prime sur la phase
Débarrasser la parole du bruit, c'est un peu comme régler un vieux téléviseur : si l'on pousse trop le contraste, les visages deviennent artificiels.
Calcul et langage2026-07-131 minarXiv:2607.11163express
L'amnésie linguistique des réseaux de neurones : une solution !
Un grand réseau de neurones, comme Whisper, maîtrise des centaines de langues et ressemble au modèle standard de l'univers : tout est équilibré. Mais l'apprentissage d'une langue rare rompt cet équilibre — elle se transforme en trou noir qui attire toutes les ressources d'apprentissage.
Concentré sonore : transmettre la parole sans gaspillage de bits
La méthode standard de numérisation de la parole : on mesure le volume des milliers de fois par seconde. C'est comme goûter un bouillon avec une cuillère à café — chaque gorgée est aqueuse, et il n'y a presque pas de détails. Le flux de données enfle, alors que le sens se compte sur les doigts. Les chercheurs ont proposé de « réduire » d'abord le signal sonore.
Un réseau de neurones qui écoute la phase
Le son se décrit naturellement par un nombre complexe, où le volume représente la force de l'onde et la phase sa position dans le temps. Les réseaux de neurones classiques séparent ces deux aspects en coordonnées indépendantes, un peu comme si l'on donnait une adresse par quartiers : « deux à l'est, un au nord ».
ZipL-Dialog : la synthèse vocale devient 11 fois plus économe
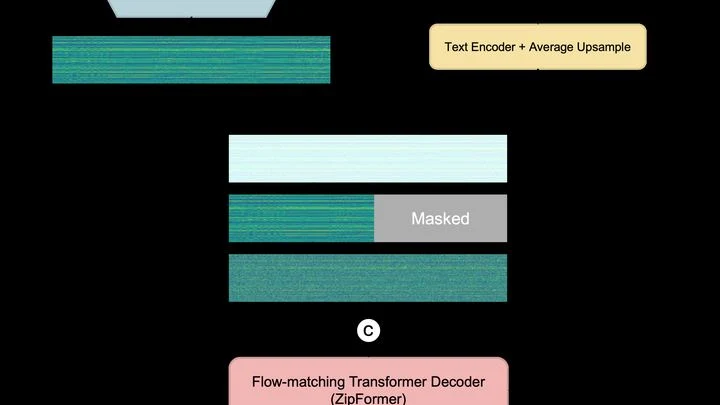
Faire parler un texte long, comme un livre audio, exigeait auparavant que l'ordinateur garde en tête une image extrêmement détaillée de chaque seconde de son — un peu comme s'il fallait dessiner un plan au millimètre pour une conversation d'une heure. Ces « cartes » étaient énormes, et même les machines puissantes s'essoufflaient à assembler la parole morceau par morceau.
Les aides auditives apprennent à goûter le son
Les aides auditives traditionnelles ressemblent à un cuisinier qui prépare une recette à l'aveugle. Elles analysent le désordre sonore entropique capté par le microphone et, sur cette base, amplifient la parole. Dans un café bruyant, cette approche se trompe souvent.
Comment un ordinateur apprend à entendre chacun dans une pièce bruyante
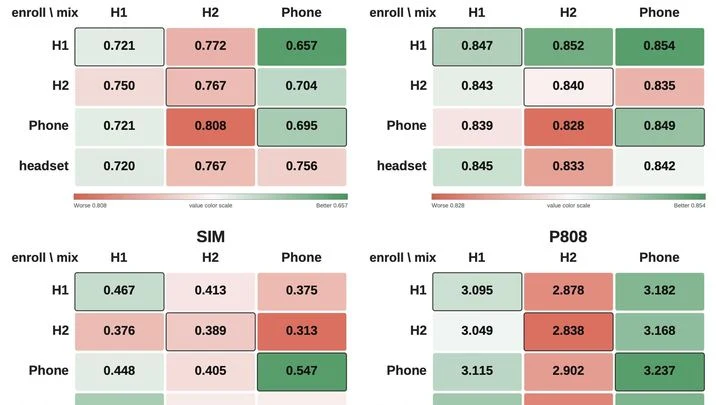
Dans une pièce bruyante, l'humain distingue la voix recherchée grâce à ses deux oreilles, qui perçoivent une différence dans l'arrivée du son. Un ordinateur équipé de plusieurs microphones agit de la même manière : il reçoit des indices spatiaux — d'où vient chaque voix.
Entendre l'inconnu : comment l'ordinateur apprend à capter tous les sons
L'oreille humaine se concentre sur ce qui lui est familier, mais ce nouveau système fonctionne autrement : il capte tout pic sonore, même celui qui n'a jamais été entendu auparavant. C'est la diarisation audio — pas simplement la recherche de bruits précis, mais le découpage de tout l'enregistrement en segments où l'on note le début et la fin de chaque événement.
Comment les écouteurs ont appris à voir la source du bruit
La réduction active du bruit crée un « anti-son » pour annuler le bruit. Mais les systèmes classiques sont aveugles : ils ne savent pas d'où vient le son. Dans les pièces avec écho, c'est comme boxer les yeux bandés — on atténue à l'aveugle.
Comment une IA sonore a perdu du poids
Un réseau neuronal qui génère des sons à partir de texte, c'est un peu comme une cuisine où chaque « plat » est préparé par des dizaines de cuisiniers. Beaucoup ne font que gêner : ils envoient des signaux erronés et gaspillent des ressources.
Comment l'IA a cessé de confondre les sons dans un scénario
Les modèles qui transforment le texte en audio reproduisent bien les sons isolés, mais se mélangent les pinceaux quand le scénario en comporte plusieurs. Par exemple, selon le scénario, on a d'abord une sonnerie, puis des pas, puis un claquement de porte. Le générateur peut intervertir les événements, et le spectateur entendra les pas avant la sonnerie.
Horizon musical : quand la chanson prend du volume
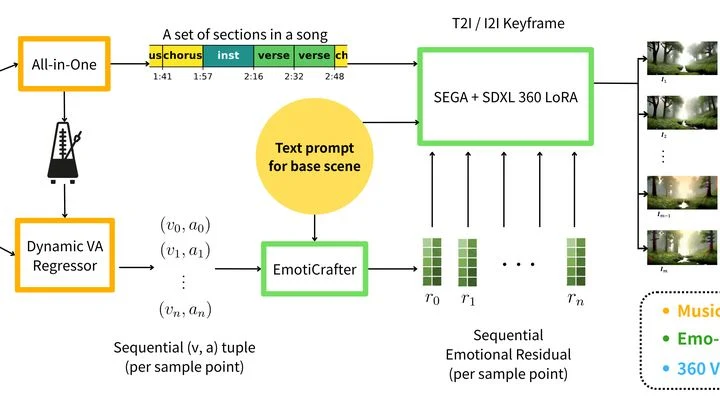
Le chef d'orchestre ne tient pas une baguette, mais un pinceau, et chaque mouvement fait naître couleur et forme. La nouvelle technologie fonctionne de la même manière : elle convertit l'ambiance d'une chanson en vidéo panoramique qui enveloppe l'auditeur. D'abord, l'algorithme, à l'instar de l'analyse de la lumière par spectroscopie, décompose le morceau en émotions.
Son2026-07-151 minarXiv:2607.13477express
Les juges IA n'écoutent pas avec leurs oreilles, mais avec des étiquettes
Les juges automatiques de la parole sont des algorithmes qui évaluent la prononciation et les émotions. Cependant, ils fonctionnent souvent comme un critique culinaire qui rend son verdict après avoir lu le menu, sans avoir goûté le plat.
Calcul et langage2026-07-151 minarXiv:2607.13721express
Un ordinateur évalue la prononciation sans indications
Apprendre une langue étrangère, c'est comme accorder un instrument de musique. La nouvelle technologie agit comme un accordeur intelligent : elle prend votre enregistrement et la parole de référence d'un natif, les étire ou les compresse dans le temps (comme on tend une corde) pour les aligner précisément, puis évalue trois paramètres clés : la pureté des sons, la…
Préparer une voix vivante : un jeu de données russe qui apprend aux assistants à ressentir
Les assistants vocaux font souvent penser à un cuisinier qui lit une recette sur un bout de papier sans la moindre once d'appétit. La nouvelle archive de dialogues russes « Dialogues » change la donne : trois comédiens en studio, tels des chefs, ont mixé 20 heures de conversations vivantes avec douze « épices » émotionnelles.
WanSong : des chansons nées du bruit en une seule étape
WanSong crée de la musique comme un sculpteur taille une statue : il part d'un bruit semblable au grondement d'une cascade et retire progressivement tout ce qui est superflu, jusqu'à ce que des notes pures et des voix émergent. Cette méthode — la diffusion d'entropie — transforme le chaos en ordre, un peu comme l'encre se disperse dans l'eau, mais en sens inverse.
Comment extraire la voix d'un ami du brouhaha d'une conversation
Un humain extrait sans effort la voix qu'il cherche du brouhaha d'une fête. Pour un ordinateur, c'est encore une tâche à la limite du possible. Les programmes précédents étaient entraînés sur des enregistrements stériles, sans écho ni tintement de couverts.
L'illusion de la précision : quand la validation de l'IA en acoustique induit en erreur
L'intelligence artificielle qui prédit l'acoustique d'une salle fait penser à un étudiant qui triche à l'examen avec une antisèche. Si les points de validation sont les mêmes que ceux de l'entraînement, le modèle se contente de mémoriser l'« empreinte » sonore de chaque position, comme un étudiant qui reconnaît un sujet grâce à un coin de page plié.