L'inférence bayésienne est une méthode mathématique pour estimer la probabilité d'une hypothèse sur la base de nouvelles observations. Elle nécessite trois composants : une probabilité a priori (degré de confiance initial dans l'hypothèse), une fonction de vraisemblance (probabilité des données si l'hypothèse est vraie) et une constante de normalisation (probabilité totale des données sous toutes les hypothèses possibles). Le résultat est la probabilité a posteriori — ce en quoi vous croyez après avoir pris en compte les indices. Contrairement aux statistiques classiques, l'approche bayésienne répond directement à la question « quelle est la probabilité que l'hypothèse soit vraie compte tenu de ces données ? », plutôt qu'à « quelle est la probabilité d'obtenir de telles données si l'hypothèse est vraie ? ».
Histoire
Le théorème de Bayes a été formulé pour la première fois dans un ouvrage posthume de Thomas Bayes (1763), puis indépendamment redécouvert et diffusé par Pierre-Simon Laplace en 1774. Laplace l'a appliqué à l'estimation de la masse de Saturne et à des études démographiques. Au XXe siècle, l'intérêt a été ravivé grâce aux travaux de Harold Jeffreys, qui a introduit des distributions a priori non informatives, et de Leonard Savage, qui a développé l'axiomatique de la probabilité subjective. Avec l'avènement de méthodes computationnelles puissantes, telles que l'algorithme de Metropolis-Hastings (1970) et l'échantillonnage de Gibbs, l'inférence bayésienne est devenue applicable à des modèles complexes dans les sciences des données.
Comment ça marche
L'inférence s'appuie sur le théorème de Bayes : P(H|D) = P(D|H) * P(H) / P(D), où H est l'hypothèse, D les données. P(H) (a priori) reflète le degré de confiance initial, P(D|H) (vraisemblance) — la probabilité d'obtenir les données D si H est vraie, P(D) — la probabilité marginale des données, jouant le rôle de normalisation. En pratique, le calcul direct du dénominateur, une intégrale sur toutes les hypothèses, est souvent impossible, et on recourt aux méthodes de Monte-Carlo par chaînes de Markov (MCMC) pour approximer la distribution a posteriori. Des logiciels modernes comme Stan et PyMC automatisent ces calculs.
En pratique
Les filtres anti-spam apprennent de vos marquages, les tests médicaux affinent le diagnostic en fonction de nouveaux symptômes.
Anecdote
Le briseur de code britannique Alan Turing a utilisé des méthodes bayésiennes pendant la Seconde Guerre mondiale pour déchiffrer « Enigma », en attribuant des probabilités aux différents réglages de la machine sur la base des messages interceptés.
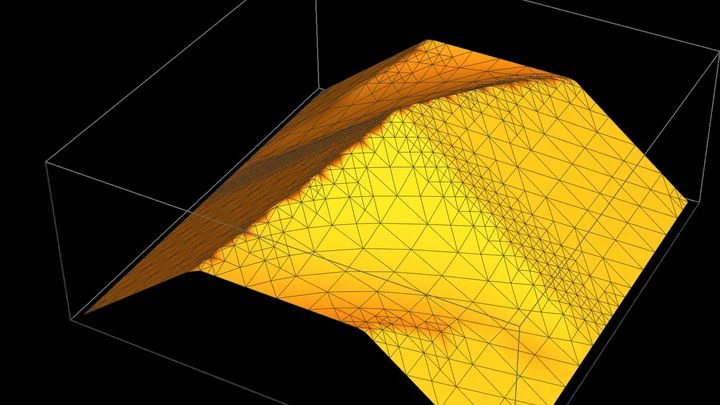
Dans un élastique étiré en laboratoire, trois mécanismes d'élasticité différents agissent simultanément. Pour une faible élongation, c'est la loi de Hooke qui domine ; pour une élongation moyenne, l'élasticité entropique des chaînes ; pour une forte élongation, le durcissement par cristallisation.
Un photographe immortalise un même paysage avec trois objectifs différents. Sur toutes les prises de vue, on voit la même chose, mais la douceur des détails, la netteté des contours et même la visibilité des petits objets varient d'un objectif à l'autre.
L'interprète se laisse distraire par le moindre bruit dans la salle, et une réunion d'une heure s'étire sur deux. C'est le même problème pour les modèles de fondation moléculaires : ils apprennent le langage des molécules sur d'immenses corpus, mais chaque nouvelle conversation exige un réglage.
Un ingénieur en protéines ressemble à un cuisinier qui essaie de préparer un plat à la fois savoureux, sain et économique. En modifiant un ingrédient, il risque d'en gâcher un autre. Autrefois, les assistants informatiques ne pouvaient évaluer les propriétés des protéines qu'individuellement, sans voir comment elles sont liées entre elles.
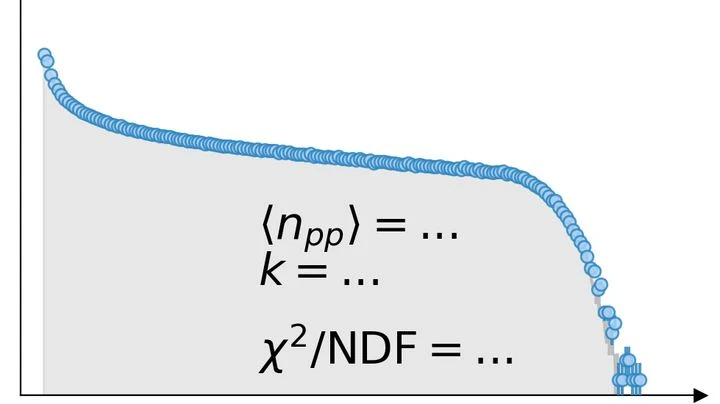
Lorsque deux noyaux lourds se percutent à une vitesse énorme, ils n'entrent pas en collision comme des boules de billard : seule une partie de leur matière entre en contact. Combien de nucléons (protons et neutrons) participent réellement à la collision, et combien passent à côté, on ne le sait pas à l'avance.
Dans un entrepôt, des cartons de pommes et de poires. Les pommes sont nombreuses, les poires rares. Mais quand le magasinier dit « un fruit à la peau lisse », nous pensons plus souvent à la poire rare qu'à la pomme fréquente. C'est l'effet de taux de base inversé : un dérèglement persistant dans la façon dont le cerveau résout l'ambiguïté entre les catégories.
Un « pied à coulisse » cosmique va bientôt mesurer une étoile à neutrons avec une précision d'une centaine de mètres. Pour un objet d'une vingtaine de kilomètres de diamètre, c'est comme mesurer l'épaisseur d'un cheveu humain à un kilomètre de distance.
Une étoile à neutrons est le vestige d'une supernova explosée.
La cellule d'amibe Dictyostelium rampe sur une lame de verre. Son chemin est enregistré : une chaîne de points sur un plan. Mais quelles forces la poussent ? À l'intérieur de la cellule, un moteur moléculaire travaille : les protéines tirent, la membrane fait ressort, l'eau exerce une pression.
Deux cents millions d'étoiles. Dans le centre de la Galaxie, où le futur relevé du télescope Nancy Grace Roman se concentrera, environ 250 fois au cours de la mission, la lumière de l'une d'elles vacillera sous une caresse invisible.
4 610 univers — c'est exactement le nombre de modèles cosmologiques qu'il a fallu aux astrophysiciens pour montrer que le masque gaussien ne fonctionne plus pour les données de nouvelle génération.
Reconstituer une image complète à partir de fragments, c'est un peu comme essayer de distinguer la mélodie d'un orchestre dans une salle bruyante. De telles tâches se posent en photométrie, où l'on reconstitue la luminosité d'une étoile à partir de faibles scintillements.
Les juges automatiques de la parole sont des algorithmes qui évaluent la prononciation et les émotions. Cependant, ils fonctionnent souvent comme un critique culinaire qui rend son verdict après avoir lu le menu, sans avoir goûté le plat.
Plongez votre regard dans le ciel nocturne : ce n'est pas un semis d'étoiles, mais un manuscrit à plusieurs couches. Sous l'encre brillante des étoiles et des galaxies transparaît un texte pâle, presque effacé.
Sur une carte topographique, les gouttes de pluie choisissent leur chemin : tombées sur un versant, elles s'écoulent vers la rivière A ; sur l'autre, vers la rivière B. L'observateur ne voit que les méandres des rivières (variables de réponse Y) et sait de quel versant provient l'eau (instrument Z), mais il ne voit pas les gouttes elles-mêmes (facteurs inobservés ε).
L'Univers n'est pas silencieux : il est parcouru d'un bourdonnement continu d'ondes gravitationnelles. Dans une décennie, l'observatoire spatial LISA accordera ses « oreilles » sur la gamme des millihertz, et notre Galaxie s'avérera être la source la plus riche — des dizaines de milliers de paires de naines…
Nous avons l'habitude de penser que ne remarquer que les confirmations de nos intuitions est une erreur. Mais des calculs récents, inspirés par le comportement des vagues, renversent ce point de vue. Il s'avère que l'habitude de chercher ce qui est familier est le meilleur moyen de réduire le bruit informationnel (les scientifiques l'appellent entropie).
Vue de l'extérieur, la croissance d'une population ressemble à un train qui prend de la vitesse : d'abord il avance péniblement, puis il accélère. Mais dès qu'on plonge dans les données, l'image se brouille. Dans une mesure, on compte une dizaine d'individus ; dans une autre, une centaine d'un coup.
Vous achetez une nouvelle balance de cuisine, mais au lieu d'un poids précis, elle n'affiche que l'écart par rapport à une « norme » quelconque. Pour connaître le poids d'une pomme, il faut d'abord peser des dizaines d'autres pommes et calculer la moyenne.
Un laboratoire envoie à un robot une liste de mille molécules candidates pour un nouveau médicament. Le robot-prédicteur, entraîné sur d'anciennes données, donne pour chacune une évaluation « convient – ne convient pas ». Mais lorsque la liste provient d'un domaine inconnu – un autre virus ou une tumeur rare – le robot commence à se tromper.
Un spectre, c'est un peu comme une photographie de la structure interne d'une substance, prise avec de la lumière. Lorsque le faisceau traverse l'échantillon ou s'y réfléchit, les molécules laissent sur ce cliché des bandes sombres caractéristiques : les pics. Mais si la photo est surexposée ou voilée de gris, distinguer les détails devient presque impossible.
Plongez votre doigt dans l'eau une seule fois — et, à partir de cette unique sensation, essayez de deviner sa température. Dans le monde quantique, de telles mesures uniques sont monnaie courante, sauf qu'il faut deviner des paramètres invisibles : par exemple, la force de compression d'un faisceau laser.
La recherche de vie sur des planètes lointaines, c'est comme diagnostiquer une maladie rare avec un test dont on ignore la précision. Un résultat positif isolé ne veut rien dire : et si c'était un faux positif ?
La main repose sur la table, et deux courtes vibrations arrivent au poignet, l'une après l'autre. Il faut dire laquelle est la plus forte. La tâche semble simple, mais la réponse dépend de la vibration qui vient en premier. Si la première est faible et la seconde forte, la différence paraît plus grande que lorsqu'on les inverse.
Un album contenant des centaines de photos de famille renferme de nombreuses histoires. Si l'on examine chaque cliché séparément, on pourrait facilement croire que l'oncle est un véritable géant : ce jour-là, il se tenait sur une marche plus haute que les autres. Mais en feuilletant tout l'album, on comprend vite que sa taille est tout à fait ordinaire, c'est juste que la marche apparaît sur quelques photos.
Dans le casque à travers lequel on écoute un orchestre lointain, un grésillement se fait entendre de temps en temps. Ce grésillement peut être si fort qu'il couvre la musique, ou même se fondre avec elle.
Lorsqu'un neutron ou un proton pénètre dans un noyau atomique, il se comporte comme une balle qui frappe un mur irrégulier : la rebond peut varier selon l'endroit où il touche.
Un couteau de cuisine et un économe, pris séparément, accomplissent des tâches différentes, mais lorsqu'un cuisinier apprend une nouvelle recette, il saisit souvent le même couteau pour tout. Il semble que le cerveau fasse de même lorsqu'il acquiert une nouvelle compétence de discrimination visuelle.
La lumière née au moment du Big Bang a voyagé vers nous pendant près de 14 milliards d'années. Mais en chemin, elle a traversé les champs gravitationnels des galaxies et des amas de matière noire, qui ont courbé ses rayons.
Pour comprendre un mécanisme, il faut le faire bouger. Un enfant qui démonte un réveil ne se contente pas de regarder les engrenages : il tourne la molette et écoute comment le tic-tac change. De même, les scientifiques, plutôt que d'observer passivement, envoient au système des signaux soigneusement choisis et observent la réponse.
Les étoiles situées en périphérie des galaxies tournent plus vite que ne le prévoient les lois de la physique si l'on ne compte que la matière visible. Ce paradoxe a été mis en évidence au XXe siècle par Vera Rubin et Fritz Zwicky.
Les vieux bulletins météo réservent des surprises : la colonne du thermomètre bondit soudain d'un demi-degré, non pas à cause du temps, mais parce que la station a changé d'instrument. Ces sauts brusques dans les données sont appelés points de changement, et les distinguer des véritables signaux climatiques est un défi que les statisticiens peinent à relever.
Le diagnostic génétique, c'est un peu comme comparer deux photos prises avec des appareils différents. Si l'un des appareils a légèrement décalé les couleurs, la photo révèle des « défauts » qui n'existent pas dans la réalité.
Une étoile à neutrons est une boule de la taille d'une ville, mais elle pèse autant qu'une fois et demie le Soleil. À l'intérieur d'une telle boule, la matière est si comprimée qu'une cuillère à café pèserait des milliards de tonnes. Mais de quoi est exactement faite cette matière, les physiciens ne le savent pas encore.
À l'intérieur d'une étoile à neutrons, la matière est comprimée à des densités inimaginables. Autrefois, les scientifiques spéculaient sur la façon dont tout cela était organisé, en passant en revue les équations possibles reliant la pression et la densité. La nouvelle approche écarte les conjectures : elle relie directement la masse et le rayon, mesurables, à la structure interne.
La Galaxie ressemble à une ville la nuit : la plupart des fenêtres brillent d'une lumière régulière, mais parfois un gratte-ciel s'illumine de toutes ses lumières puis s'éteint aussitôt.