Dans l'apprentissage entièrement supervisé, chaque image d'entraînement est accompagnée d'un masque ou d'une étiquette d'une précision au pixel près. À l'inverse, l'apprentissage faiblement supervisé utilise des étiquettes de qualité réduite : présence/absence d'un objet sur l'ensemble de l'image, un rectangle englobant approximatif au lieu d'un contour, des étiquettes au niveau d'un sac d'instances (on sait que l'ensemble contient des exemples positifs, mais lesquels exactement sont inconnus). L'algorithme doit alors inférer lui-même les détails en s'appuyant sur des caractéristiques récurrentes. Par exemple, si sur une centaine d'images étiquetées « chat », on trouve des moustaches et une courbure d'oreille caractéristique, le modèle associe ces traits à la classe, même sans connaître leur position exacte.
Histoire
Le concept remonte aux travaux sur le partially supervised learning des années 1990, mais il a été largement reconnu à partir des années 2010 grâce aux réseaux de neurones profonds. En 2015, un article influent intitulé « Weakly Supervised Learning with Deep Convolutional Neural Networks » a montré comment entraîner des classificateurs en n'ayant que des étiquettes d'images et non d'objets. Les méthodes d'apprentissage par instances multiples (Multiple Instance Learning – MIL), apparues dans les années 1990 dans le contexte de l'activité des molécules médicamenteuses, ont connu une seconde naissance. Aujourd'hui, l'apprentissage faiblement supervisé est un outil standard en imagerie médicale, en traitement du langage naturel et en analyse de séries temporelles.
Comment ça marche
Approche typique : un réseau de neurones reçoit une entrée X et produit des prédictions intermédiaires qui sont ensuite agrégées en une réponse finale correspondant à l'étiquette faible. Par exemple, pour la segmentation pixel par pixel d'une tumeur, le modèle génère une carte d'activation, et la moyenne sur tous les pixels est comparée à l'étiquette de l'image « sain/pathologique ». Les gradients se propagent à travers l'opération d'agrégation, forçant le modèle à mettre en évidence les régions pertinentes. Dans le MIL, le réseau de neurones apprend à prédire au niveau des « sacs » (paquets d'exemples) : on sait que le sac contient au moins un exemple positif, et le modèle le détecte en maximisant la différence entre les sacs. De plus, des modèles enseignant-élève sont utilisés, où les étiquettes faibles sont affinées de manière itérative.
En pratique
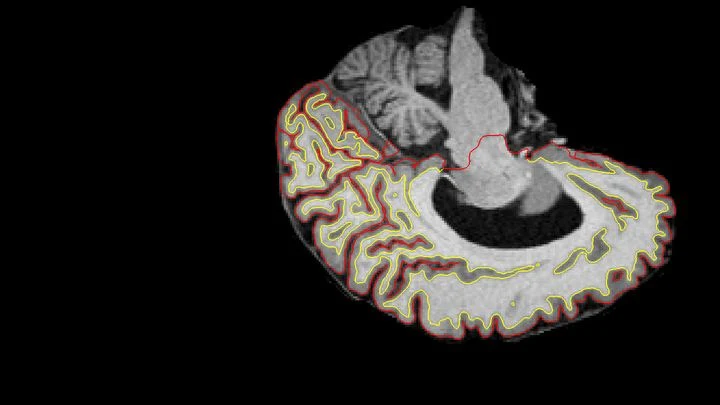
En médecine, cette approche permet d'économiser des heures de travail manuel : le médecin indique simplement d'un coup de pinceau la zone sombre sur l'image, et le programme trace automatiquement les contours de la tumeur pour le diagnostic.
Anecdote
L'apprentissage faiblement supervisé a permis de créer des modèles capables de classer des documents par catégories en utilisant pour l'entraînement uniquement des mots-clés, et non des phrases complètes.
Un radiologue regarde un scanner abdominal et voit non seulement des organes, mais aussi leur disposition mutuelle : quel rein est plus gros, où se trouve la tumeur par rapport au vaisseau. C'est comme lire une carte : il ne suffit pas de savoir où se trouve habituellement une ville, il faut aussi savoir mesurer la distance entre deux points sur le terrain.
Un ingénieur en protéines ressemble à un cuisinier qui essaie de préparer un plat à la fois savoureux, sain et économique. En modifiant un ingrédient, il risque d'en gâcher un autre. Autrefois, les assistants informatiques ne pouvaient évaluer les propriétés des protéines qu'individuellement, sans voir comment elles sont liées entre elles.
Vous cherchez des lucioles dans une forêt sombre. Au lieu de photographier toute la forêt chaque seconde et d'examiner ensuite les images, vous portez un petit appareil qui repère lui-même les éclairs et découpe dans l'image seulement un cercle autour de chacun. Le reste – l'obscurité – n'est pas enregistré. C'est exactement ce que fait le nouveau capteur pour caméras scientifiques.
Sous un microscope électronique, une protéine apparaît comme une série d'ombres floues — des centaines de milliers de clichés de la même molécule, mais sous des angles différents et avec un fort bruit.
En réanimation, la décision de la quantité de liquide à perfuser à un patient atteint de sepsis et de la dose de vasopresseur à administrer est prise chaque heure par le médecin. Une erreur dans un sens ou dans l'autre peut coûter la vie. Mais comment savoir quelle décision aurait été la meilleure ?
À l'intérieur d'un morceau d'aluminium, les atomes sont alignés en rangées régulières, comme des briques dans un mur. Mais parfois, une rangée s'arrête avant d'atteindre le bord – et une « marche » apparaît dans le cristal, ce que les physiciens appellent une dislocation.
Une tumeur sur une image, c'est comme un petit point lumineux sur une immense toile sombre. C'est précisément ce point que le médecin cherche, pas un fond parfaitement uniforme.
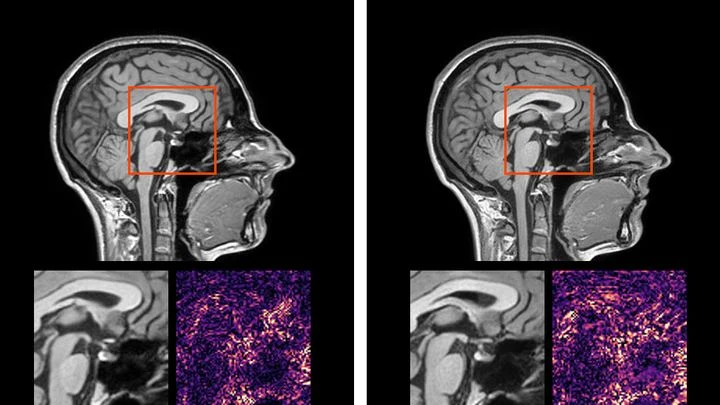
Deux images du même cerveau, prises à des moments différents, ressemblent à des photos d'une même maison avant et après rénovation. Pour comprendre ce qui a changé, on les superpose et on observe les différences.
Un médecin passe des années à apprendre à reconnaître les maladies sur les images du cerveau. D'abord, il repère parfaitement les signes du vieillissement, puis il maîtrise les tumeurs – et soudain, il se met à confondre ce qu'il savait auparavant. C'est à peu près ce qui arrive à de nombreux réseaux de neurones : les nouvelles connaissances effacent les anciennes.
Un lecteur de glycémie qui ne pique pas le doigt, mais se contente de regarder le poignet — c'est le rêve de millions de personnes diabétiques. C'est précisément ce que promettent les algorithmes qui extraient le niveau de glucose du signal de pouls ordinaire — le photopléthysmogramme (celui-là même qui mesure le pouls dans les montres connectées).
Dans chaque cellule, des rencontres et des séparations ont lieu en permanence. Certaines paires tiennent solidement, comme un scratch, d'autres se touchent à peine, comme du pollen porté par le vent.
Le faisceau de protons est comme une balle de tireur d'élite : il libère l'essentiel de son énergie en un point précis, sans presque toucher les tissus en entrée. Mais pendant les 4 à 6 semaines de traitement d'une tumeur de la tête et du cou, la cible se déplace : le patient maigrit, la tumeur se rétracte, la posture change. Le tireur visait un endroit, mais la cible a déjà bougé.
En assemblant le puzzle de l'Univers, les astronomes ont l'habitude que chaque nouvelle pièce s'emboîte parfaitement dans le tableau déjà constitué. Mais parfois, ils tombent sur des morceaux qui semblent découpés dans un autre jeu. Vingt mille noyau actif de galaxie — et onze pour cent d'entre eux, le réseau de neurones les rejette résolument comme étrangers.
4 610 univers — c'est exactement le nombre de modèles cosmologiques qu'il a fallu aux astrophysiciens pour montrer que le masque gaussien ne fonctionne plus pour les données de nouvelle génération.
En 2019, l'installation LIGO a enregistré une onde gravitationnelle — une ondulation dans le tissu de l'espace-temps — dont la carte temps-fréquence ressemblait à un peigne étrange. Chaque signal de fusion de trous noirs laisse une empreinte unique, comme des empreintes digitales.
Pour rendre la forme d'une statue dans ses moindres détails, on peut la découper en des millions de petits cubes et décrire chacun d'eux — c'est long, pénible, et la mémoire de l'ordinateur craque de toutes parts.
Une IA classique regarde les images médicales comme des puzzles faits de pièces inconnues : elle considère que deux images non appariées sont complètement différentes. C'est comme essayer de distinguer des jumeaux sans connaître leur lien de parenté. Or, en médecine, les patients atteints d'une même maladie présentent des IRM presque identiques, et l'algorithme se trompe en confondant les « parents ».
Reconstituer une image complète à partir de fragments, c'est un peu comme essayer de distinguer la mélodie d'un orchestre dans une salle bruyante. De telles tâches se posent en photométrie, où l'on reconstitue la luminosité d'une étoile à partir de faibles scintillements.
Le radar, telle une chauve-souris dans une grotte, envoie une impulsion et écoute l'écho. Mais dans le récepteur, un déséquilibre microscopique est inévitable : il brouille les fréquences et crée pour chaque cible un double fantôme, comme un second écho légèrement déformé.
Habituellement, ces fantômes gênent et on les élimine à l'avance.
L'algorithme d'amélioration de photos ressemble à un GPS qui guide pas à pas une image floue vers une version nette. Le bruit et les distorsions, il les élimine en se déplaçant de pixel en pixel sur une carte familière. Mais si le cliché est pris dans des conditions inconnues — par exemple avec un flai inhabituel — la carte ne correspond pas au terrain.
La caméra à pixel unique évoque un artiste qui peint à travers un pochoir percé de nombreux trous. Chaque prise de vue ne laisse passer qu'une partie du flux lumineux, puis l'ordinateur assemble ces fragments pour reconstituer une image complète. Autrefois, l'ordre des masques était immuable, comme si l'artiste utilisait toujours le même pochoir sans jamais regarder son sujet.
Les juges automatiques de la parole sont des algorithmes qui évaluent la prononciation et les émotions. Cependant, ils fonctionnent souvent comme un critique culinaire qui rend son verdict après avoir lu le menu, sans avoir goûté le plat.
La jungle de béton urbaine met les drones dans la position d'une chauve-souris aveuglée. Les caméras perdent la vue à chaque coin de rue, le GPS s'égare entre les gratte-ciel, et les ondes radio se dispersent en cent échos.
Apprendre une langue étrangère, c'est comme accorder un instrument de musique. La nouvelle technologie agit comme un accordeur intelligent : elle prend votre enregistrement et la parole de référence d'un natif, les étire ou les compresse dans le temps (comme on tend une corde) pour les aligner précisément, puis évalue trois paramètres clés : la pureté des sons, la…
Le cerveau communique par de brefs clics électriques. Autrefois, pour apprendre cette langue, il fallait des milliers d'exemples traduits par l'expérimentateur. La méthode MOJO suit une autre voie : comme dans l'apprentissage par immersion, elle écoute d'abord le « flux de conscience » sans aucune indication et repère elle-même les motifs récurrents.
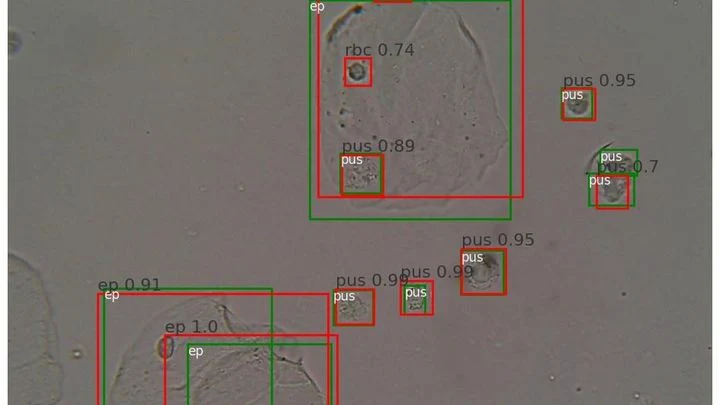
Une goutte d'urine sous le microscope n'est pas une flaque plate, mais un volume multicouche. Comme une pile de pages transparentes : si l'on regarde une page, les voisines sont floues. Ainsi, la lumière du microscope ne montre nettement qu'une seule couche de profondeur.
L'approche standard pour une classe de problèmes d'apprentissage automatique évoque un ressort étiré qu'on oublie de relâcher : les méthodes standard gonflent artificiellement la taille du problème, transformant les calculs en trou noir pour la mémoire et le temps.
L'IA diagnostique apprend comme un étudiant en médecine avant l'examen. On lui donne une radiographie et les plaintes du patient. Mais parfois, parmi les supports de cours, se glisse le rapport complet du médecin — la réponse toute faite. Le réseau neuronal la mémorise, et sa précision au test bondit à 98 %. Mais c'est de la triche : la vraie compétence ne se développe pas.
Les données d'un seul scan CT équivalent à plusieurs longs métrages. TCAM-Diff contourne ce goulot d'étranglement : le programme compresse la vue tridimensionnelle en trois projections d'ombre, un peu comme un sculpteur qui reconstituerait une statue à partir de ses silhouettes sur trois murs.
Habituellement, un scanner CT prend de nombreuses radiographies sous différents angles et assemble une image en trois dimensions. Mais parfois, les médecins ne scannent qu'une petite zone — par exemple un seul poumon — et les données sont tronquées. C'est comme si l'on donnait à un chef une cuillère de soupe à goûter et qu'on lui demandait de donner la recette exacte de toute la casserole.
Lorsqu'une étoile géante s'effondre en supernova ou que deux étoiles à neutrons fusionnent dans une danse cosmique, des billions de neutrinos emportent l'énergie du cataclysme.
Une photo numérique brute ressemble à une mosaïque : chaque pixel ne stocke qu'une couleur de base — rouge, verte ou bleue. Pour compresser un tel fichier, on le sépare en luminosité (l'image détaillée en noir et blanc) et en composante chromatique.
Dans une pièce bruyante, l'humain distingue la voix recherchée grâce à ses deux oreilles, qui perçoivent une différence dans l'arrivée du son. Un ordinateur équipé de plusieurs microphones agit de la même manière : il reçoit des indices spatiaux — d'où vient chaque voix.
Quand vous tapez « salade » et que le clavier propose « césar », en coulisses, des millions de téléphones apprennent ensemble à prédire les mots. Ils n'échangent pas vos messages, mais seulement les améliorations de l'algorithme commun — comme un entraîneur qui envoie aux athlètes uniquement les changements au programme : « ajoutez 5 pompes à ceux d'hier ».
Des chercheurs ont pris 16 activités quotidiennes — de la vaisselle aux squats — et ont décomposé les mouvements en composantes élémentaires, un peu comme un spectroscope décompose la lumière en spectre. En comparant trois approches, ils ont trouvé une clé inattendue pour la reconnaissance : une simple image moyenne suffit.
Le flotteur dans la chasse d'eau est un contrôleur idéal : en sentant le niveau de l'eau, il ramène instantanément le système à l'équilibre sans se soucier du passé. Des ingénieurs ont appliqué ce principe aux réseaux de neurones.
Un grand réseau de neurones, comme Whisper, maîtrise des centaines de langues et ressemble au modèle standard de l'univers : tout est équilibré. Mais l'apprentissage d'une langue rare rompt cet équilibre — elle se transforme en trou noir qui attire toutes les ressources d'apprentissage.
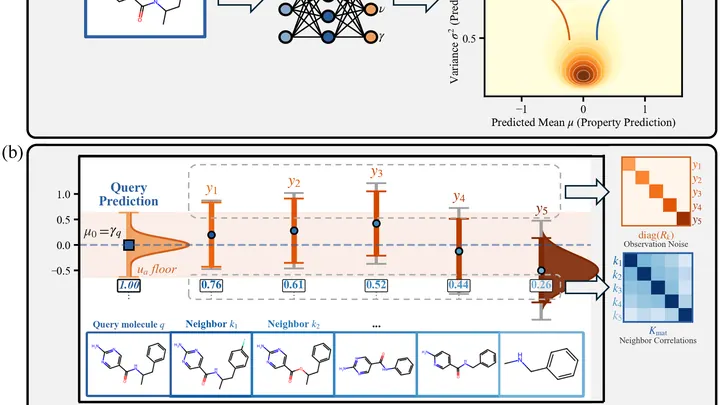
Prédire les propriétés d'une nouvelle molécule, c'est un peu comme deviner le goût d'un plat inconnu. Le programme agit comme un chef expérimenté : il « goûte » des molécules similaires dont les propriétés sont déjà connues et, en se basant sur leur « saveur », affine son estimation.
Pendant longtemps, identifier les phases quantiques ressemblait à un interrogatoire : il fallait explorer chaque recoin du système pour en soutirer le secret. À l'époque de Lev Landau, l'ordre était lié à la brisure de symétrie et à un paramètre local — tout était clair comme de l'eau de roche.
L'apprentissage automatique n'est plus depuis longtemps un simple outil — il devient un chercheur qui extrait lui-même les lois de la nature à partir des données. Mais comment un esprit de silicium parvient-il à la compréhension ?