L'apprentissage auto-supervisé est un paradigme dans lequel le modèle génère des signaux d'apprentissage en les extrayant de la structure même des données non étiquetées. Contrairement à l'apprentissage non supervisé, qui se concentre souvent sur le clustering ou la réduction de dimensionnalité, on construit ici des tâches substitutives (pretext tasks) ne nécessitant pas d'annotations humaines. Par exemple, en traitement du langage naturel, une partie des mots d'une phrase d'entrée est masquée, et le réseau apprend à les reconstituer à partir du contexte. En vision par ordinateur, les méthodes contrastives sont populaires : deux versions aléatoirement déformées d'une même image sont « rapprochées » dans l'espace des représentations, tandis qu'elles sont « éloignées » des autres images. Cela forme une notion visuelle rappelant la manière dont les nourrissons extraient les objets de l'arrière-plan.
Histoire
Les idées d'auto-contrôle remontent aux travaux sur les auto-encodeurs (Hinton, 2006) et à l'apprentissage de représentations par reconstruction. Le moment décisif fut 2018 avec l'apparition de BERT (Devlin et al.), utilisant le masquage de mots. Pour les images, en 2020, la méthode SimCLR (Chen et al.) a montré qu'un schéma contrastif simple avec de grandes tailles de batch est comparable à l'apprentissage supervisé. Plus tard, les Vision Transformers combinés au codage automatique masqué (MAE) ont reproduit le succès du NLP, démontrant la scalabilité.
Comment ça marche
Le schéma général du SSL comprend : 1) une tâche prétexte — génération automatique du signal cible ; 2) un encodeur extrayant les représentations ; 3) éventuellement un projecteur pour la mise en correspondance des métriques ; 4) une fonction de perte résolvant la tâche prétexte spécifique. En NLP : langage masqué (MLM) — tâche de reconstruction des tokens cachés. Le modèle reçoit une séquence avec des masques [MASK] et apprend à prédire les mots originaux via l'entropie croisée. En CV : les méthodes contrastives apprennent des représentations invariantes aux augmentations, en utilisant de grandes tailles de batch et un mécanisme d'encodeur momentum pour la stabilisation. Les récents auto-encodeurs masqués (MAE) masquent des patchs aléatoires de l'image, et le décodeur reconstruit les pixels, forçant le modèle à comprendre la structure globale des objets.
En pratique
Systèmes de reconnaissance vocale, traducteurs automatiques, tous les grands modèles de langage modernes (comme GPT), diagnostic médical à partir d'images sans annotations de médecins.
Anecdote
Après un apprentissage auto-supervisé sur des textes, le modèle GPT-3 s'est révélé capable d'écrire des poèmes, du code et des essais scientifiques, bien que personne ne le lui ait spécifiquement enseigné.
Un radiologue regarde un scanner abdominal et voit non seulement des organes, mais aussi leur disposition mutuelle : quel rein est plus gros, où se trouve la tumeur par rapport au vaisseau. C'est comme lire une carte : il ne suffit pas de savoir où se trouve habituellement une ville, il faut aussi savoir mesurer la distance entre deux points sur le terrain.
Dans un immeuble de neuf étages, avec mille pièces à chaque niveau, certains chuchotent, d'autres crient. Les voisins transmettent les paroles, mais si tout le monde parle trop bas, le message s'éteint dès le troisième étage. S'ils parlent trop fort, il devient un rugissement inintelligible au dernier étage. Entre ces extrêmes, il existe un régime où le chuchotement parvient jusqu'en haut sans distorsion.
Dans la glace antarctique, une particule fantôme ne laisse qu'un faible éclat de lumière bleue. Le détecteur IceCube capture ces éclats, et à partir d'eux, il faut déterminer d'où vient la particule. Le modèle PolarBERT a appris à le faire, mais ce qu'il voit réellement à l'intérieur restait un mystère.
Un interprète simultané dans une salle où deux personnes parlent : il doit suivre à la fois le sens et l'intonation, mais si le débit est trop rapide, il ne reste que le résumé.
Une molécule d'ADN, coincée dans une minuscule fente métallique, tremble et scintille sous le laser. Son signal n'est pas une ligne claire de lettres, mais un mélange chaotique d'éclairs et d'ombres. Déchiffrer ce bruit, c'est comme essayer de comprendre un murmure dans une salle bondée.
Le nouveau réseau de neurones agit comme un interprète attentif.
La recherche d'un nouveau matériau ressemble à la cuisine sans recette : on essaie, on essaie, et souvent on jette. Avant, les scientifiques feuilletaient les articles à la main et testaient les compositions une par une. Maintenant, un « robot-cuisinier » est apparu, qui lit lui-même la littérature, mélange les composants et regarde ce que ça donne.
L'orchestre joue, mais les musiciens ne s'entendent pas. Le chef interrompt sans cesse la musique et s'approche de chacun pour accorder son instrument. C'est à peu près ainsi que fonctionnent les télescopes spatiaux à miroir segmenté.
L'appareil à rayons X prend un cliché, et le médecin ne voit que des chiffres — densité osseuse, pourcentage de graisse. Mais l'image recèle bien plus. Une équipe de chercheurs a créé le modèle LeDXA, qui lit ces clichés comme une carte des signaux cachés du corps.
Le modèle a appris sur 11 540 clichés du projet « Phénotype humain » sans la moindre légende.
Dans un four, quand la température augmente, les molécules se déplacent plus vite et le désordre s'accroît. Avec les modèles de langue comme ChatGPT, c'est tout l'inverse. Lorsque les développeurs augmentent le paramètre « température », le modèle accède à un choix de mots plus large, mais ses textes longs se figent soudainement.
Le magnétoencéphalographe, un appareil qui ressemble à un casque muni de centaines de capteurs, capte les faibles champs magnétiques produits par les neurones en activité. Lorsqu'une personne écoute de la parole, ces signaux renferment des empreintes des mots entendus.
Le cerveau ne se contente pas de réagir au monde – il ne cesse de deviner ce qui va se passer l'instant d'après. Ce principe porte le nom de codage prédictif : les neurones comparent leurs attentes à la réalité et mettent à jour leur représentation interne lorsqu'une erreur survient. Mais comment un système aussi complexe peut-il être organisé dans le tissu vivant du cortex ?
Un réseau de neurones prédit l'avenir d'un système — par exemple, comment le plasma va tourbillonner dans un champ magnétique ou comment un visage va changer dans une vidéo. Les erreurs sont inévitables, et plus il regarde loin, plus elles s'accumulent.
L'esprit humain ressemble à un jeu de construction qui s'auto-construit. Les nouvelles idées ne meurent pas avec leur créateur : elles se transmettent, se mélangent et sont sélectionnées. Ce processus est appelé évolution culturelle : les inventions utiles se consolident, les inutiles tombent dans l'oubli. C'est le principe du cliquet, ce mécanisme qui ne tourne que dans un sens.
Une prothèse oculaire transmet au cerveau non pas une photographie, mais un pointillé clairsemé de points lumineux — les phosphènes. Pour distinguer une tasse ou des clés dans ce scintillement, la personne doit balayer la tête comme une lampe de poche dans l'obscurité et assembler petit à petit les contours de l'objet.
Deux cent quarante-deux mille trois cent vingt-sept galaxies — comme des grains de sable sur une plage. Mais les astronomes ont transformé ce chaos en carte : l'algorithme UMAP a pris de chaque galaxie onze paramètres — sept couleurs de l'optique au moyen infrarouge (c'est la…
Reconstituer une image complète à partir de fragments, c'est un peu comme essayer de distinguer la mélodie d'un orchestre dans une salle bruyante. De telles tâches se posent en photométrie, où l'on reconstitue la luminosité d'une étoile à partir de faibles scintillements.
Les caméras d'une voiture autonome captent la lumière, telles des télescopes pointés vers une lointaine galaxie. Chaque image est une observation fragmentaire ; ensemble, elles doivent former une carte du chemin.
De nombreux processus naturels sont décrits par des équations, mais nous n'en connaissons que des fragments. La nouvelle méthode agit comme un cartographe qui, à partir de quelques repères, reconstitue une carte complète du territoire.
Une visite guidée avec un seul robot, c'est un monologue fatigant où l'on n'a personne avec qui échanger un regard. Les chercheurs ont transformé ce one-man-show en une scène vivante : au robot-guide réel s'est ajoutée une hologramme-partenaire.
Un programme de suivi ordinaire ressemble à un navigateur qui guide un navire à l'aide des étoiles. Mais dès que le ciel se couvre, les coordonnées dérivent et l'incertitude dans les données augmente — c'est ce qu'on appelle l'entropie. Le nouvel algorithme s'adjoint un « copilote » : un module qui surveille le niveau de confiance du navigateur principal.
Vous êtes sous la douche : vous tournez le robinet, et l'eau est tantôt glacée, tantôt brûlante. Les tuyaux vivent leur vie – la pression varie de façon imprévisible. Le nouveau contrôleur apprend au fur et à mesure : il ne connaît pas le circuit d'eau, mais en quelques minutes il s'adapte et amène la température à un niveau confortable, sans franchir les seuils de sécurité.
L'approche standard actuelle de l'apprentissage de l'IA ressemble à un enfant enfermé dans une bibliothèque : il mémorise des millions de livres, mais ignore que le feu brûle et que la chute fait mal.
Apprendre une langue étrangère, c'est comme accorder un instrument de musique. La nouvelle technologie agit comme un accordeur intelligent : elle prend votre enregistrement et la parole de référence d'un natif, les étire ou les compresse dans le temps (comme on tend une corde) pour les aligner précisément, puis évalue trois paramètres clés : la pureté des sons, la…
Après qu'une pierre a été jetée, les cercles à la surface de l'eau disparaissent, mais le liquide conserve des vibrations microscopiques. Le moindre souffle – et la ride renaît. Les réseaux de neurones se comportent de manière similaire.
Le cerveau communique par de brefs clics électriques. Autrefois, pour apprendre cette langue, il fallait des milliers d'exemples traduits par l'expérimentateur. La méthode MOJO suit une autre voie : comme dans l'apprentissage par immersion, elle écoute d'abord le « flux de conscience » sans aucune indication et repère elle-même les motifs récurrents.
Dans une casserole de soupe, deux thermomètres suffisent pour connaître la température partout — à condition de savoir que la chaleur se propage en cercles depuis le fond. De même en science : à partir de mesures éparses, il faut reconstruire l'image complète du champ thermique.
Pendant longtemps, les biologistes ont étudié les cellules en n'écoutant qu'une seule voix dans un chœur polyphonique : par exemple, ils mesuraient l'activité des gènes en ignorant comment l'ADN était empaqueté. C'est comme essayer de comprendre une conversation en ne connaissant qu'une seule langue.
Les juges automatiques de la parole sont des algorithmes qui évaluent la prononciation et les émotions. Cependant, ils fonctionnent souvent comme un critique culinaire qui rend son verdict après avoir lu le menu, sans avoir goûté le plat.
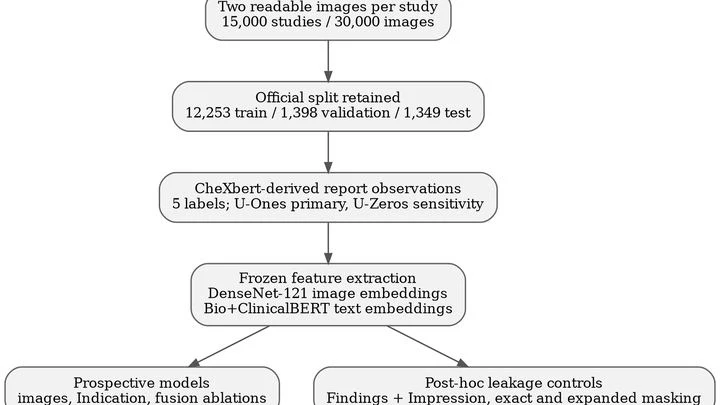
L'IA diagnostique apprend comme un étudiant en médecine avant l'examen. On lui donne une radiographie et les plaintes du patient. Mais parfois, parmi les supports de cours, se glisse le rapport complet du médecin — la réponse toute faite. Le réseau neuronal la mémorise, et sa précision au test bondit à 98 %. Mais c'est de la triche : la vraie compétence ne se développe pas.
Un enfant qui explore un appartement inconnu rampe d'un objet à l'autre et mémorise ce qu'il voit depuis chaque coin. C'est ainsi que le cerveau construit une carte mentale — un modèle interne de l'espace. L'algorithme gradCSCG fonctionne sur le même principe : il reçoit un flux vidéo d'une caméra et dessine lui-même le plan du lieu, en s'appuyant uniquement sur le changement des images.
Les aides auditives traditionnelles ressemblent à un cuisinier qui prépare une recette à l'aveugle. Elles analysent le désordre sonore entropique capté par le microphone et, sur cette base, amplifient la parole. Dans un café bruyant, cette approche se trompe souvent.
Une personne dans une barque tourne en déplaçant le poids de son corps. Un navire autonome utilise la même astuce : la manœuvre est effectuée par une masse mobile à l'intérieur de la coque. Son mouvement est contrôlé par un réseau de neurones qui anticipe le chaos des vagues et les rafales de vent.
Les étoiles à neutrons sont les derniers agrégats de matière visible avant la chute dans un trou noir. Dans leurs entrailles, la matière est comprimée à des densités de l'ordre du billion. Là, les forces nucléaires et la gravité s'entrelacent pour former une substance exotique inaccessible à tout accélérateur terrestre.
Les systèmes électriques équipés de panneaux solaires et d'éoliennes ressemblent à une partie d'échecs : la couverture nuageuse et les variations de charge sont des coups de l'adversaire impossibles à prévoir. Pour maintenir l'équilibre, les opérateurs devaient auparavant évaluer des dizaines de scénarios (incertitude) — ce qui demandait trop de temps et de calculs.
Imaginez un conducteur sur une route verglacée : il ne connaît pas la réaction exacte de sa voiture aux mouvements du volant et doit apprendre en conduisant, en gardant intuitivement une marge de manœuvre pour une éventuelle erreur. C'est ainsi que fonctionne un algorithme de contrôle adaptatif.
En général, les algorithmes apprennent à agir dans des conditions prédéfinies, comme l'eau qui coule dans un lit déjà creusé. La nouvelle méthode renverse cette logique : elle permet au système d'apprendre à la fois à agir et à modifier son environnement.
Dans une pièce bruyante, l'humain distingue la voix recherchée grâce à ses deux oreilles, qui perçoivent une différence dans l'arrivée du son. Un ordinateur équipé de plusieurs microphones agit de la même manière : il reçoit des indices spatiaux — d'où vient chaque voix.
Un cuisinier qui apprend à cuisiner avec des images dessinées risque de rater chaque plat. Le même piège attend la vision par ordinateur : les modèles ont besoin de milliers d'images annotées, mais les collecter à la main est coûteux et fastidieux. Les images synthétiques résolvent le problème, à condition qu'elles ressemblent à de vraies.