Le bond des réseaux de neurones : KLT-Net repense l'échelle des distances cosmiques ✛ ✎
Contexte
La cosmologie moderne est confrontée à une crise : les mesures locales de la constante de Hubble à partir des supernovae et des céphéides donnent environ 73 km/s/Mpc, tandis que les contraintes globales du fond diffus cosmologique dans le cadre du modèle ΛCDM standard indiquent 67 km/s/Mpc. Cet écart d'environ 5σ, connu sous le nom de « tension de Hubble », pourrait signaler une nouvelle physique, des erreurs systématiques ou des effets non pris en compte dans la construction de l'échelle des distances cosmiques. Pour éliminer la dépendance aux modèles, les chercheurs se tournent de plus en plus vers des méthodes d'apprentissage profond capables de capturer des distributions non linéaires complexes dans les données de photométrie et de spectroscopie des supernovae de type Ia — des chandelles standard visibles à de très grands décalages vers le rouge.
Méthodes
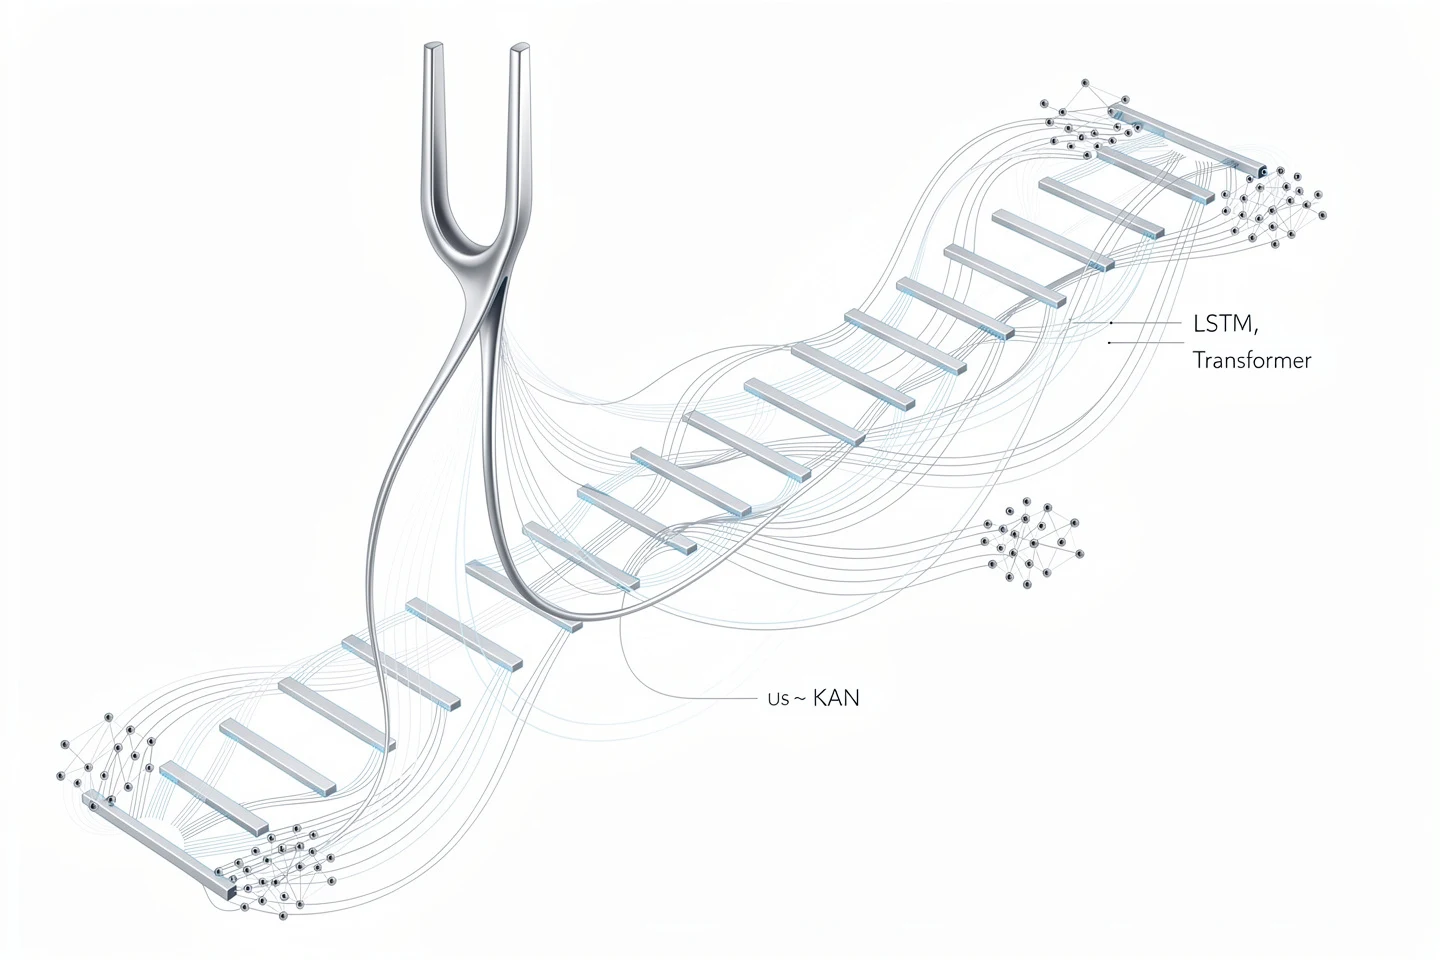
Les chercheurs ont construit un réseau neuronal hybride KLT-Net, inspiré du théorème de Kolmogorov-Arnold, et l'ont entraîné sur les données Pantheon+ (1701 courbes de lumière) sans référence à un modèle cosmologique spécifique. L'architecture combine trois composants : des couches LSTM pour capturer les dépendances temporelles locales dans les séries de grandeurs observées ; des couches KAN avec des B-splines entraînables qui approximent efficacement les non-linéarités multidimensionnelles avec un petit nombre de paramètres ; et un encodeur Transformer avec mécanisme d'auto-attention pour la modélisation contextuelle globale de toute l'histoire de l'expansion. En sortie, le réseau prédit le module de distance µ(z) à partir du décalage vers le rouge d'entrée. Pour estimer la magnitude absolue des supernovae $M_B$, on a appliqué la méthode robuste de la valeur la plus fréquente (MFV) avec erreurs bootstrap. Les paramètres cosmologiques H₀ et Ωₘ ont été déduits par échantillonnage bayésien MCMC en supposant un modèle ΛCDM plat et en utilisant les équations de Friedmann. La robustesse des résultats a été vérifiée via la matrice de Hess et des expériences d'ablation avec désactivation de composants individuels.
Résultats
Les tests d'ablation sur dix initialisations aléatoires ont montré que le KLT-Net complet atteint la plus faible variance de l'erreur quadratique moyenne ($σ_{MSE}$ = 0.559×10⁻³), ce qui est crucial pour supprimer les fluctuations aléatoires du µ(z) reconstruit et, par conséquent, pour la stabilité des estimations de la constante de Hubble. Bien que la variante sans LSTM (KT) ait donné une MSE moyenne légèrement meilleure (0.016089), KLT-Net a démontré la plus grande robustesse aux poids initiaux aléatoires. Les métriques finales du modèle complet : MSE = 0.015727, RMSE = 0.125409, MAE = 0.098847. Avec MFV, on obtient $M_B$ = –19.3772⁺⁰.⁰²⁴⁷₋₀.₀₁₂₂ (1σ). L'analyse bayésienne a donné H₀ = 69.576⁺⁰.⁴⁸³₋₀.₄₈₂ km/s/Mpc et Ωₘ = 0.301⁺⁰.⁰³⁹₋₀.₀₃₆, ce qui est cohérent avec les estimations par minimisation du χ² et la matrice de Hess (68.718±0.352 km/s/Mpc pour les données Pantheon originales). L'écart dans Ωₘ entre les données directes et les prédictions du réseau (0.349 contre 0.301) s'explique par le lissage des caractéristiques à haute latitude par le réseau neuronal.
Implications
Ce travail démontre que l'intégration de blocs KAN avec des splines adaptatives améliore l'interprétabilité et l'efficacité des réseaux de neurones dans les tâches d'inférence cosmologique. Contrairement aux architectures purement LSTM, KLT-Net atténue considérablement l'instabilité de l'entraînement, réduisant le risque d'artefacts lors de l'échantillonnage bayésien des paramètres de l'énergie noire et de la matière noire. Cette approche ouvre la possibilité d'une validation croisée indépendante du modèle cosmologique standard et d'un apaisement de la tension de la constante de Hubble grâce à une prise en compte plus fiable des systématiques.
Développements futurs
La direction évolue naturellement vers les réseaux de neurones « informés par la physique » (Physics-Informed Neural Networks), où les équations dynamiques de Friedmann ou les principes d'évolution de la luminosité sont intégrés dans l'architecture. Des schémas hybrides ont déjà été proposés, combinant la régression symbolique avec le respect des dimensions et de grands modèles de langage pour la dérivation automatique des équations d'état de l'énergie noire ou de la gravité modifiée. Cela permettrait de minimiser les hypothèses a priori et de se rapprocher d'une extraction complète des lois physiques à partir des données.
Impact
La méthode aura un impact direct sur le traitement des futurs grands relevés photométriques et spectroscopiques (LSST, Euclid, Roman), où des méthodes de reconstruction des distances robustes au bruit et aux données manquantes sont nécessaires. De plus, elle trouvera des applications en astrophysique stellaire et galactique pour la prédiction de paramètres à partir de courbes de lumière et de spectres.
Prochaines étapes
Validation de KLT-Net sur des données simulées avec des systématiques réalistes et combinaison avec des méthodes d'apprentissage par transfert pour l'adaptation à de nouveaux instruments. Un intérêt particulier réside dans l'extension de l'architecture aux cosmologies anisotropes et l'analyse conjointe des supernovae, des oscillations acoustiques des baryons et de la nucléosynthèse primordiale.
Problèmes ouverts clés
L'article aborde directement la « tension de Hubble » — l'un des problèmes les plus aigus de la physique moderne — en proposant une voie indépendante du modèle pour reconstruire l'échelle des distances et estimer H₀. De plus, il touche à la question de la nature de l'énergie noire et de l'incomplétude possible du modèle cosmologique standard.
Le regard de la machine du savoir
Cette section s'adresse à l'auteur du travail et à ses collègues. Les travaux voisins ont été trouvés par une recherche sémantique dans notre archive, et non par correspondance de mots. Nous n'évaluons pas : nous montrons le champ autour.
Ce que fait ce travail
Vous avez entraîné le réseau de neurones hybride KLT-Net sur les données Pantheon+ pour reconstruire le module de distance μ(z) sans supposer de modèle cosmologique, en combinant des couches LSTM, KAN et Transformer. Grâce à la méthode robuste MFV, vous avez estimé la magnitude absolue des supernovae M_B, puis, par une analyse bayésienne dans le cadre du modèle ΛCDM plat, vous avez obtenu H₀ = 69.576⁺⁰.⁴⁸³₋₀.₄₈₂ km/s/Mpc et Ωₘ = 0.301⁺⁰.⁰³⁹₋₀.₀₃₆. Les tests d'ablation ont montré que le modèle complet présente la plus faible variance MSE, ce qui assure la stabilité des estimations.
Où est sa force
KLT-Net fait preuve d'une grande robustesse face aux poids initiaux aléatoires et parvient à capturer des systématiques subtiles dans les données sans modélisation explicite, ouvrant ainsi la voie à une réduction de la dépendance aux hypothèses sur la physique des supernovae.
Vers où avancer
- Il pourrait être intéressant de confronter votre approche avec des mesures indépendantes de H₀ par ondes gravitationnelles : il existe dans les archives un travail où le taux d'expansion est estimé à partir d'événements de fusion d'étoiles à neutrons, ce qui fournit une vérification croisée des systématiques.appui : Les ondes gravitationnelles mesurent la vitesse d'expansion de l'Univers arXiv:2605.27227
- À proximité se trouve une analyse des données Pantheon+ utilisant des « jumelles » de supernovae pour calibrer la luminosité — votre réseau pourrait peut-être bénéficier de l'inclusion de telles paires dans l'ensemble d'entraînement.appui : La vitesse d'expansion de l'Univers précisée grâce aux « jumelles » parmi les supernovae arXiv:2512.02391
- Dans les archives, il y a une mesure récente de la constante de Hubble basée sur l'écho des supernovae, qui s'appuie également sur Pantheon+ ; comparer les prédictions de votre modèle sur les mêmes objets pourrait révéler quelles caractéristiques des courbes de lumière le réseau considère comme les plus informatives.appui : L'écho des supernovae : une nouvelle mesure de la constante de Hubble arXiv:2606.25205
À essayer
- Essayez d'ajouter à l'architecture une couche qui tienne compte des corrélations entre les supernovae d'une même galaxie, afin de vérifier si la dispersion résiduelle diminue.
- Entraînez KLT-Net sur des courbes de lumière simulées avec des systématiques connues et vérifiez si le réseau les récupère sans indication explicite.
- Appliquez la méthode SHAP ou une méthode similaire pour interpréter la contribution des différentes parties de la courbe de lumière à la prédiction de μ(z) et comparez avec les phases connues importantes pour la standardisation.
Pourquoi cela peut compter
Si les méthodes par réseaux de neurones parviennent à réduire de manière fiable les systématiques dans l'échelle des distances, cela nous rapprochera de la résolution de la tension de Hubble et de la précision des paramètres cosmologiques, ce qui est crucial pour comprendre l'énergie sombre.
Travaux voisins dans notre archive
- Le diapason cosmique : pourquoi l'Univers joue deux notes différentesproximité 0.69
- Les horloges cosmiques se dérèglent : nouvelle énigme sur l'expansion de l'Universproximité 0.64
- Les neutrinos racontent la vitesse d'expansion de l'Universproximité 0.63
- Pourquoi la cosmologie a-t-elle pris un coup de chaud ?proximité 0.62
- Pourquoi les données cosmiques ne convergent pas vers un même pointproximité 0.62
- La vitesse d'expansion de l'Univers précisée grâce aux « jumelles » parmi les supernovaeproximité 0.61
- L'écho des supernovae : une nouvelle mesure de la constante de Hubbleproximité 0.60
- Les ondes gravitationnelles mesurent la vitesse d'expansion de l'Universproximité 0.60
Le travail le plus proche de l'archive se situe à 0.69 par le sens — le niveau habituel de notre corpus.
Le réseau utilise des B-splines — les mêmes constructions mathématiques que celles employées en infographie et en animation pour des courbes lisses. Et pourtant, à une époque, Edwin Hubble déduisait l'expansion de l'Univers à l'œil nu à partir de plaques photographiques !
L'idée d'un réseau de neurones qui reconstruit seul l'histoire cosmique fait écho à l'« Encyclopédie Galactica » du cycle « Fondation » d'Isaac Asimov : là-bas, des mathématiciens prédisaient l'avenir des civilisations en analysant des masses de données sans connaître les mécanismes détaillés.
Chiffres clés
- constante de Hubble H₀: 69.576 km/s/Mpc
- densité de matière Ωₘ: 0.301
- magnitude absolue des supernovae M_B: –19.38 mag
- erreur quadratique moyenne de KLT-Net (MSE): 0.0157
- nombre de supernovae dans l'échantillon: 1701