Le bootstrap est une technique de rééchantillonnage utilisée pour estimer l'incertitude d'une statistique, telle que la moyenne, la médiane ou le coefficient de régression, sans faire d'hypothèses fortes sur la distribution sous-jacente. Elle fonctionne en tirant à plusieurs reprises des échantillons aléatoires, avec remise, à partir des données d'origine et en calculant la statistique pour chaque rééchantillon. La distribution de ces estimations bootstrap approxime la distribution d'échantillonnage de la statistique, ce qui permet de calculer des erreurs types, des intervalles de confiance et des tests d'hypothèse.
Histoire
Le bootstrap a été introduit par Bradley Efron en 1979. Efron l'a développé comme une méthode polyvalente pour estimer la précision des estimations statistiques, en s'appuyant sur les techniques antérieures du jackknife. Il a inventé le terme « bootstrap » à partir de l'expression anglaise « to pull oneself up by one's bootstraps », reflétant l'idée d'utiliser les données elles-mêmes pour déduire leur propre incertitude.
Comment ça marche
Étant donné un ensemble de données de taille n, le bootstrap crée de nombreux « échantillons bootstrap » en sélectionnant aléatoirement n observations parmi les données d'origine, en permettant qu'une même observation apparaisse plusieurs fois. Pour chaque échantillon, la statistique d'intérêt est calculée. Après des milliers de répétitions, la collection de ces statistiques forme une distribution empirique. La dispersion de cette distribution (par exemple, son écart type) fournit une estimation de l'erreur type de la statistique, et ses percentiles donnent des intervalles de confiance.
En pratique
Le bootstrap est utilisé en apprentissage automatique pour la validation de modèles, en écologie pour estimer la diversité des espèces, en médecine pour analyser les données d'essais cliniques, et en économie pour prévoir l'incertitude.
Anecdote
Le bootstrap peut être utilisé pour estimer l'incertitude de presque n'importe quelle statistique, même lorsqu'aucune formule analytique n'existe, ce qui en fait un outil « universel » pour l'inférence statistique.
L'orchestre joue sans chef. Chaque instrument entre selon son propre calendrier : le violon le lundi, la flûte le mercredi, les timbales le samedi. Les astronomes n'entendent pas la musique, mais des notes isolées, éparpillées sur le calendrier. Le télescope ne voit l'étoile que lorsqu'elle est au-dessus de l'horizon et que le calendrier lui a accordé du temps.
Deux photographes prennent la même montagne. L'un prend une centaine de clichés depuis le sommet et seulement deux au pied, l'autre fait l'inverse. Si l'on tente de superposer leurs images, l'algorithme pourrait décider que le sommet sur une photo correspond au sommet sur l'autre simplement parce qu'il y a beaucoup de points similaires, et non parce qu'il s'agit du même endroit.
Un lecteur de glycémie qui ne pique pas le doigt, mais se contente de regarder le poignet — c'est le rêve de millions de personnes diabétiques. C'est précisément ce que promettent les algorithmes qui extraient le niveau de glucose du signal de pouls ordinaire — le photopléthysmogramme (celui-là même qui mesure le pouls dans les montres connectées).
Garder en tête la position exacte d'un stylo qu'on déplace lentement est une tâche banale pour le cerveau. Pour les réseaux de neurones artificiels, c'est presque impossible. Les réseaux récurrents classiques, comme GRU et LSTM, ont tendance à découper le mouvement continu en paliers rigides : le stylo ne glisse pas de façon fluide, il saute d'un point à un autre.
Un réseau de neurones prédit l'avenir d'un système — par exemple, comment le plasma va tourbillonner dans un champ magnétique ou comment un visage va changer dans une vidéo. Les erreurs sont inévitables, et plus il regarde loin, plus elles s'accumulent.
Un bac de sable mouillé. Vous appuyez dans un coin — et l'eau se met en mouvement. Mais comment exactement ? Au lieu d'un cercle régulier, elle peut s'étaler en langues, s'attarder longtemps à certains endroits et filer rapidement à travers d'autres.
Le fond optique du ciel est un palimpseste cosmique, où la lumière de milliards de galaxies non résolues s'empile en couches correspondant à différentes époques. Jusqu'ici, nous ne distinguions que les « lettres » les plus brillantes — les étoiles individuelles et les galaxies proches.
Une flotte de nombreux vaisseaux, telle une galaxie d'étoiles, accomplit une mission commune. Parfois, un vaisseau explose comme une supernova. Si on ne le remplace pas à temps, la flotte s'affaiblit. Mais le problème, c'est qu'on ne voit pas quel vaisseau tombera en panne ensuite — les défaillances sont invisibles, comme la matière noire.
Le microlentillage gravitationnel est un effet cosmique fascinant, prédit par Einstein et développé par Zwicky. Un corps massif, passant entre nous et une étoile lointaine, courbe sa lumière comme une lentille, créant des amplifications et distorsions caractéristiques.
L'Univers n'est pas silencieux : il est parcouru d'un bourdonnement continu d'ondes gravitationnelles. Dans une décennie, l'observatoire spatial LISA accordera ses « oreilles » sur la gamme des millihertz, et notre Galaxie s'avérera être la source la plus riche — des dizaines de milliers de paires de naines…
Quand on entreprend des travaux, on n'achète pas la peinture au jugé, mais en fonction de la surface des murs. En science, le calcul du nombre d'échantillons est une estimation similaire, mais les enjeux sont plus élevés. En dessous du compte, l'étude devient une loterie : on peut passer à côté d'un effet réel, ou prendre du bruit pour une découverte.
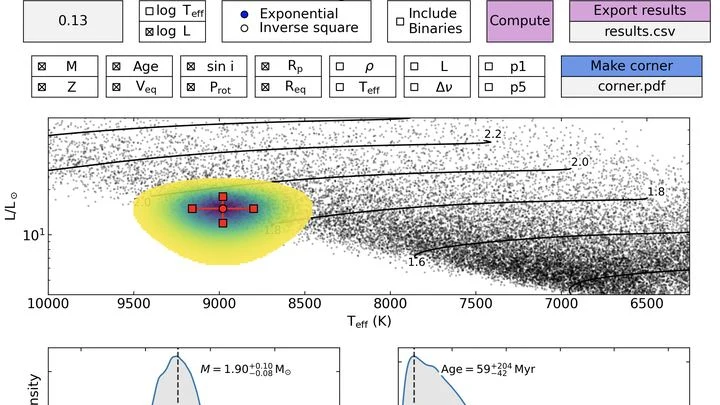
Une personne sur une vieille photo se tient dans une foule tout en tournant sur elle-même — deviner son âge est presque impossible. C'est à peu près ainsi que les astronomes déterminent l'âge et la masse des étoiles lointaines, et ils se trompent souvent.
L'appareil photo prend une image, mais le capteur bruit, l'optique floute, et une partie des pixels est surexposée. Reconstituer l'image d'origine, c'est un peu comme deviner une mélodie sur un disque rayé : les possibilités sont nombreuses, et l'on ne sait pas laquelle est la bonne.
Chaque contraction du cœur peut être représentée par un point sur une feuille de papier. Des milliers de points se fondent en un nuage. L'algorithme Mapper transforme ce nuage en réseau : il relie les points dont le comportement est similaire et les colore en fonction de la force du flux sanguin.
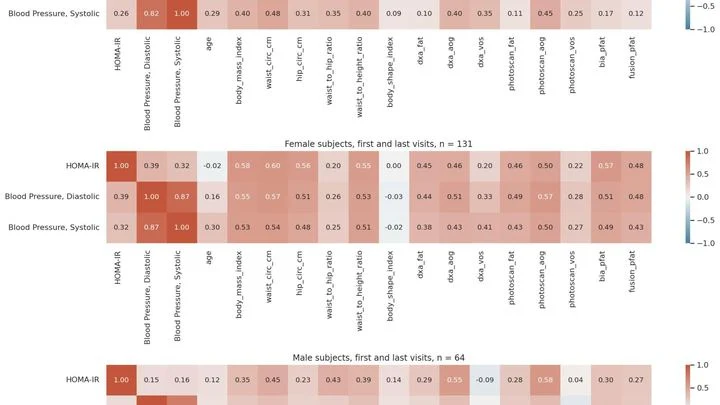
La balance affiche des kilos, mais reste muette sur leur répartition : muscles ou graisse abdominale. Or, c'est précisément la graisse cachée en profondeur, autour des organes, qui est le plus souvent associée aux maladies cardiaques et au diabète. Auparavant, on ne pouvait la visualiser qu'avec un scanner coûteux à l'hôpital. Désormais, un smartphone suffit.
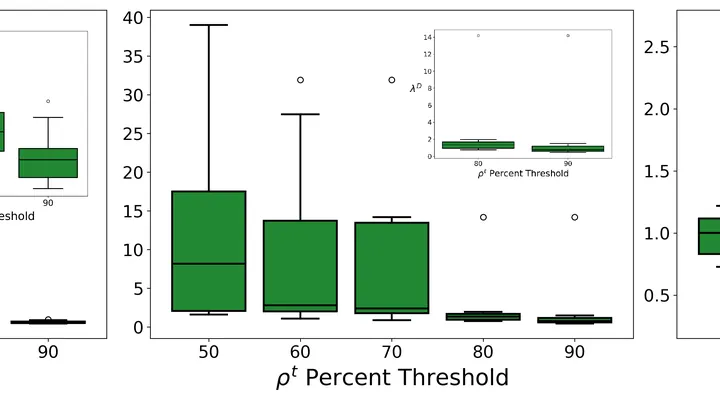
Un réseau de connaissances dense : chacun est lié à presque tout le monde, et dans cette toile, il est difficile de comprendre qui est vraiment important. Trop de fils — l'ordinateur s'étouffe, la modélisation patine. Des chercheurs ont trouvé comment éclaircir ces réseaux sans perdre l'essentiel.
L'idée est de supprimer les connexions qui ne participent pas aux chemins les plus courts.
La lumière née au moment du Big Bang a voyagé vers nous pendant près de 14 milliards d'années. Mais en chemin, elle a traversé les champs gravitationnels des galaxies et des amas de matière noire, qui ont courbé ses rayons.
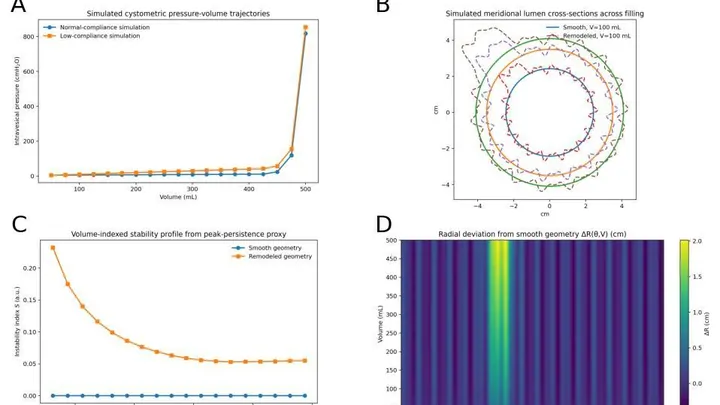
La vessie ressemble à un ballon de baudruche : pendant qu'elle se remplit, la paroi s'étire et la forme change. Les médecins surveillent généralement la pression interne et la quantité de liquide introduite, mais ils prêtent rarement attention à la géométrie elle-même, c'est-à-dire à la manière dont la surface se courbe.
Une particule chargée, enroulée par un champ magnétique, ne reste pas silencieuse : elle émet de la lumière. Cette lumière est appelée rayonnement synchrotron, et on la rencontre partout – des galaxies lointaines aux accélérateurs de laboratoire.
Notre tissu corporel ressemble à une ville : dans différents quartiers vivent différentes cellules, chacune avec son propre travail. Pour comprendre comment cette ville est organisée, les biologistes prennent des images montrant quels gènes sont actifs à chaque point.
Un photographe photographie un immeuble de grande hauteur, mais au lieu de prendre une seule photo, il fait une série de clichés en déplaçant son appareil en spirale de haut en bas. Cette approche capture plus de détails en moins de temps, mais les images peuvent être floues.
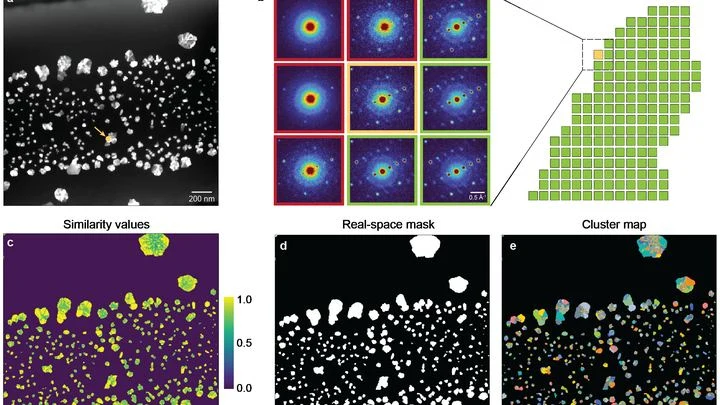
Le microscope électronique balaie l'échantillon et enregistre en chaque point la façon dont les électrons sont diffusés par les atomes. On obtient une pile gigantesque d'images – une par point.
Le diagnostic génétique, c'est un peu comme comparer deux photos prises avec des appareils différents. Si l'un des appareils a légèrement décalé les couleurs, la photo révèle des « défauts » qui n'existent pas dans la réalité.
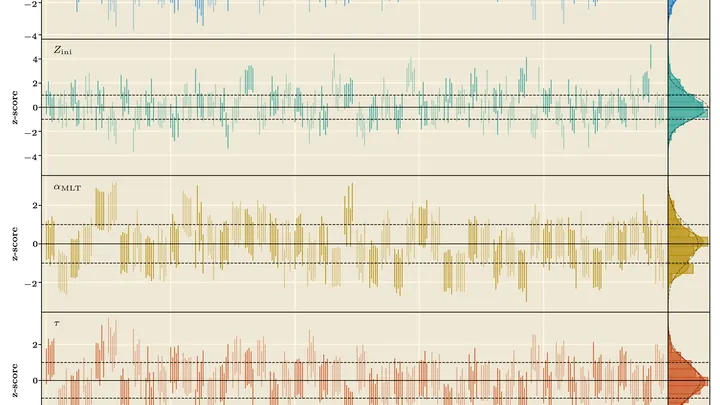
Une étoile tremble comme une cloche après un coup. Ces tremblements — de minuscules variations de luminosité et de surface — peuvent être captés par un télescope. En analysant les fréquences de ces « notes stellaires », les astronomes déduisent ce qui se passe à l'intérieur : l'âge de l'étoile, sa structure.
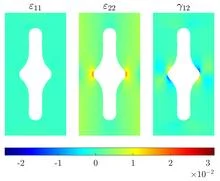
Le laboratoire d'essais mécaniques ressemble à une cuisine où le chef goûte un plat pour deviner la recette. Pour un matériau anisotrope, c'est-à-dire plus rigide le long des fibres que dans le sens travers, un seul échantillon ne suffit pas. Il faut trois essais distincts, voire plus, chacun avec son propre échantillon.