Une machine à vecteurs de support (SVM) est un modèle d'apprentissage supervisé qui trouve l'hyperplan séparant au mieux les points de données de différentes classes. Le « meilleur » hyperplan est celui qui présente la plus grande marge, c'est-à-dire la distance maximale aux points les plus proches de chaque classe, appelés vecteurs de support. Cette maximisation de la marge confère au modèle une bonne généralisation aux données inédites. Les SVM peuvent traiter aussi bien la séparation linéaire que non linéaire en utilisant des fonctions noyau qui projettent implicitement les données dans des espaces de dimension supérieure.
Histoire
Développée dans les années 1990 par Vladimir Vapnik et ses collègues des laboratoires Bell d'AT&T, en s'appuyant sur des travaux antérieurs en théorie de l'apprentissage statistique.
Comment ça marche
À partir de données étiquetées, la SVM résout un problème d'optimisation pour trouver l'hyperplan qui maximise la marge tout en minimisant les erreurs de classification (marge souple). Les vecteurs de support sont les points de données les plus proches de l'hyperplan ; ils définissent la marge et la frontière de décision. Pour des données non linéaires, une fonction noyau (par exemple, la fonction à base radiale) calcule des produits scalaires dans un espace de caractéristiques de haute dimension sans transformer explicitement les données, ce qui permet d'obtenir des frontières complexes.
En pratique
Largement utilisée en classification d'images, en catégorisation de textes (par exemple, la détection de spam) et en bioinformatique pour la classification des protéines.
Anecdote
Les SVM fonctionnent bien même avec des données de haute dimension, comme des milliers de caractéristiques, car la maximisation de la marge agit comme une forme de régularisation.
Un radiologue regarde un scanner abdominal et voit non seulement des organes, mais aussi leur disposition mutuelle : quel rein est plus gros, où se trouve la tumeur par rapport au vaisseau. C'est comme lire une carte : il ne suffit pas de savoir où se trouve habituellement une ville, il faut aussi savoir mesurer la distance entre deux points sur le terrain.
Le diamant n'est pas qu'une simple parure. Dans son réseau cristallin se cachent des défauts qui détectent le champ magnétique mieux que bien des instruments. L'un de ces défauts, le centre NV, agit comme une minuscule boussole, mais son aiguille oscille à cause de la chaleur et du bruit.
À l'intérieur d'un morceau d'aluminium, les atomes sont alignés en rangées régulières, comme des briques dans un mur. Mais parfois, une rangée s'arrête avant d'atteindre le bord – et une « marche » apparaît dans le cristal, ce que les physiciens appellent une dislocation.
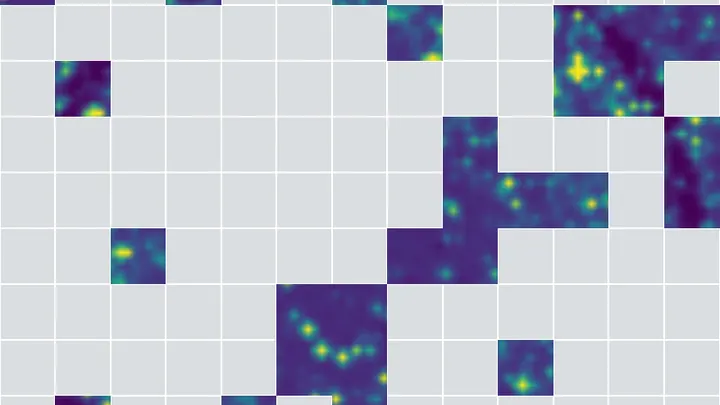
Chaque matin, des dizaines de télescopes se braquent sur le Soleil. Leurs caméras capturent une fine bande de lumière rouge : la raie Hα, découverte par Johann Jakob Balmer. Sur les images, des filaments sombres et capricieusement incurvés apparaissent.
Reconstituer une image complète à partir de fragments, c'est un peu comme essayer de distinguer la mélodie d'un orchestre dans une salle bruyante. De telles tâches se posent en photométrie, où l'on reconstitue la luminosité d'une étoile à partir de faibles scintillements.
Les caméras d'une voiture autonome captent la lumière, telles des télescopes pointés vers une lointaine galaxie. Chaque image est une observation fragmentaire ; ensemble, elles doivent former une carte du chemin.
Les données sur l'activité des gènes ressemblent généralement à une longue rangée de chiffres, comme une bande arc-en-ciel (spectroscopie) sans liens visibles. Dans le modèle scVision, ces chiffres sont transformés en une image signifiante — non pas une liste d'ingrédients, mais une photo du plat fini.
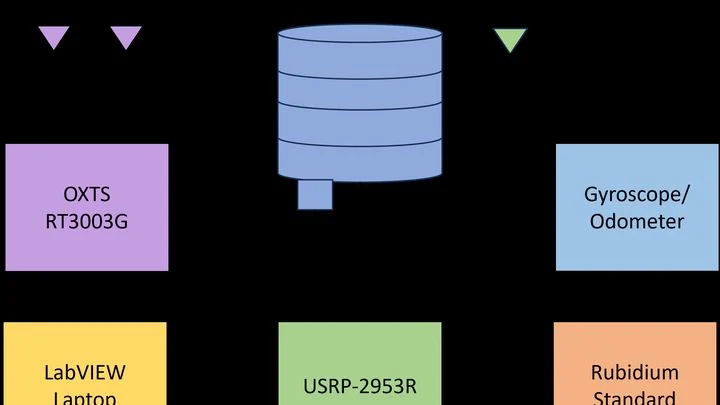
En ville, le signal rebondit entre les murs comme une balle, et le téléphone capte des dizaines de ces « réflexions » — des échos. Chaque microseconde de retard ajoute 300 mètres au trajet.
La vitesse du signal est constante, comme celle de la lumière (vitesse de la lumière).
Les systèmes électriques équipés de panneaux solaires et d'éoliennes ressemblent à une partie d'échecs : la couverture nuageuse et les variations de charge sont des coups de l'adversaire impossibles à prévoir. Pour maintenir l'équilibre, les opérateurs devaient auparavant évaluer des dizaines de scénarios (incertitude) — ce qui demandait trop de temps et de calculs.
Un essaim de robots ressemble à une nuée de lucioles : chacun se déplace au hasard « là où c'est plus libre », et le chaos se transforme en ordre. Pendant longtemps, on s'est demandé comment, sans communication ni commandes, naissait cette coordination.
La cosmologie moderne est en dissonance. Les mesures locales de la constante de Hubble à partir des supernovae et des céphéides donnent environ 73 km/s/Mpc, tandis que les contraintes globales issues du fond diffus cosmologique dans le cadre du modèle standard ΛCDM…
Stuttgart, 2025. Un ingénieur logiciel branche son ordinateur portable sur une voiture d'essai, non pas pour un diagnostic, mais pour changer « l'identité » du véhicule — comme on flashe le firmware d'un smartphone. Mais au lieu d'une mise à jour instantanée, il est confronté à une cascade d'incompatibilités.
Un interprète est assis dans la salle de réunion et traduit chaque mot. Mais voilà qu'il remarque que sa traduction pourrait être améliorée s'il apprenait de ses erreurs. Il commence à noter les phrases qui ont causé des incompréhensions et les corrige. Au bout d'une heure, sa traduction est plus précise et la réunion se déroule plus vite.
Un orchestre joue sans chef, et vous entendez que le tempo tantôt s'accélère, tantôt ralentit. Vous n'avez en main que l'enregistrement du son, pas la partition. Peut-on, à partir de cet enregistrement, comprendre quelle corde toucher pour que tout l'orchestre joue plus régulièrement ?
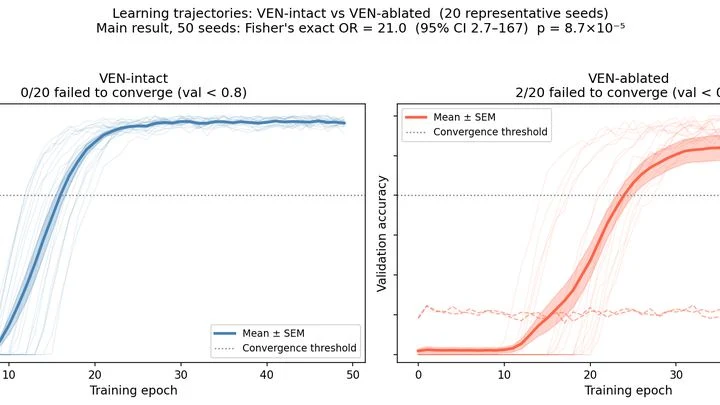
Un orchestre à la première répétition sans chef. Les violons attaquent à contretemps, les cuivres sont en retard, et au lieu d'une symphonie, c'est la cacophonie. C'est à peu près ce qui se passe dans un modèle informatique du cerveau lorsqu'on en retire des cellules particulières : les neurones de von Economo.
Deux dés tombent toujours du même côté, où qu'on les lance. En physique quantique, ce comportement est appelé intrication, et c'est la ressource clé pour les ordinateurs du futur et les communications sécurisées. Mais le problème, c'est que toute intrication n'est pas facile à repérer.
Les protéines, comme les humains, ont une généalogie. Deux protéines qui remplissent la même fonction chez des organismes différents descendent d'un ancêtre commun. En comparant leurs séquences, on peut reconstituer cette histoire.
Une goutte de crème tombe dans une tasse de café — et en une minute, toute la boisson devient beige. Ce processus de mélange peut être mesuré : de combien faut-il « remuer » une distribution de particules pour la transformer en une autre ? En mathématiques, cette approche s'appelle le transport optimal, et la mesure de l'effort est la distance de Wasserstein.
Les poumons ne sont pas deux sacs, mais des millions de minuscules alvéoles où l'air entre et où le sang afflue. Pour voir comment ils fonctionnent, les médecins utilisent parfois l'IRM sans produit de contraste : l'appareil capte de faibles signaux émis par les tissus eux-mêmes.
Dans un nuage froid d'atomes, refroidi presque au zéro absolu, les énergies peuvent se comporter comme des fils qui se tressent en nattes. Ces nattes ne sont pas qu'une jolie image : leur motif est lié à la topologie, la branche des mathématiques qui étudie les propriétés préservées par les déformations continues.
Une étoile brille des milliards de fois plus que sa planète. Pour voir la planète, il faut éteindre la lumière de l'étoile, comme on met la main devant le soleil pour apercevoir un avion.
Prévoir la météo, c'est un peu comme essayer de prédire où roulera une pierre sur une pente en connaissant la forme de chaque bosse et la force du vent. On se trompe au départ, et une semaine plus tard, l'erreur s'est transformée en véritable tempête. Avant, pour des prévisions précises, il fallait d'énormes ordinateurs et des calculs de plusieurs jours.
Le détecteur de particules du Grand collisionneur de hadrons fonctionne pendant des années sans s'arrêter. Ses capteurs produisent des montagnes de données à chaque seconde, et il faut repérer rapidement une défaillance — par exemple, une surchauffe ou un canal cassé. Avant, des règles simples surveillaient cela, mais elles faisaient souvent des erreurs.
Dans une salle de classe, l'institutrice explique la différence entre « dom » et « tom » : posez la main sur la gorge et sentez la vibration. La machine qui reconnaît la parole fait à peu près la même chose, sauf qu'à l'intérieur, ce n'est pas une gorge, mais de longues listes de nombres.
La lumière, en traversant une lentille, se courbe légèrement. Pour un ordinateur optique, c'est comme un miroir déformant pour un peintre : l'image est là, mais les détails flottent. La machine d'Ising à base de rayons lumineux résout des problèmes comme la répartition des bagages ou l'itinéraire d'un livreur.
Les zéolithes, minéraux poreux, fonctionnent comme de minuscules éponges percées de trous de taille strictement définie. Par ces ouvertures passent les molécules d'une certaine sorte tandis que d'autres restent piégées — c'est sur ce principe que reposent la purification de l'eau, la séparation des gaz et la catalyse en pétrochimie.