اختبار التقليب هو طريقة غير معلمية لاختبار فرضية إحصائية دون افتراضات حول التوزيع الأساسي للبيانات. بدلاً من الاعتماد على التوزيعات النظرية (مثل التوزيع الطبيعي)، يبني توزيع العدم مباشرة من البيانات المرصودة عن طريق خلط التسميات أو تعيينات المجموعات عشوائياً. هذا مفيد بشكل خاص عندما يكون حجم العينة صغيراً أو عندما لا تتبع البيانات التوزيعات القياسية.
التاريخ
قدم هذه الطريقة ر. أ. فيشر في ثلاثينيات القرن العشرين، لكنها أصبحت عملية حسابياً فقط مع ظهور الحواسيب الحديثة.
كيف يعمل
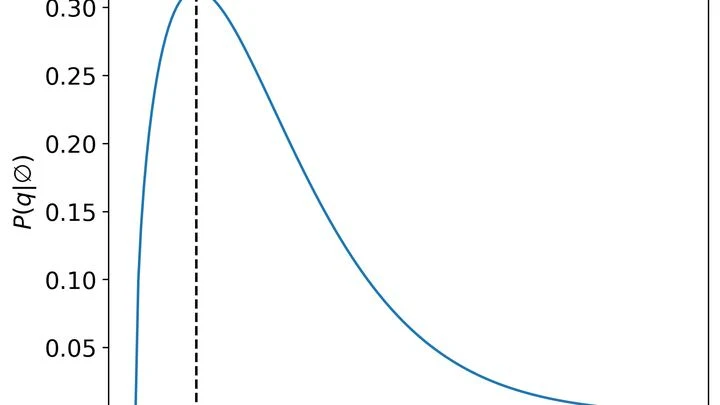
الإجراء واضح. أولاً، احسب إحصائية اختبار (مثل الفرق في المتوسطات بين مجموعتين) على البيانات الأصلية. ثم، قم بخلط تسميات نقاط البيانات عشوائياً بشكل متكرر، مع إعادة حساب إحصائية الاختبار في كل مرة. تشكل هذه القيم المخلوطة توزيع العدم — توزيع الإحصائية إذا لم يكن هناك تأثير حقيقي. القيمة الاحتمالية (p-value) هي نسبة الإحصائيات المخلوطة التي تكون متطرفة أو أكثر تطرفاً من الإحصائية المرصودة. إذا كانت هذه النسبة صغيرة جداً، فمن غير المرجح أن تكون النتيجة المرصودة قد حدثت بالصدفة.
في التطبيق
يُستخدم في علم الجينوم لاختبار التعبير الجيني التفاضلي، وفي علم الأعصاب لبيانات التصوير الدماغي، وفي أي مجال تكون فيه العينات الصغيرة أو البيانات غير الطبيعية تجعل الاختبارات التقليدية غير موثوقة.
حقيقة طريفة
اختبارات التقليب دقيقة: فهي لا تعتمد على تقريبات مقاربة، مما يعني أن القيمة الاحتمالية صحيحة حتى مع أحجام العينات الصغيرة جداً.
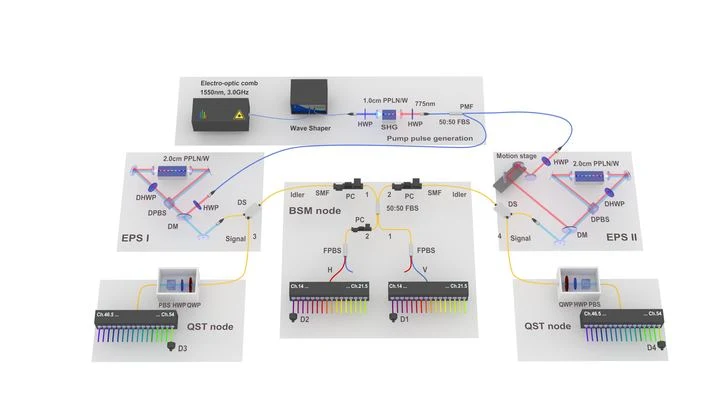
يشبه الاتصال الكمي إرسال رسالة سرية تتمزق عند أي محاولة للاطلاع عليها. حتى الآن، لا يمكن إرسال مثل هذه الرسالة إلا عبر طريق واحد، وهذا بطيء. ابتكر العلماء طريقة لإرسال 16 ساعيًا عبر 16 طريقًا متوازيًا — ترددات ضوئية مختلفة — وتأكدوا من وصول الرسائل سليمة.
جهاز قياس الغلوكوز الذي لا يخز الإصبع، بل يكتفي بالنظر إلى المعصم — إنه حلم ملايين المصابين بالسكري. وهذا ما تعد به الخوارزميات التي تستخرج مستوى الغلوكوز من إشارة النبض العادية — تصوير التحجم الضوئي (photoplethysmography) (وهي نفسها التي تقيس النبض في الساعات الذكية). المشكلة أن أحدًا لم يستطع حتى الآن مقارنة هذه الخوارزميات بشكل صحيح: فكل باحث استخدم بياناته الخاصة وطرقه الخاصة في الفحص.
السائق على طريق زلق لا يعرف كيف ستستجيب السيارة لعجلة القيادة، فيتعلم أثناء القيادة تاركاً هامشاً للخطأ. على نحو مماثل، تتصرف خوارزمية التحكم الذكية. فبدلاً من المطالبة بنموذج دقيق، تجمع البيانات بشكل فوري، وتقدّر عدم اليقين والتشويشات الخارجية، وكأن الصندوق الأسود يكشف عن إعداداته تدريجياً.
على الخريطة الطبوغرافية، تختار قطرات المطر طريقها: إذا سقطت على منحدر واحد، تتجه إلى النهر أ، وإذا سقطت على الآخر، إلى النهر ب. يرى المراقب فقط تعرجات الأنهار (متغيرات الاستجابة Y) ويعرف من أي منحدر جاء الماء (الأداة Z)، لكنه لا يرى القطرات نفسها (العوامل غير المرصودة ε).
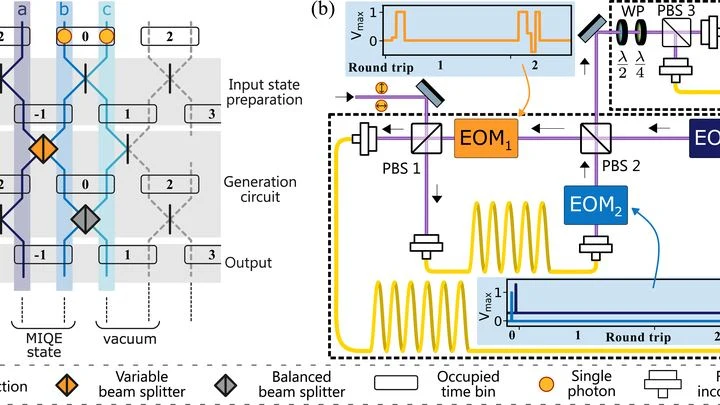
التشابك الكمومي ظاهرة تتصرف فيها الجسيمات كشريكين في رقصة متزامنة، لكنها لا تُرى إلا من زاوية معينة. بمجرد تغيير طريقة الرصد، يختفي تناسقها، مما يحد من استخداماتها في الاتصالات الآمنة. الآن حصل الفيزيائيون على زوج من الفوتونات — كَمّات الضوء — التي تكون «رقصتها» مثالية من جميع الزوايا.
روبوت المختبر يعدّ الجزيئات — ويخطئ. في أنبوب واحد 0، وفي آخر 12، وفي ثالث 3، رغم أن الكميات في الحقيقة متساوية تقريبًا. هذه الأرقام "الخام" أمر شائع في علم الأحياء: تسلسل الحمض النووي (DNA)، عدّ الأنواع في عينة ماء، نشاط الجينات. البيانات كثيرة، لكنها متناثرة ومشتتة أكثر مما يسمح به العشوائية البسيطة.
توأمان يدخلان الغرفة من بابين مختلفين. يحصل كل منهما على صندوق بزر — وفي كل مرة يضغطان على الزر، يضيء مصباح إما أحمر أو أخضر. إذا كان التوأمان متطابقين تمامًا، يمكن توقع أن تضيء المصابيح لديهما وفقًا لنفس القواعد الداخلية. ولكن ماذا لو كانت القواعد مختلفة، على الرغم من أن التوأمين نسختان طبق الأصل؟
هذا هو بالضبط الموقف الذي درسه مؤلفو العمل.
عند الشروع في تجديد المنزل، لا يُشترى الطلاء بالتخمين، بل وفقًا لمساحة الجدران. وفي العلم، حساب عدد العينات هو تقدير مماثل، لكن الرهان أعظم. فإذا قلّت العينات، تتحول الدراسة إلى يانصيب: قد تفوتك تأثيرات حقيقية، وقد تخطئ وتظن أن الضوضاء اكتشاف. أما إذا كثرت، فستضيع أنابيب اختبار إضافية وشهور من الوقت، وفي التجارب على الحيوانات، أرواح تُزهق هباءً.
وفي الميكروبيوم، هذه المسألة أكثر تعقيدًا.
تشبه العديد من التحولات الكيميائية تركيب أثاث في ظلام دامس: ترى القطع الأولية والخزانة الجاهزة، لكن عملية التركيب نفسها تبقى لغزًا. الحالات الوسيطة — كوضعيات يد الحرفي غير الموفقة — تختفي بسرعة أكبر من أن تُرى. النهج الجديد الموصوف في المقال يستخدم الرنين المغناطيسي النووي كرادار حساس قادر على التقاط هذه الأشكال العابرة.
يقوم الأسلوب على نمط المبادرة الحرة الثابتة (SSFP).
في الفضاء، كثيرًا ما توجد أزواج من الثقوب السوداء المندمجة، يكون فيها أحد الثقبين أكبر كتلةً من الآخر بشكل ملحوظ. هذا الاختلاف في الوزن ليس مجرد رقم، بل هو مفتاح لتاريخهما المشترك.
درس علماء الفيزياء الفلكية قناة النقل المستقر للكتلة — وهي عملية ينتقل فيها المادة من نجم إلى آخر بسلاسة دون تدمير النظام. بنوا نموذجًا رياضيًا يربط بين لحظتين رئيسيتين: مدى استقرارية النقل، ومدى كفاءة النجم المجاور في التقاط هذه المادة.
نردان دائمًا ما يسقطان بنفس الطريقة، مهما كانت المسافة بينهما. في الفيزياء الكمومية، يُسمى هذا السلوك تشابكًا، وهو المورد الأساسي لحواسيب المستقبل والاتصالات الآمنة. لكن المشكلة أن ليس كل تشابك يسهل رصده. بعض أشكاله — مثل حبر غير مرئي: الارتباط موجود، لكن الفحص القياسي (ويُسمى «معيار الإيجابية تحت النقل الجزئي») يُظهر صفحة بيضاء.
الشاي الساخن يبرد، وتكون درجة حرارته موحدة في جميع أنحاء الكوب. لكن في العديد من الأنظمة — مثل الغاز المخلخل بين النجوم أو البلازما — لا تكون درجة الحرارة ثابتة: في مكان ما تكون الجسيمات أسرع، وفي مكان آخر أبطأ.
في المختبر، يتم قياس إشارة ضعيفة جدًا — على سبيل المثال، تغير ضئيل في المجال المغناطيسي. يهتز الجهاز بسبب مرور السيارات، وتنفس المجرب، وتسخين الأسلاك. لا يمكن إزالة هذه الضوضاء التقنية تمامًا، وهي تضع حدًا للدقة. يعمل جهاز الاستشعار التقليدي مثل ميزان يتأرجح مع أي تيار هواء.
الآن يقترح الفيزيائيون نوعًا آخر من أجهزة الاستشعار — غير تقليدي، ببنية داخلية خاصة.
كل خلية هي شوكة رنانة مصغرة. تجعلها نبضة مغناطيسية حادة 'ترن'، ويعتمد خفوت هذا الصوت على ما بداخلها: اللزوجة، الكثافة، التكوين. يعمل الماس الصغير ذو عيب بنيوي كميكروفون فائق الحساسية، يلتقط الأصداء المغناطيسية من الخلايا الفردية.
هذا العيب - فراغ نيتروجيني - صغير جدًا لدرجة أن الملايين منه تتسع على رأس إبرة.
جميع الأجسام تسقط بنفس الطريقة — وقد لاحظ ذلك غاليليو. ثم جعل أينشتاين هذه الملاحظة مبدأ التكافؤ: فالثقل والتسارع لا يمكن تمييزهما، ومن هنا نشأ الزمكان المنحني. وللتحقق الكمي، يستخدم الفيزيائيون الموازين الالتوائية — وهي أداة تتحسس أدنى اختلاف في الجاذبية.