تشير البيانات الاصطناعية إلى المعلومات التي تُولَّد بشكل مصطنع بدلاً من جمعها من أحداث العالم الحقيقي. في سياق المقالات المقدمة، تُستخدم لتدريب نماذج التعلم الآلي دون تعريضها لبيانات المرضى الفعلية، والتي غالباً ما تكون حساسة ومحمية بموجب لوائح الخصوصية. هذا المفهوم أساسي في مجالات مثل التصوير الطبي، حيث يمكن إنشاء توائم رقمية للمرضى أو الأعضاء لمحاكاة الحالات واختبار الخوارزميات بأمان.
التاريخ
اكتسب المصطلح شهرة في العقد 2010 مع صعود التعلم العميق، على الرغم من أن الفكرة الأساسية لتوليد بيانات اصطناعية للاختبار لها جذور في تقنيات المحاكاة السابقة. لا يُنسب الفضل إلى مخترع واحد.
كيف يعمل
تتضمن العملية عادةً استخدام نماذج توليدية، مثل الشبكاتالتنافسية التوليدية (GANs) أو الترميز الذاتي التبايني، لتعلم التوزيع الإحصائي للبيانات الحقيقية ثم أخذ عينات جديدة ومعقولة من هذا التوزيع. يمكن تسمية هذه الأمثلة الاصطناعية بحقيقة أرضية معروفة، مما يسمح بتدريب النماذج والتحقق منها في بيئة خاضعة للتحكم. يمكن جعل البيانات المولدة تحاكي حالات محددة، مثل حالات مرضية مختلفة أو تشوهات تصويرية، والتي قد تكون نادرة أو صعبة الحصول عليها في مجموعات البيانات الحقيقية.
في التطبيق
تُستخدم البيانات الاصطناعية لتدريب نماذج التشخيص في التصوير الطبي، ولتوسيع مجموعات البيانات الحقيقية الصغيرة، ولاختبار الأنظمة المستقلة في بيئات محاكاة قبل النشر في العالم الحقيقي.
حقيقة طريفة
يمكن استخدام البيانات الاصطناعية لتوليد صور لأمراض نادرة تكون نادرة جداً بحيث لا تكفي الأمثلة الحقيقية لتدريب نموذج تشخيصيموثوق.
على عكس الكاميرات العادية، فإن الكاميرات الحدثية لا تسجل سوى اللحظات التي يصبح فيها الضوء أكثر سطوعًا أو خفوتًا. فهي لا تنتج صورًا، بل ترسل تيارًا لا ينتهي من هذه الومضات. وقد حول العلماء هذا التيار إلى صورة واضحة للأرض، أثناء التحليق فوقها على متن قمر اصطناعي. كل ومضة تشبه قطعة من فسيفساء؛ ومعًا تتجمع في صورة ثابتة.
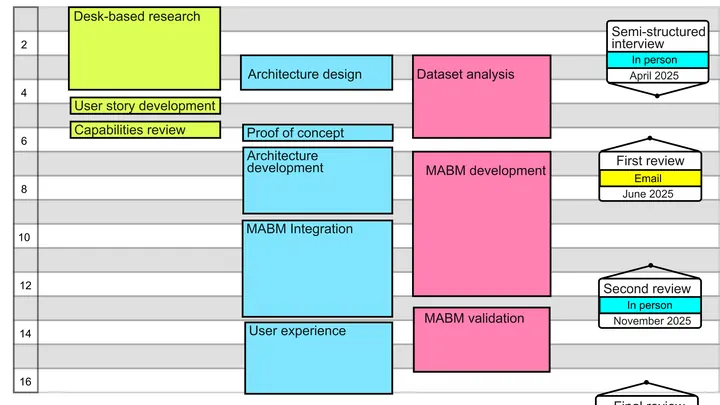
في أي مشروع حضري، سلوك السكان هو قوة غير مرئية يعتمد عليها النجاح. جار واحد متردد يمكن أن يبطئ تركيب الألواح الشمسية في حي بأكمله: حذره يطلق زيادة في الفوضى. للتنبؤ بهذا التأثير، يبني العلماء نموذجاً قياسياً من آلاف الوكلاء المستقلين - كل منهم يتخذ قراراته بنفسه.
تخيّل طبّاخًا يتعلّم الطهي من صور مرسومة فقط — شبه مؤكد أنه سيفسد كل طبق. فخّ مشابه يتربّص بـ الرؤية الحاسوبية: تدريب النماذج يتطلب آلاف الصور الموسومة، لكن جمعها ووضع العلامات عليها يدويًا مكلف ومضجر. الصور الاصطناعية المولّدة بالخوارزميات تحل المشكلة، لكن بشرط أن تبدو حقيقية. هنا تظهر أداة GraNatPy التي تقيّم مصداقية الصور الاصطناعية.
النهج القياسي لرقمنة الكلام، الذي يقوم عليه النموذج القياسي للاتصالات الحديثة، هو أخذ عينات مباشر: آلاف المرات في الثانية يتم تسجيل شدة الإشارة اللحظية. تخيل أنك تتذوق المرق بملعقة صغيرة — كل رشفة تعطي لمحة خافتة عن الطعم، ولإدراك النكهة الكاملة عليك أن تغرف مرارًا وتكرارًا. وهكذا هنا: تتدفق البيانات وتتضخم، رغم أن الحمل الدلالي فيها ضئيل.
تخيل تجربة أداء في أوركسترا سيمفونية، حيث من بين مئات المتقدمين، لا يبقى إلا أولئك الذين تصدر آلاتهم صوتًا نقيًا وتصمد أمام التصعيد الهائل. في عالم المواد، تعلمت الحواسيب توليد 'نوتات ذرية' — آلاف البلورات الافتراضية التي تبشر بأن تصبح أساسًا للرقائق الكمومية أو الموصلات الفائقة.
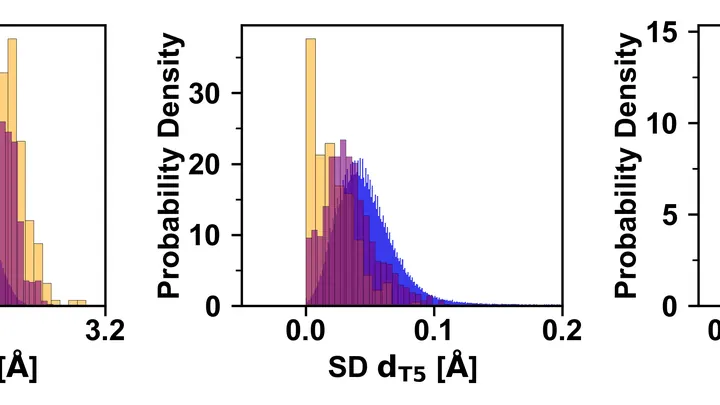
مئة وعشرون ساكنًا في مونتيلاغو ليسوا بشرًا، بل شخصيات رقمية. لكل منهم، بالإضافة إلى الاسم والسيرة الذاتية، ثلاثة إحداثيات مخفية: الثقة في السلطات البلدية، تقييم مصداقية المصدر، مدى ملاءمة المعلومات المدركة. هذه الأرقام معروفة للمبدعين، ولكن ليس للنظام نفسه.
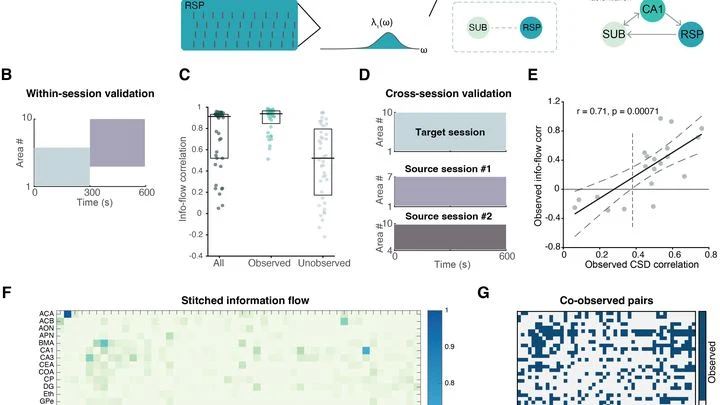
لحاف مرقّع، كل رقعة فيه تسجيل لنشاط جزء صغير من الدماغ. رقعة خيطت يوم الاثنين في لندن، وأخرى يوم الثلاثاء في نيويورك، والثالثة قبل شهر في طوكيو. هذه الفسيفساء كلها تغطي الدماغ جزئيًا فقط، ولا يوجد خيط مشترك يربطها. سابقًا، لرسم خريطة للاتصالات الموجهة — من يرسل الإشارة إلى من — كان يلزم تسجيل جميع المناطق في وقت واحد وبساعة موحدة.
طريقة SPIDER تعمل بشكل مختلف.
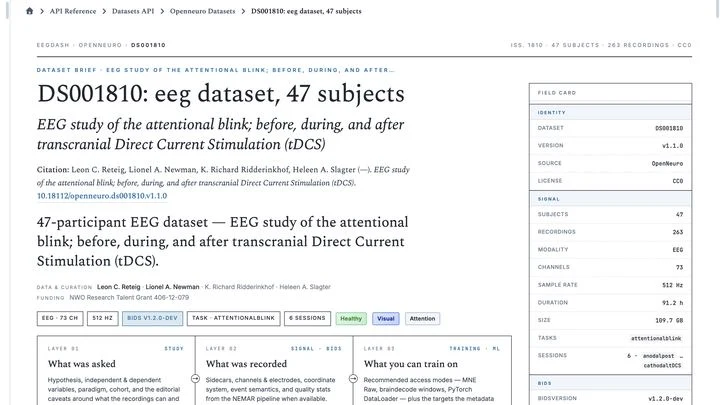
في الأرشيفات المفتوحة OpenNeuro وNEMAR، يوجد 791 تسجيلًا للنشاط الكهربائي للدماغ من ما يقرب من أربعين ألف شخص. إجمالاً، هذا يمثل 86,051 ساعة من الإشارات — أي ما يعادل حوالي عشر سنوات من الاستماع المتواصل. في السابق، كان الحصول على تسجيل واحد فقط من هذه التسجيلات يتطلب كتابة آلاف الأسطر من التعليمات البرمجية: التنزيل، وفك الضغط، وإصلاح أخطاء التنسيق، وتقطيع البيانات إلى أجزاء بالطول المطلوب.
رقصة مئات الجسيمات: بعض الأزواج تدور ببطء وسلاسة، بينما تهتز أخرى بإيقاع محموم. لفهم جوهر الرقصة، يجب متابعة الحركات البطيئة تحديدًا، فهي الكوريغرافيا الرئيسية للنظام. في علم الجزيئات، تُسمى هذه الحركات البطيئة "الأنماط البطيئة" (slow modes)، وهي التي تحدد كيفية طي البروتين على شكل كرة أو ارتباط الدواء بالهدف.
الطريقة الجديدة SelfTICA تتعلم تمييز هذه الكوريغرافيا دون توجيه.
ترفع اليد كوبًا من الرف — حركة مألوفة لا نلاحظها حتى تتعب العضلات. عندها يتغير المسار: يبتعد المرفق قليلًا إلى الجانب، وترتجف المعصم. عادةً ما يلتقط الطبيب هذه التغيرات بيديه، بجس عضلات المريض. لكن ماذا لو أمكن وضع التشخيص من خلال الفيديو؟
ابتكر فريق من الباحثين خوارزمية تنظر إلى حركة الذراع من الخارج وتقارنها بنسخة رقمية طبق الأصل من الشخص.
الهيدروجين بطل في الطاقة لكل كيلوغرام، لكن تخزينه متعب. في حالته الغازية يشغل حجمًا هائلًا، وإذا تم ضغطه أو تبريده إلى سائل، نحتاج إلى أسطوانات ثقيلة وطاقة كبيرة. هناك طريق ثالث: بعض المواد الصلبة تمتص الهيدروجين مثلما تمتص الإسفنجة الماء، وتحتفظ به داخلها. سخّن المادة — يخرج الهيدروجين، برّدها — يُمتص مرة أخرى.
الطاهي يتذوق الحساء بعد كل رشة ملح ويقرر فورًا ما الذي سيضيفه بعد ذلك. هكذا تقريبًا يعمل الجهاز الجديد لزراعة الأغشية البلورية الرقيقة. لكن بدلًا من التذوق، لدينا صورة من المجهر الإلكتروني، وبدلًا من الطاهي، لدينا برنامج حاسوبي.
عادةً، للحصول على غشاء بالتركيب المطلوب، يجب تجربة عشرات المجموعات من درجة الحرارة والضغط وتكوين الأبخرة. هذا يستغرق وقتًا طويلًا ويكلف الكثير.
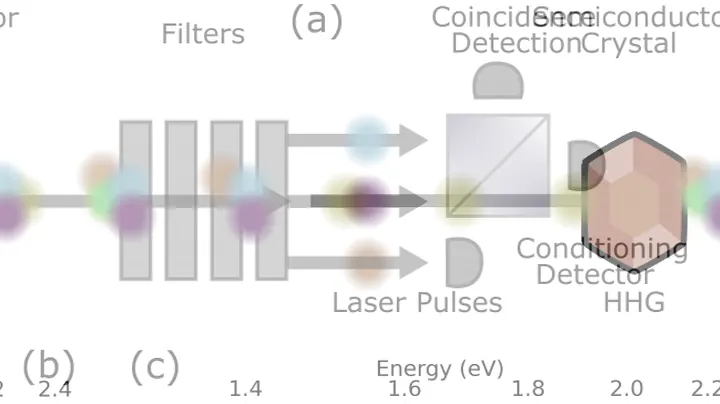
يضرب ليزر قوي شبه الموصل، فيستجيب بضوء بترددات متعددة — مثل وتر يصدر جوقة من النغمات التوافقية. استُخدم هذا سابقًا في التحليل الطيفي لمراقبة العمليات فائقة السرعة. لكن الفيزيائيين لاحظوا الآن: النغمات التوافقية ليست مستقلة، بل تتصرف وكأنها مربوطة بخيوط غير مرئية.
في الليل يتنفس الإنسان، ومن إيقاع هذا التنفس يمكن معرفة الكثير عن نومه. لكن الأطباء عادةً ما ينظرون إلى الموجات الكهربائية للدماغ، والتي تُسجَّل بواسطة أجهزة استشعار توضع على الرأس. العمل الجديد يُظهر كيف يمكن استعادة هذه الموجات من التنفس وحده، دون لمس الرأس.
يعمل النموذج كمترجم من لغة الجسد إلى لغة الدماغ.
تعمل المعادن المسامية المعروفة بالزيوليتات مثل إسفنجات صغيرة ذات ثقوب بأحجام محددة بدقة. تمر عبر هذه الثقوب جزيئات من نوع واحد بينما تعلق جزيئات أخرى — وهذا أساس تنقية المياه وفصل الغازات والتحفيز في البتروكيماويات. لكن ابتكار زيوليت جديد على الورق أسهل بكثير من زراعته في المختبر: يجب أن تتوفر عشرات الشروط الدقيقة للبلورة.
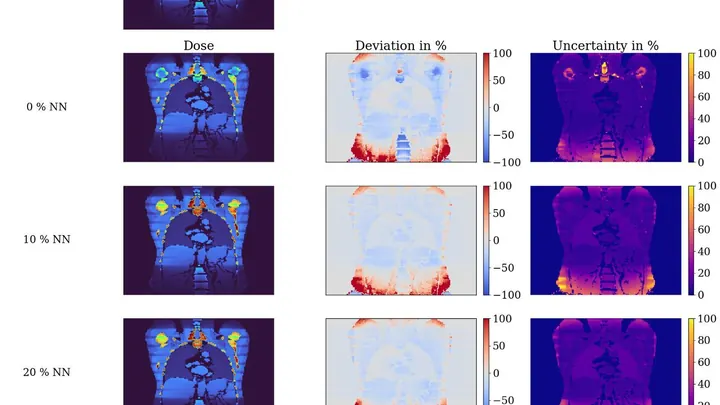
التصوير المقطعي المحوسب يشبه الأشعة السينية التي تلتقط مئات الصور من زوايا مختلفة ثم تجمعها في صورة ثلاثية الأبعاد للجسم. لكن كل صورة تعني جرعة صغيرة من الإشعاع، ويحتاج الأطباء إلى معرفة مقدار ما يتلقاه كل عضو. حاليًا، غالبًا ما يُقدَّر هذا بشكل تقريبي باستخدام جداول متوسطة، وليس بناءً على حالة المريض نفسه.