Procesamiento de Audio y Voz eess.AS

23 artículos

artículos

Cómo aprende una máquina a distinguir los sonidos del habla
Una maestra en clase explica la diferencia entre «casa» y «caza»: ponte la mano en la garganta y siente la vibración. Una máquina que reconoce el habla hace algo parecido, solo que dentro no tiene garganta, sino largas listas de números. Resulta que esos números se pueden ordenar en estantes, como bloques con letras en una guardería.
Sonido2026-03-071 minarXiv:2603.07215exprés
Un estetoscopio que escucha el intestino
El intestino habla con el médico, pero muy bajito. Los gruñidos y gorgoteos duran fracciones de segundo y se pierden fácilmente entre los sonidos de los pulmones y el corazón. El estetoscopio capta solo una pequeña parte, por lo que el diagnóstico depende de la experiencia y el oído del médico concreto.
Física Aplicada2026-06-072 minarXiv:2606.08524exprés
Enmascaramiento acústico: el sonido sustituye a la realidad
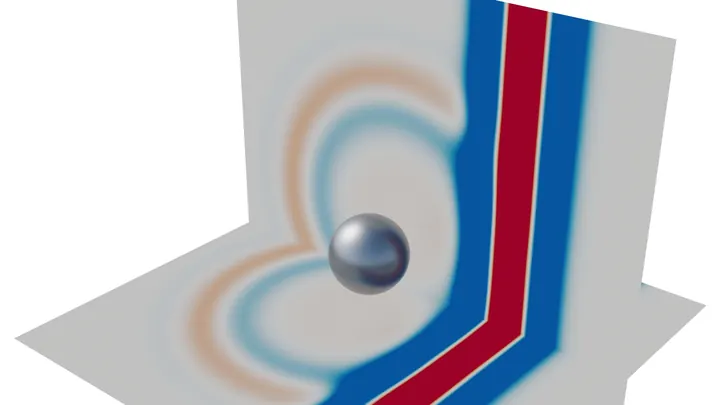
Si aplaudes en una habitación vacía, el eco revelará su tamaño y forma. Cada objeto —una silla, un libro, una persona— añade su propia firma a ese eco: el sonido se refleja en él de una manera particular. Los autores del artículo han ideado cómo reescribir por completo esa firma sonora. Rodearon una región del espacio con una superficie cerrada de micrófonos y altavoces.
Bola sonora: cómo los micrófonos dejaron de equivocarse
Un micrófono cardioide común, como una oreja, oye mejor de frente, pero sus lecturas se emborronan si el sonido viene de lado. La solución es reunir varias de estas «orejas» en una esfera. Así se obtiene una bola sonora que capta la señal desde todas las direcciones.
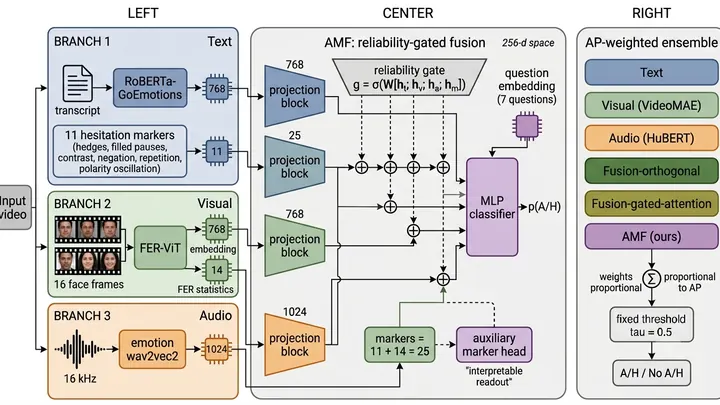
La duda se delata en el silencio: la IA lee las pausas
Un nuevo sistema analiza una entrevista corta para reconocer las dudas de una persona, combinando texto, voz y expresión facial. Pero la clave principal de la inseguridad resultó ser la materia oscura del habla: pausas y muletillas que los sistemas de voz estándar borran como un agujero negro.
Sonido limpio: por qué el volumen es más importante que la fase
Limpiar el habla del ruido es como intentar sintonizar un televisor viejo: si giras demasiado la perilla de contraste, los rostros se vuelven artificiales.
Amnesia lingüística de las redes neuronales: ¡existe una solución!
Una gran red neuronal, como Whisper, domina cientos de idiomas y recuerda al modelo estándar del universo: todo está equilibrado. Pero entrenarla en un idioma raro rompe el equilibrio: se convierte en un agujero negro que atrae todos los recursos de aprendizaje. La red comienza a olvidar los demás idiomas.
Concentrado de sonido: cómo transmitir la voz sin bits innecesarios
El método estándar de digitalización de voz: se toman lecturas de volumen miles de veces por segundo. Es como probar un caldo con una cucharadita: cada sorbo es aguado y casi no hay detalles. El flujo de datos se hincha, aunque el significado es ínfimo. Los científicos propusieron primero ‘reducir’ la señal de audio.
Red neuronal que escucha la fase
El sonido se describe naturalmente con un número complejo, donde el volumen es la fuerza de la onda y la fase su posición en el tiempo. Las redes neuronales convencionales lo descomponen en dos coordenadas independientes, como si para dar una dirección dijeran: «dos al este, uno al norte».
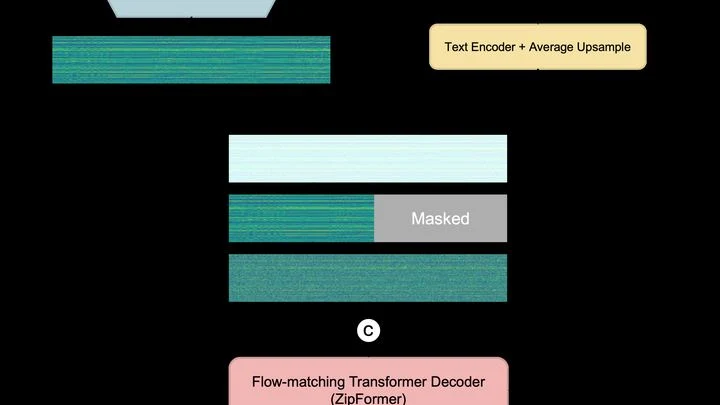
ZipL-Dialog: la síntesis de voz se vuelve 11 veces más económica
Antes, la locución de un texto largo, como un audiolibro, requería que el ordenador tuviera en mente una imagen detalladísima de cada segundo de sonido, como si para una conversación de una hora hubiera que dibujar un plano milimétrico de todo el recorrido. Esos «mapas» eran enormes, e incluso máquinas potentes se atragantaban, ensamblando el habla por partes.
Los audífonos aprenden a saborear el sonido
Los audífonos tradicionales se parecen a un cocinero que sigue una receta a ciegas. Analizan el desorden sonoro del micrófono y, basándose en él, amplifican el habla. En una cafetería ruidosa, este enfoque a menudo falla. El nuevo sistema se comporta como un chef experimentado: primero procesa la señal y luego prueba el resultado.
Cómo una computadora aprende a escuchar a todos en una habitación ruidosa
En una habitación ruidosa, una persona distingue la voz deseada gracias a los dos oídos, que captan la diferencia en la llegada del sonido. Una computadora con varios micrófonos actúa de la misma manera: recibe pistas espaciales, de dónde habla cada uno. Antes, estas pistas se usaban para enfocarse en una sola dirección, como el haz de una linterna.
Audiodiarización: cómo un algoritmo capta cualquier evento sonoro sin conocimiento previo
El oído humano está diseñado de tal manera que el cerebro destaca principalmente los patrones conocidos: la voz del interlocutor, el ruido de la lluvia, la bocina de un coche. Sin embargo, el nuevo sistema funciona con un principio diferente: detecta cualquier ráfaga sonora, incluso una que nunca antes se haya encontrado.
Cómo los auriculares aprendieron a ver la fuente del ruido
La cancelación activa de ruido crea un «antisonido» para eliminar el ruido. Pero los sistemas convencionales son ciegos: no saben de dónde proviene el sonido. En habitaciones con eco, es como boxear con los ojos vendados: cancelas a ciegas.
Cómo adelgazó la red neuronal que genera sonidos
La red neuronal que genera sonidos a partir de texto se parece a una cocina donde cada «plato» lo preparan decenas de cocineros. Muchos solo estorban: envían señales falsas y malgastan recursos.
Cómo la IA dejó de confundir los sonidos en los guiones
Los modelos que convierten texto en audio recrean bien los sonidos individuales, pero se confunden cuando en el guión hay varios. Por ejemplo, según el guión primero suena el timbre, luego los pasos, después el portazo. El generador puede alterar los eventos y el oyente escuchará los pasos antes del timbre.
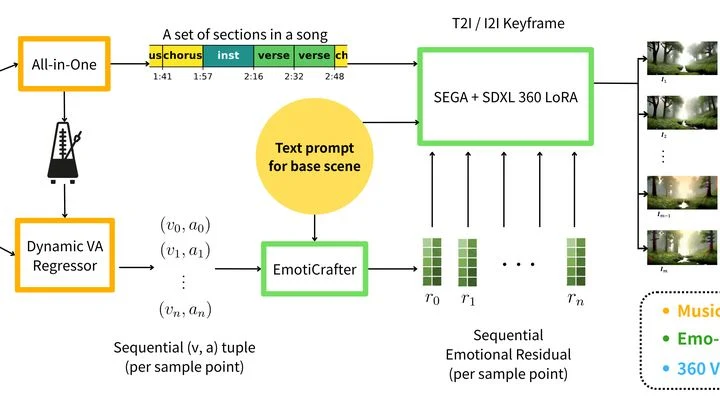
El horizonte musical: cómo una canción adquiere volumen
El director sostiene no una batuta, sino un pincel, y cada movimiento da vida a color y forma. La nueva tecnología funciona de manera similar: convierte el estado de ánimo de la canción en un vídeo panorámico que envuelve al oyente. Primero, el algoritmo, al igual que el análisis de la luz por el espectro, descompone la pista en emociones.
Sonido2026-07-151 minarXiv:2607.13477exprés
Los jueces de IA no escuchan con oídos, sino con etiquetas
Los jueces automáticos del habla son algoritmos que evalúan la pronunciación y las emociones. Sin embargo, a menudo funcionan como un crítico culinario que emite un veredicto tras leer el menú, pero sin probar el plato.
La computadora evaluó la pronunciación sin pistas
Aprender un idioma extranjero es como afinar un instrumento musical. La nueva tecnología funciona como un afinador inteligente: toma tu grabación y el habla de referencia de un nativo, las estira o comprime en el tiempo (como se tensa una cuerda) para alinearlas con precisión, y evalúa tres parámetros principales: la pureza de los sonidos, la precisión rítmica y la…
Cocinando una voz viva: el dataset ruso que enseña a los asistentes a sentir
Los asistentes de voz a menudo recuerdan a un cocinero que lee una receta en papel sin sombra de apetito. El nuevo archivo de diálogos rusos 'Diálogos' cambia las reglas: tres actores en el estudio, como chefs, mezclaron 20 horas de conversaciones reales con doce 'especias' emocionales. Cada réplica recibió una etiqueta de estilo y emoción, resultando un libro completo de sabores.
WanSong: canciones del ruido en un solo paso
WanSong crea música como un escultor talla una estatua: comienza con ruido, similar al rugido de una cascada, y poco a poco elimina todo lo superfluo hasta que emergen notas y voces puras. Este método — difusión — transforma el caos en orden, como la tinta que se dispersa en el agua, pero al revés. El modelo no pega sonidos a partir de fragmentos, sino que da a luz una canción terminada de una vez.
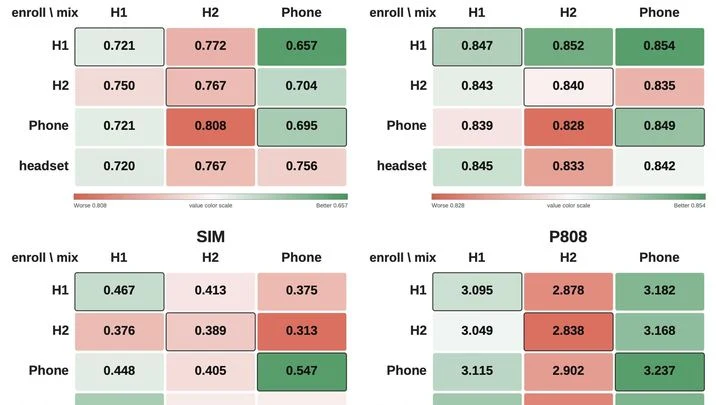
Cómo pescar la voz de un amigo en medio del bullicio
El ser humano extrae sin esfuerzo la voz deseada del bullicio de una fiesta. Para una computadora, lo mismo es aún una tarea al límite de sus posibilidades. Los programas anteriores se entrenaban con grabaciones estériles, sin eco ni pitidos de aparatos.
La ilusión de la precisión: cómo la validación de la IA en acústica induce a error
La inteligencia artificial que predice la acústica de una sala se parece a un estudiante en un examen con una chuleta. Si los puntos de prueba son los mismos que los de entrenamiento, el modelo simplemente memoriza la 'huella sonora' de cada posición, como un estudiante que reconoce el examen por una esquina doblada.