El aprendizaje contrastivo es un enfoque en el aprendizaje automático que permite construir representaciones de datos de alta calidad sin etiquetas (auto-supervisado). Se basa en el concepto de pérdida contrastiva: el modelo atrae las representaciones (embeddings) de objetos semánticamente cercanos (pares positivos) y repele las representaciones de los no relacionados (pares negativos). Por ejemplo, para imágenes, los pares positivos son diferentes vistas (aumentos) de la misma foto, y los negativos son cualquier otra imagen en el mini-lote. Así, la red neuronal aprende a extraer características invariantes, ignorando variaciones irrelevantes de iluminación, rotación o escala. Este método es la base de muchos sistemas modernos de reconocimiento, donde a menudo supera al aprendizaje supervisado cuando hay pocas etiquetas.
Historia
Sus raíces se remontan al aprendizaje métrico: las redes siamesas (Bromley et al., 1993) para comparar firmas. En 2006, Hadsell y LeCun propusieron la pérdida contrastiva para aprender representaciones invariantes. El resurgimiento del interés está ligado al progreso en el aprendizaje auto-supervisado para imágenes: en 2018, el modelo InstDisc (Wu et al.) utilizó un banco de memoria; los avances decisivos llegaron con MoCo (He et al., 2020), que emplea una cola de ejemplos negativos, y SimCLR (Chen et al., 2020), con un gran tamaño de lote y fuertes aumentos. Estos trabajos demostraron que el preentrenamiento contrastivo alcanza una precisión cercana a la supervisada, y a veces la supera al reentrenar con pocos datos. Posteriormente, el enfoque se adaptó a vídeo, audio, grafos y datos multimodales (CLIP, 2021).
Cómo funciona
El algoritmo consta de tres etapas: (1) el aumento estocástico de datos crea dos representaciones independientes de una misma entrada (por ejemplo, recorte aleatorio, distorsión de color); (2) el codificador (ResNet, ViT) las mapea a vectores en un espacio latente; (3) una cabeza de proyección (MLP) los transforma a un espacio de menor dimensión donde se calcula la pérdida contrastiva InfoNCE: L = -log[ exp(sim(z_i, z_j)/τ) / ∑_{k=1}^{2N} 1_{k≠i} exp(sim(z_i, z_k)/τ) ], donde sim es la similitud coseno y τ el parámetro de temperatura. La optimización reduce la entropía cruzada entre la distribución de pares positivos y negativos. Para evitar el colapso representacional (que todos los vectores degeneren en un solo punto), se emplean mecanismos como: pares negativos de una cola (MoCo), parada de gradiente y predictor (BYOL), o agrupamiento (SwAV). Al final, el espacio latente adquiere una estructura semántica invariante a las transformaciones aplicadas.
En la práctica
Reconocimiento facial sin etiquetas, búsqueda de imágenes similares en grandes archivos, mejora de diagnósticos a partir de imágenes médicas cuando hay pocos datos etiquetados.
Dato curioso
El sistema CLIP de OpenAI, entrenado de forma contrastiva con pares imagen-texto, es capaz de dibujar cuadros a partir de descripciones, aunque nunca se le enseñó estilo artístico directamente: simplemente captó las interrelaciones.
Un intérprete en una sala donde se hablan tres idiomas a la vez al principio solo oye un ruido general. Pero si empieza a repreguntar, a prestar atención a las entonaciones y a precisar una y otra vez quién respondió con qué frase, poco a poco las voces individuales emergen de la cacofonía.
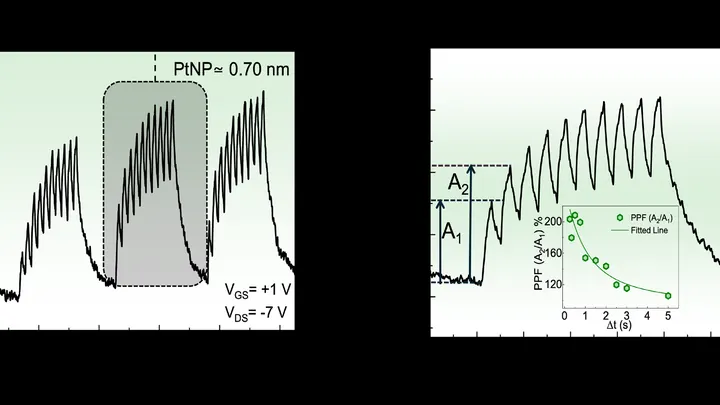
Una película de plástico del grosor de un cabello, y en su interior, puntos de platino de menos de una millonésima de milímetro. Estos puntos se sitúan en la frontera entre dos capas del transistor y atrapan la carga eléctrica como una esponja atrapa el agua. Cuando la carga se acumula, el transistor cambia su resistencia y recuerda ese estado.
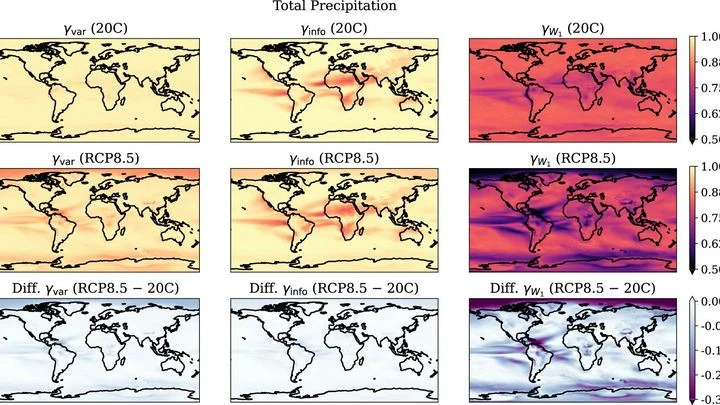
En invierno, en un barrio de la ciudad cae el triple de nieve que en el vecino. Un año hace calor, otro frío. Son los caprichos del tiempo. Pero a lo largo de décadas se observa otro cambio, más lento: los inviernos, en promedio, se vuelven más suaves. Distinguir uno de otro es la tarea principal de los climatólogos.
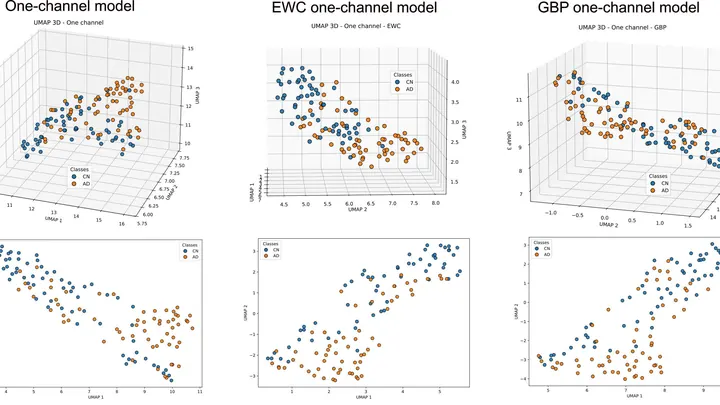
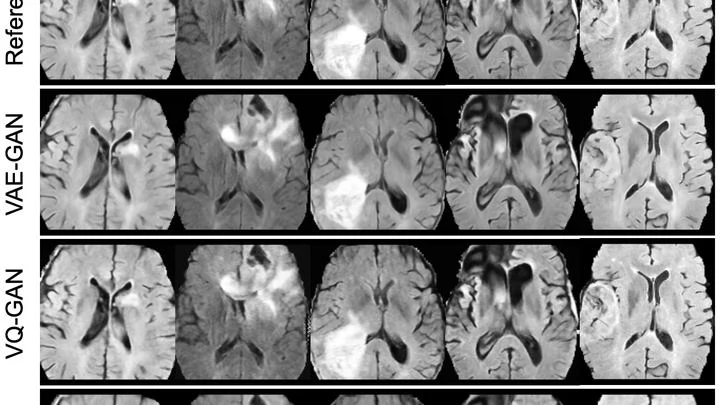
Un médico tarda años en aprender a reconocer enfermedades en imágenes cerebrales. Primero ve perfectamente los signos del envejecimiento, luego domina los tumores, y de repente empieza a confundirse con lo que sabía antes. Muchas redes neuronales se comportan de manera parecida: los conocimientos nuevos borran los antiguos.
En el almacén hay cajas con manzanas y peras. Hay muchas manzanas y pocas peras. Pero cuando el encargado dice «fruta con piel lisa», por alguna razón recordamos más a menudo la rara pera que la frecuente manzana. Eso es el efecto de la tasa base inversa: un fallo persistente en cómo el cerebro resuelve la ambigüedad entre categorías.
En 1998, el matemático David Boyd notó algo extraño. Estudiaba la medida de Mahler de un polinomio —una cantidad que mide la "complejidad" de sus raíces— y descubrió que para una familia de curvas siempre se expresa como un número racional especial racional multiplicado por el valor de la derivada de la función L.
Predecir el rendimiento de una reacción química es como intentar adivinar la cosecha conociendo solo la composición del suelo. Tradicionalmente, los químicos se apoyaban en largas columnas de números —los descriptores cuánticos— que describen la energía de los electrones, pero no dicen nada sobre la forma de la molécula.
La red neuronal predice el futuro de un sistema, por ejemplo, cómo se arremolina el plasma en un campo magnético o cómo cambia un rostro en un video. Los errores son inevitables, y cuanto más lejos mira hacia adelante, más se acumulan. En el momento de la operación es imposible contrastar con la respuesta correcta: simplemente no existe.
Cada mañana docenas de telescopios apuntan al Sol. Sus cámaras captan una angosta banda de luz roja: la línea Hα, descubierta por Johann Jakob Balmer. En las imágenes aparecen hebras oscuras, caprichosamente curvadas. Parecen puntadas de un tapiz gigante que cose la corona ardiente. Son los filamentos solares.
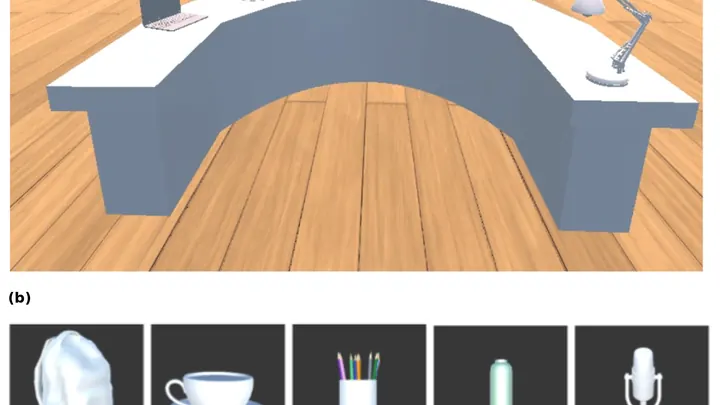
Una prótesis ocular no transmite al cerebro una fotografía, sino un punteado escaso de puntos brillantes: los fosfenos. Para distinguir en ese parpadeo una taza o unas llaves, la persona debe mover la cabeza como una linterna en la oscuridad e ir juntando poco a poco los contornos del objeto. Es un proceso lento, parecido a armar un rompecabezas al que le faltan la mayoría de las piezas.
Un IA común ve las imágenes médicas como rompecabezas de fragmentos desconocidos: dos imágenes no emparejadas las considera completamente diferentes. Es como intentar distinguir a gemelos sin saber que son familia. En medicina, los pacientes con la misma enfermedad se ven casi iguales en la resonancia, y el algoritmo se equivoca al confundir a los «parientes».
Una señal de radio con modulación en capas se asemeja a los estratos culturales de una ciudad antigua: cada nivel lleva su propia información, pero con el tiempo se enredan debido a las interferencias. Los algoritmos comunes se pierden en esta mezcolanza. El nuevo método TSDN actúa como una red neuronal arqueóloga.
El volumen de datos de una sola tomografía computarizada es comparable a varias películas de larga duración. TCAM-Diff evita este cuello de botella: el programa comprime la imagen tridimensional en tres proyecciones de sombra, como un escultor reconstruye una estatua tridimensional a partir de siluetas en tres paredes.
El enfoque estándar para una clase de problemas de aprendizaje automático se asemeja a un resorte que se estira y se olvida soltar: los métodos estándar inflan artificialmente el tamaño del problema, convirtiendo los cálculos en un agujero negro de memoria y tiempo.
El cerebro se comunica con breves chasquidos eléctricos. Antes, para aprender este lenguaje, se necesitaban miles de ejemplos traducidos por un experimentador. El método MOJO sigue otro camino: como cuando se aprende un idioma por inmersión, primero escucha el 'flujo de conciencia' sin pistas y encuentra por sí mismo patrones repetitivos.
Un conductor en una carretera resbaladiza no sabe exactamente cómo reaccionará el coche al volante, y aprende sobre la marcha, dejando margen para el error. De manera similar se comporta un algoritmo de control inteligente.
Un niño que explora un apartamento desconocido gatea de un objeto a otro y recuerda lo que se ve desde cada rincón. Así, el cerebro construye un mapa mental: un modelo interno del espacio. El algoritmo gradCSCG funciona con el mismo principio: recibe un flujo de video de una cámara y dibuja de forma autónoma el esquema de la habitación, basándose únicamente en el cambio de las imágenes.
Cuando presionas «ensalada» y el teclado sugiere «César», detrás de escena millones de teléfonos están aprendiendo juntos a predecir palabras. No intercambian tus mensajes, solo mejoras del algoritmo común, como un entrenador que envía a los atletas solo los cambios en el plan: «añade 5 flexiones a las de ayer». La entropía de la información ayuda a enviar solo correcciones valiosas e inesperadas.
En una cocina con hornillas de gas, cada una calienta a su manera. Si el cocinero cambia las ollas de lugar, la comida puede quemarse. Lo mismo ocurre en una red inalámbrica: las antenas-hornillas y los usuarios-ollas requieren una colocación precisa. Las redes neuronales comunes no distinguen posiciones, considerando todas las hornillas iguales.
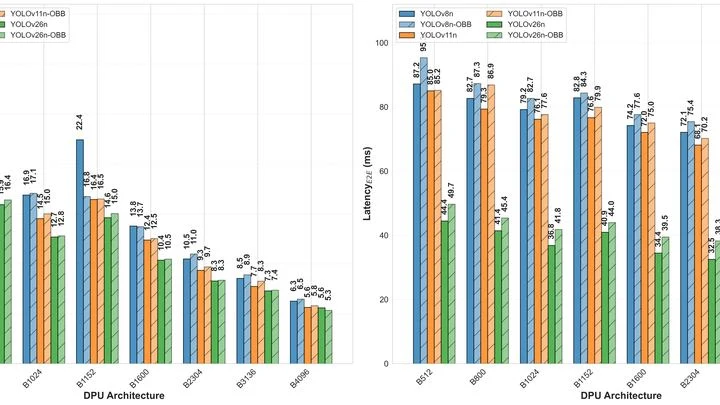
Los sistemas modernos de visión artificial están ganando autonomía: los ingenieros han logrado implementar un algoritmo de reconocimiento de patrones directamente en un chip diminuto, liberando a la cámara de la necesidad de enviar datos a una computadora voluminosa.
La catenaria ferroviaria se asemeja a una galaxia: la energía fluye por ella como la gravedad, y los trenes se convierten en planetas. Cuantos más trenes consumen corriente simultáneamente, más fuertes son las oscilaciones de voltaje: recorren el sistema ondas gravitacionales que amenazan con apagones.
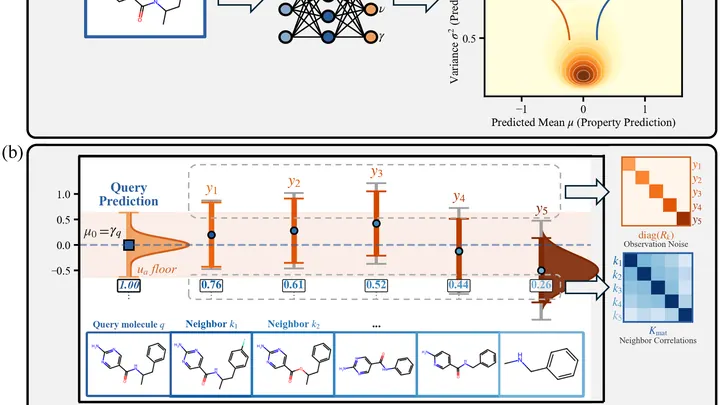
Predecir las propiedades de una nueva molécula es como adivinar el sabor de un plato desconocido. El programa funciona como un cocinero experimentado: «prueba» moléculas similares cuyas propiedades ya se conocen y, basándose en su «sabor», ajusta su conjetura.
Una gran red neuronal, como Whisper, domina cientos de idiomas y recuerda al modelo estándar del universo: todo está equilibrado. Pero entrenarla en un idioma raro rompe el equilibrio: se convierte en un agujero negro que atrae todos los recursos de aprendizaje. La red comienza a olvidar los demás idiomas.
El aprendizaje automático hace tiempo que dejó de ser una simple herramienta: se está convirtiendo en un investigador que extrae por sí mismo las leyes de la naturaleza de los datos. Pero, ¿cómo llega la mente de silicio a la comprensión?
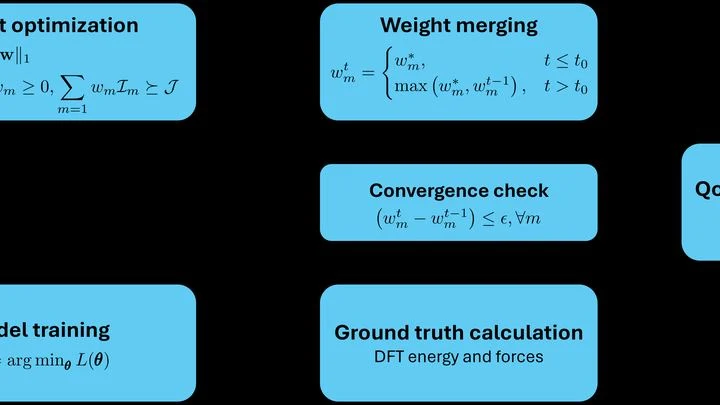
DFTB es un tren de alta velocidad en el mundo de la química cuántica: cientos de veces más rápido que el DFT clásico, pero aún sobre rieles electrónicos. Sin embargo, su motor — la autoconsistencia iterativa de cargas — a veces se asemeja a una orquesta donde cada instrumento comienza con una nota arbitraria.
El microlente gravitacional es un asombroso efecto cósmico, predicho por Einstein y desarrollado por Zwicky. Un cuerpo masivo que pasa entre nosotros y una estrella lejana curva su luz como una lente, creando amplificaciones y distorsiones características.
Las profundidades del cosmos no callan: están llenas de mensajes cifrados. Cada estrella, cada cuásar emite su propio código de luz titilante: rítmico, como el morse de una cefeida, o caótico, como un cifrado hackeado de una supernova. Los astrónomos interceptan estas señales por millones cada noche, pero ¿cómo leerlas sin una clave?
El oro no está en la superficie: se esconde en toneladas de roca estéril. Para extraer un gramo del metal precioso, los buscadores tamizan metros cúbicos de tierra.
Durante siglos, los astrónomos escrutaron el cielo nocturno captando los más mínimos cambios en el brillo de las estrellas. Estas series irregulares — curvas de luz — son como pentagramas: cada estrella interpreta su propia melodía única.
Crear un material con propiedades predeterminadas es un arte que durante mucho tiempo dependió de la intuición y la suerte. La naturaleza no da pistas: decenas de elementos en la tabla periódica, y el número de sus combinaciones tiende al infinito. Antes, los científicos de materiales parecían alquimistas que probaban todo a ciegas, o confiaban en modelos estadísticos que perdían fuerza más allá de lo conocido.
Los refrigeradores y aires acondicionados actuales que utilizan freones envenenan la atmósfera de forma casi invisible. La alternativa son los materiales calóricos sólidos, que se enfrían por un cambio rápido de presión gracias al efecto barocalórico.
El cerebro no aprende cada tarea desde cero: transfiere experiencia de una actividad a otra. Pero, ¿cómo saber qué tareas son realmente afines? Los neurocientíficos idearon un truco ingenioso: dejar que una red artificial "espíe" la actividad cerebral durante una tarea e intente predecir la actividad durante otra. Si lo logra bien, las tareas son cercanas.
Los detectores de rayos X funcionan como un panal de abejas: en las celdas hexagonales, partículas brotan aquí y allá. Los algoritmos convencionales estiran estos panales sobre una cuadrícula cuadrada, lo que genera falsos fantasmas de polarización.
Danza de cientos de partículas: algunos pares giran lenta y suavemente, otros se sacuden a un ritmo frenético. Para entender la esencia del baile, hay que fijarse en los movimientos lentos: son la coreografía principal del sistema.
Un chef no gasta ingredientes preparando el plato entero para probar el sabor; simplemente prueba una gota de salsa. La misma lógica está en el método de ‘emparejamiento informativo’ para predecir la resistencia de los metales.
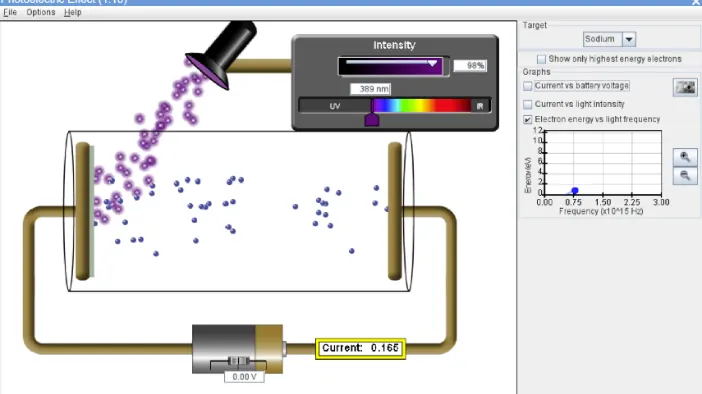
Entender el efecto fotoeléctrico —cuando la luz arranca electrones de un material— es como aprender a cocinar sin receta. Las herramientas digitales vienen al rescate: los juegos dan intuición, las simulaciones, precisión.
Un traductor no aprende un idioma con un libro de texto, sino escuchando el habla viva y viendo de inmediato qué hace la gente en respuesta a las palabras. Así funciona el nuevo método C3P para leer ADN bacteriano. Los modelos genómicos habituales intentan aprender las reglas simplemente "releyendo" miles de millones de letras del código genético, y a menudo se confunden.
En el océano de transacciones bancarias, los fraudes son más raros que las estrellas de neutrones en el cosmos — apenas un 0.1% de todas las operaciones. Un detector común se acostumbra al flujo limpio y pierde vigilancia.
Aquí entra en juego el sistema híbrido Q-SYNTH con un generador cuántico.
Pruebas un plato en un restaurante, pero no has visto el menú. Le haces preguntas al camarero: ¿está muy salado? ¿qué especias tiene? — y por las respuestas intentas adivinar qué chef lo preparó.
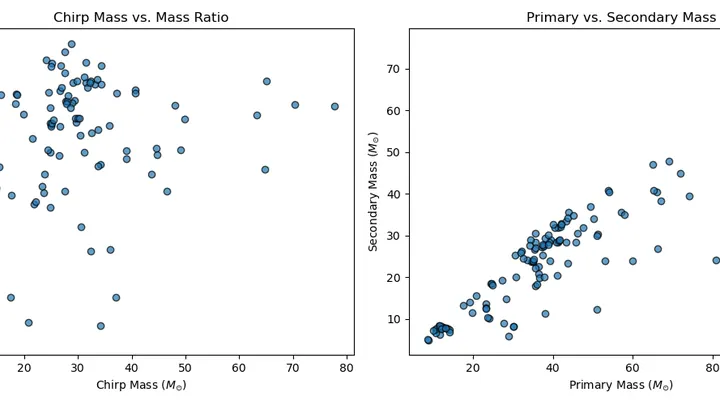
La sinfonía suena, pero en la partitura se ha colado una nota falsa apenas perceptible. Así, más o menos, buscan los físicos desviaciones de la relatividad general en los 'sonidos' del universo: las ondas gravitacionales producidas por la fusión de agujeros negros.