Синтетические данные — это информация, которая создается искусственно, а не собирается из реальных событий. В контексте представленных статей они используются для обучения моделей машинного обучения без доступа к реальным данным пациентов, которые часто являются чувствительными и защищены нормами конфиденциальности. Это понятие является центральным в таких областях, как медицинская визуализация, где можно создавать цифровые двойники пациентов или органов для моделирования состояний и безопасного тестирования алгоритмов.
История
Термин приобрел известность в 2010-х годах с развитием глубокого обучения, хотя основная идея генерации искусственных данных для тестирования уходит корнями в более ранние методы моделирования. Ни один конкретный изобретатель не упоминается.
Как это работает
Процесс обычно включает использование генеративных моделей, таких как генеративно-состязательные сети (GAN) или вариационные автокодировщики, для изучения статистического распределения реальных данных и последующей выборки новых правдоподобных примеров из этого распределения. Эти синтетические примеры могут быть размечены с известной истинной меткой, что позволяет обучать и проверять модели в контролируемой среде. Сгенерированные данные могут имитировать конкретные состояния, такие как различные стадии заболевания или артефакты изображений, которые могут быть редкими или труднодоступными в реальных наборах данных.
Где применяется
Синтетические данные используются для обучениядиагностических моделей в медицинской визуализации, для дополнения небольших реальных наборов данных и для тестирования автономных систем в моделируемых средах перед развертыванием в реальном мире.
Любопытный факт
Синтетические данные могут использоваться для генерации изображений редких заболеваний, которых так мало, что реальных примеров было бы недостаточно для обучения надежной диагностической модели.
В отличие от традиционных камер, которые захватывают полный кадр с фиксированной частотой, событийные сенсоры действуют иначе: каждый пиксель независимо реагирует лишь тогда, когда локальная яркость изменяется — становится заметно больше или меньше. Результат — не привычный снимок, а непрерывный поток событий, своего рода «вспышек» с координатами, временем и знаком изменения.
В любом городском проекте поведение жителей выступает как невидимая сила — скрытая переменная, от которой зависит успех. Один сомневающийся сосед способен затормозить установку солнечных панелей на целый квартал: его осторожность запускает рост энтропии — меры беспорядка в системе.
Представьте повара, который учится готовить исключительно по рисованным картинкам — он почти наверняка испортит каждое блюдо. Схожая ловушка подстерегает и компьютерное зрение: для обучения моделей требуются тысячи размеченных снимков, но собирать и аннотировать их вручную — дорого и муторно.
Стандартный подход к оцифровке речи, лежащий в основе современных телекоммуникаций, — это прямая дискретизация: тысячи раз в секунду фиксируется мгновенная громкость сигнала. Представьте, что вы пробуете бульон чайной ложкой — каждый глоток даёт лишь слабый намёк на вкус, а чтобы уловить букет, приходится черпать снова и снова.
Представьте прослушивание в симфонический оркестр, где из сотен претендентов остаются лишь те, чьи инструменты звучат чисто и выдерживают яростное крещендо. В мире материалов компьютеры научились генерировать «атомные партитуры» — тысячи виртуальных кристаллов, обещающих стать основой для квантовых чипов или сверхпроводников.
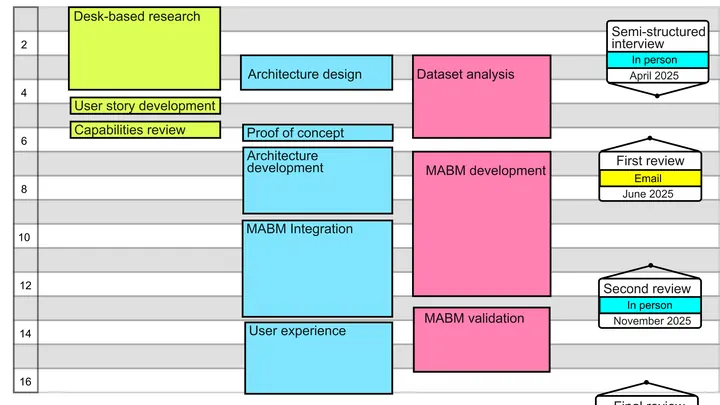
Сто двадцать жителей Монтелаго — не люди, а цифровые персонажи. У каждого, помимо имени и биографии, три скрытые координаты: доверие к муниципальным властям, оценка достоверности источника, воспринимаемая адекватность информации. Эти числа известны создателям, но не самой системе.
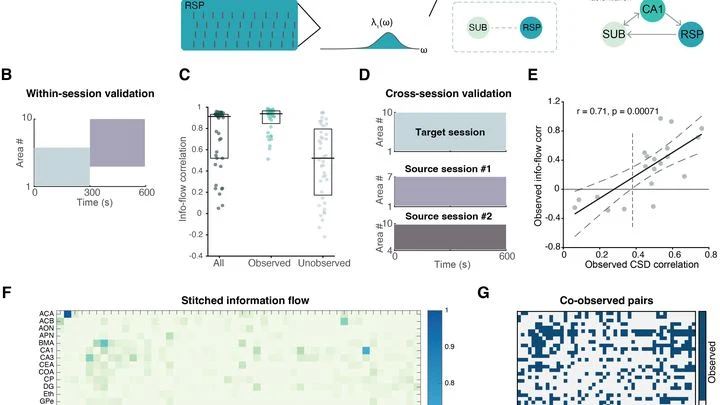
Лоскутное одеяло, где каждый лоскут — запись активности небольшого участка мозга. Один лоскут сшили в понедельник в Лондоне, другой — во вторник в Нью-Йорке, а третий вообще месяц назад в Токио. Вся эта мозаика покрывает мозг лишь частично, и нет общего шва, чтобы их соединить.
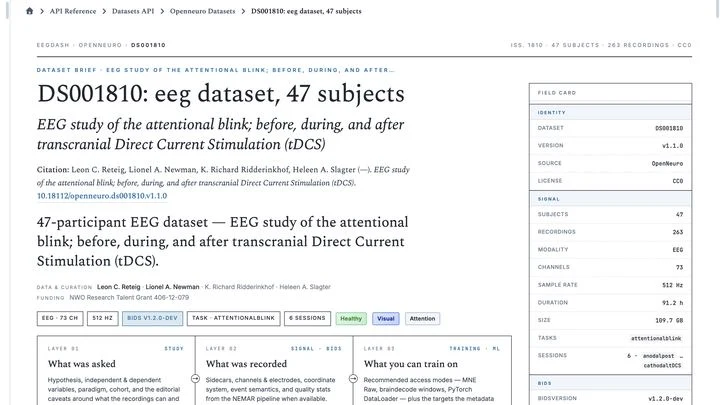
В открытых архивах OpenNeuro и NEMAR хранится 791 запись электрической активности мозга от почти сорока тысяч человек. Суммарно это 86 051 час сигналов — примерно десять лет непрерывного прослушивания. Раньше, чтобы взять с полки хотя бы одну такую запись, приходилось писать тысячи строк кода: скачать, распаковать, исправить ошибки формата, нарезать на куски нужной длины.
EEG-Dash работает как умный библиотекарь.
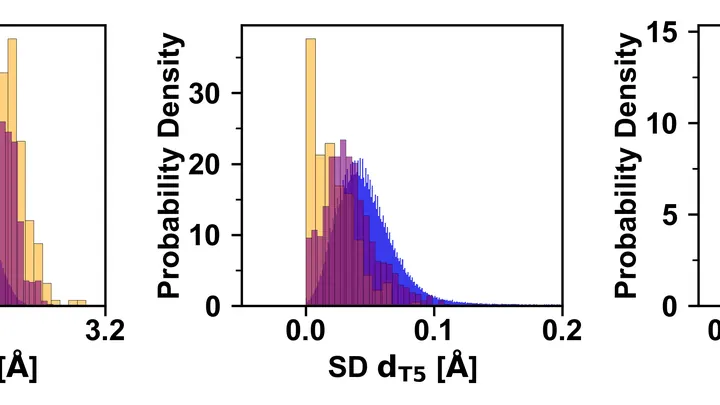
Танец сотен частиц: одни пары кружатся медленно и плавно, другие дёргаются в бешеном ритме. Чтобы понять суть танца, нужно следить именно за медленными движениями — они и есть главная хореография системы. В науке о молекулах такие медленные движения называют «медленными модами», и именно они определяют, как белок сворачивается в клубок или как лекарство связывается с мишенью.
Рука поднимает с полки чашку — привычное движение, которое мы не замечаем, пока мышцы не устанут. Тогда траектория меняется: локоть уходит чуть в сторону, кисть подрагивает. Врач обычно ловит эти перемены руками, ощупывая мышцы пациента.
Водород — чемпион по энергии на килограмм, но хранить его — морока. В виде газа он занимает огромный объём, а если сжать или охладить до жидкости, нужны тяжёлые баллоны и много энергии. Есть третий путь: некоторые твёрдые материалы впитывают водород, как губка впитывает воду, и держат его внутри себя. Нагрел — водород вышел, остудил — впитался обратно.
Повар пробует суп после каждой щепотки соли и тут же решает, что добавить дальше. Примерно так работает новая установка для выращивания тонких кристаллических плёнок. Только вместо вкуса — картинка с электронного микроскопа, а вместо повара — компьютерная программа.
Обычно, чтобы получить плёнку нужного состава, приходится перебирать десятки сочетаний температуры, давления и состава паров.
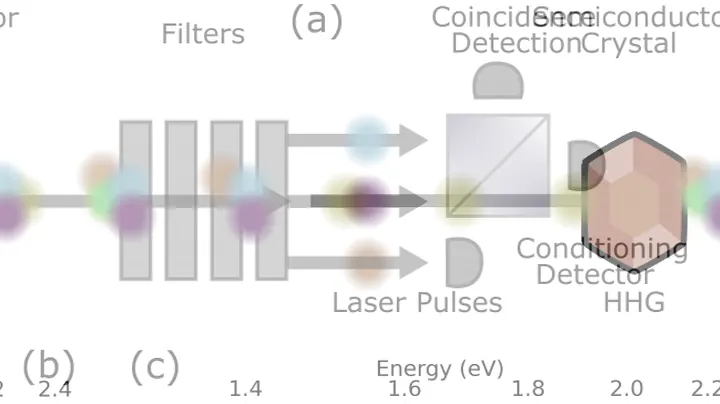
Когда мощный лазерный импульс попадает в полупроводник, кристалл откликается излучением на множестве частот — словно струна, звучащая хором обертонов. Этот эффект давно служит инструментом спектроскопии для наблюдения сверхбыстрых процессов.
Ночью человек дышит, и по ритму этого дыхания можно многое сказать о его сне. Но обычно врачи смотрят на электрические волны мозга — их записывают датчиками на голове. Новая работа показывает, как по одному лишь дыханию восстановить эти волны, не касаясь головы.
Модель работает как переводчик с языка тела на язык мозга.
Пористые минералы-цеолиты работают как крошечные губки с отверстиями строго определённого размера. Через такие отверстия проходят молекулы одного сорта и застревают другие — на этом построена очистка воды, разделение газов и катализ в нефтехимии. Но придумать новый цеолит на бумаге гораздо проще, чем вырастить его в лаборатории: у кристалла должны сойтись десятки тонких условий.
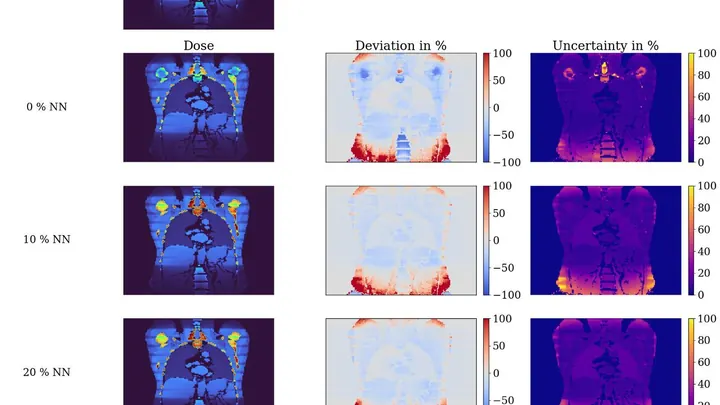
Компьютерная томография — это как рентген, который делает сотни снимков с разных сторон и собирает из них объемную картинку тела. Но каждый снимок — это небольшая доза радиации, и врачам нужно знать, сколько ее получил каждый орган. Сейчас это часто оценивают грубо, по средним таблицам, а не по конкретному пациенту.
Исследователи научили нейросеть предсказывать дозу для каждого органа.