La validación cruzada es una familia de técnicas para estimar qué tan bien se desempeñará un modelo estadístico con datos nuevos y no vistos. La idea central es dividir los datos disponibles en partes separadas: una parte se usa para entrenar el modelo y la otra para probarlo. Esto imita la situación real en la que un modelo debe hacer predicciones sobre datos que nunca ha encontrado, ofreciendo una medida más honesta de su poder predictivo que simplemente volver a probar con los datos de entrenamiento.
Historia
El concepto fue introducido por Seymour Geisser en 1975, basándose en trabajos anteriores sobre división de datos y predicción.
Cómo funciona
La forma más común es la validación cruzada de k pliegues. Los datos se dividen aleatoriamente en k pliegues de igual tamaño. El modelo se entrena con k−1 pliegues y se prueba con el pliegue restante. Este proceso se repite k veces, usando cada vez un pliegue diferente como conjunto de prueba. La estimación final del rendimiento es el promedio de los k resultados de prueba. Esto utiliza todos los datos tanto para entrenar como para probar, reduciendo la varianza de la estimación en comparación con una sola división.
En la práctica
Se utiliza en el aprendizaje automático para ajustar hiperparámetros, seleccionar entre modelos competidores y reportar cifras de precisión realistas.
Dato curioso
En la validación cruzada de dejar uno fuera, un caso especial donde k es igual al número de puntos de datos, el modelo se entrena con todos los puntos excepto uno y se prueba con ese único punto, repitiéndose para cada punto.
La orquesta toca sin director. Cada instrumento entra según su propio calendario: el violín el lunes, la flauta el miércoles, los timbales el sábado. Los astrónomos no oyen música, sino notas sueltas dispersas en el calendario. El telescopio ve la estrella solo cuando está sobre el horizonte y cuando el calendario le ha reservado tiempo.
Imagina que intentas averiguar qué ocurrió en una habitación por el sonido que queda después de un disparo. El disparo ya no está, pero el eco aún resuena en las paredes. Así, aproximadamente, un neuropatólogo observa un corte de tejido cerebral en el que no aparece el tumor: la biopsia solo ha tomado tejido sano que ha reaccionado a la enfermedad.
En el almacén hay cajas con manzanas y peras. Hay muchas manzanas y pocas peras. Pero cuando el encargado dice «fruta con piel lisa», por alguna razón recordamos más a menudo la rara pera que la frecuente manzana. Eso es el efecto de la tasa base inversa: un fallo persistente en cómo el cerebro resuelve la ambigüedad entre categorías.
Un glucómetro que no pincha el dedo, sino que simplemente mira la muñeca: el sueño de millones de personas con diabetes. Eso es lo que prometen los algoritmos que extraen el nivel de glucosa de la señal habitual del pulso, la fotopletismografía (esa misma que mide el pulso en los relojes inteligentes).
Predecir el rendimiento de una reacción química es como intentar adivinar la cosecha conociendo solo la composición del suelo. Tradicionalmente, los químicos se apoyaban en largas columnas de números —los descriptores cuánticos— que describen la energía de los electrones, pero no dicen nada sobre la forma de la molécula.
Dos patinadores en un lago congelado hasta el horizonte. Están tan lejos que sus siluetas se han reducido a puntos, y su atracción mutua es casi un concepto teológico. Según los preceptos de Newton, deberían girar en un vals especulativamente lento. Pero los telescopios ven otra cosa.
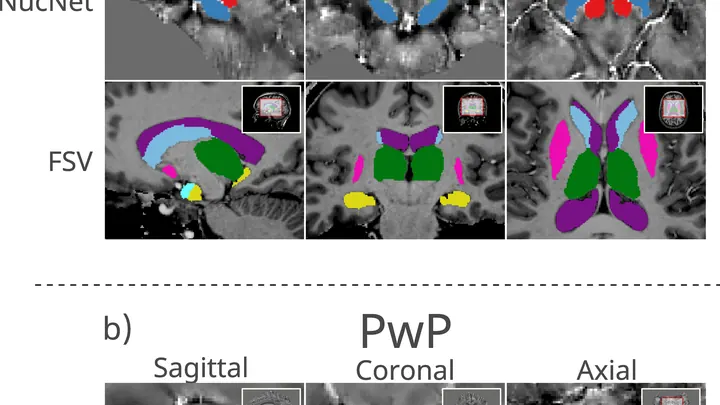
Un IA común ve las imágenes médicas como rompecabezas de fragmentos desconocidos: dos imágenes no emparejadas las considera completamente diferentes. Es como intentar distinguir a gemelos sin saber que son familia. En medicina, los pacientes con la misma enfermedad se ven casi iguales en la resonancia, y el algoritmo se equivoca al confundir a los «parientes».
La inteligencia artificial que predice la acústica de una sala se parece a un estudiante en un examen con una chuleta. Si los puntos de prueba son los mismos que los de entrenamiento, el modelo simplemente memoriza la 'huella sonora' de cada posición, como un estudiante que reconoce el examen por una esquina doblada.
Evaluar la calidad de una imagen es tarea de un inspector meticuloso con un juego de herramientas. La red neuronal IQA-T1 actúa exactamente así: no solo observa la imagen, sino que aplica ora un espectroscopio, ora un luxómetro.
La red eléctrica es como un gran restaurante donde miles de 'platos'—las averías — amenazan con servirse cada minuto. Revisar cada plato llevaría horas, y un vistazo rápido a veces deja pasar peligros, como el moho imperceptible en el queso. El método de von Neumann (quien ideó cómo atrapar a los tramposos revisando solo una parte de las cartas) ofrece un camino distinto.
Buscar en internet es como tamizar harina para hornear: entre las partículas blancas pueden aparecer manchas oscuras de tierra. Esta contaminación de datos es una impureza imperceptible que arruina el resultado final. C3R actúa como un tamiz inteligente: no solo filtra la basura informativa, sino que también es capaz de detenerse si hay demasiada suciedad.
La red eléctrica ferroviaria es como una orquesta: los trenes son músicos cuyos sistemas reaccionan de manera diferente a la corriente. Cuando sus «voces eléctricas» suenan desacompasadas, se produce un desorden, una cacofonía que puede convertirse en una peligrosa oscilación de la tensión.
Un niño construye un juego sencillo en Scratch: un personaje aparece en el centro y salta instantáneamente a una esquina. El primer movimiento se pierde entre fotogramas: nadie lo ve. Eliminar esa instrucción es seguro. Pero, ¿cómo lo sabe un optimizador automático? Hoy, el repositorio de Scratch alberga decenas de millones de proyectos escritos por jóvenes autores.
El intérprete está en la sala de reuniones y traduce cada palabra. Pero de repente se da cuenta de que puede mejorar su traducción si aprende de sus errores. Empieza a anotar qué frases causaron malentendidos y las corrige. Al cabo de una hora, su traducción es más precisa y la reunión avanza más rápido.
Un laboratorio envía a un robot una lista de mil moléculas candidatas para un nuevo fármaco. El robot predictor, entrenado con datos antiguos, da para cada una una evaluación de 'apta o no apta'. Pero cuando la lista proviene de un área desconocida —otro virus o un tumor raro—, el robot empieza a confundirse. Su confianza sigue siendo alta, pero los aciertos reales caen a cero.
El brazo levanta una taza del estante: un movimiento habitual que no notamos hasta que los músculos se cansan. Entonces la trayectoria cambia: el codo se desvía un poco hacia un lado, la muñeca tiembla. Normalmente, el médico detecta estos cambios con las manos, palpando los músculos del paciente.
En una persona, la enfermedad comienza con un temblor en la mano: la taza baila sobre el platillo mientras la lleva a la mesa. En otra, las piernas de repente se niegan a caminar con firmeza: el paso se vuelve corto y arrastrado, como si el suelo se hubiera cubierto de una capa pegajosa. No son dos enfermedades distintas, sino dos caras de la misma: la enfermedad de Parkinson.
La cámara toma una foto, pero el sensor introduce ruido, la óptica desenfoca y parte de los píxeles quedan sobreexpuestos. Recuperar la imagen original es como adivinar una melodía a partir de un disco rayado: hay muchas posibilidades y no está claro cuál es la verdadera.
Un cocinero prepara un pastel siguiendo la receta, pero en lugar de una masa esponjosa obtiene una corteza dura. Empieza a repasar las causas: quizá la harina se humedeció, o el horno calienta de manera desigual, o los huevos estaban demasiado fríos.
Dos especialistas observan la misma imagen de una mama. Uno es un médico experimentado; el otro, un programa de inteligencia artificial. A veces sus opiniones coinciden, a veces divergen. De la frecuencia con la que se ponen de acuerdo depende la precisión con la que, juntos, distinguen el tejido sano del tumor.
Un modelo de lenguaje de proteínas es como un chef que ha aprendido de miles de recetas y ahora inventa platos nuevos. A veces se entusiasma y le echa sal a todos los platos porque en un buen libro de cocina había mucha. En las proteínas, esa repetición no es solo fea: los segmentos idénticos de la cadena vuelven a la proteína frágil, no puede plegarse en la forma correcta y no funciona.
El diagnóstico genético se parece a comparar dos fotografías tomadas con cámaras distintas. Si una cámara altera un poco los colores, en la imagen aparecen «defectos» que no existen en la realidad.