Переобучение возникает, когда статистическая модель описывает случайную ошибку или шум вместо лежащей в основе взаимосвязи. Модель хорошо работает на обучающих данных, но плохо на новых, невиданных данных. Это центральная проблема в машинном обучении и статистике, так как цель состоит в создании моделей, которые обобщают, а не просто запоминают.
История
Концепция известна с ранних дней статистики и подгонки кривых. Термин «переобучение» стал prominent в 1960–1970-х годах с развитием нейронных сетей и деревьев решений.
Как это работает
Модели с высокой гибкостью (например, с большим числом параметров) могут подогнать обучающие данные почти идеально, включая их особенности. Когда модель слишком сложна относительно объема данных, она улавливает ложные закономерности, которые не существуют в истинной популяции. Это приводит к высокой дисперсии: небольшие изменения в обучающем наборе вызывают большие изменения в модели. Для обнаружения и предотвращения переобучения используются такие методы, как кросс-валидация, регуляризация и сокращение (pruning).
Где применяется
В прогностическом моделировании переобучение является постоянной проблемой. Практики используют валидационные наборы и регуляризацию, чтобы такие модели, как в кредитном скоринге или медицинском прогнозе, оставались надежными на новых пациентах.
Любопытный факт
Модель, которая идеально запоминает обучающие данные (например, таблица поиска), имеет нулевую ошибку на обучении, но обычно работает не лучше случайного угадывания на новых данных — классический пример переобучения.
Карта сокровищ, нарисованная нейросетью, обещает показать, где зарыто золото. Но если карту перенести на другой остров, отметки могут указывать в пустоту. Именно это произошло с объяснениями модели, которая оценивает пульс по видеозаписи лица.
Нейросеть RhythmFormer улавливает едва заметные изменения цвета кожи, вызванные сердцебиением.
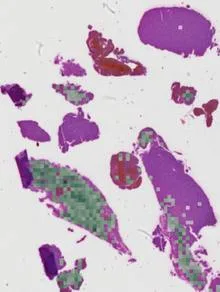
Представьте, что вы пытаетесь понять, что случилось в комнате, по звуку, который остался после выстрела. Выстрела уже нет, но эхо ещё гуляет по стенам. Примерно так нейропатолог смотрит на срез мозговой ткани, в котором самой опухоли не оказалось: биопсия взяла только здоровую ткань, которая успела отреагировать на болезнь.
Два бегуна стартуют на дистанции с меняющимся уклоном. Один выходит раньше, другой позже, и судья замеряет их скорости, не зная о разнице в старте. Так и с вариантами вируса: данные о них приходят с задержками, и если эти задержки неодинаковы, оценка конкурентного преимущества может оказаться грубо неверной.
В эволюционной биологии преимущество часто оценивают по наклону логит-кривой частоты вторгающегося типа.
Представьте склад с коробками яблок и груш. Яблок много, груш мало. Но когда кладовщик говорит «фрукт с гладкой кожурой», мы почему-то чаще вспоминаем редкую грушу, а не частое яблоко. Это проявление эффекта обратной базовой ставки — устойчивого когнитивного искажения, при котором мозг, разрешая неоднозначность между категориями, систематически переоценивает редкие варианты за счёт частых.
Сто тысяч звёзд в тесном ядре шарового скопления движутся как стальные шарики в гигантском пинбольном автомате. Каждый «толчок» — гравитационная встреча двойной системы с одиночной звездой — запускает каскад непредсказуемых событий. Пара может разлететься, чужак может выбить одного из партнёров и занять его место, а иногда все трое застревают в запутанном иерархическом танце.
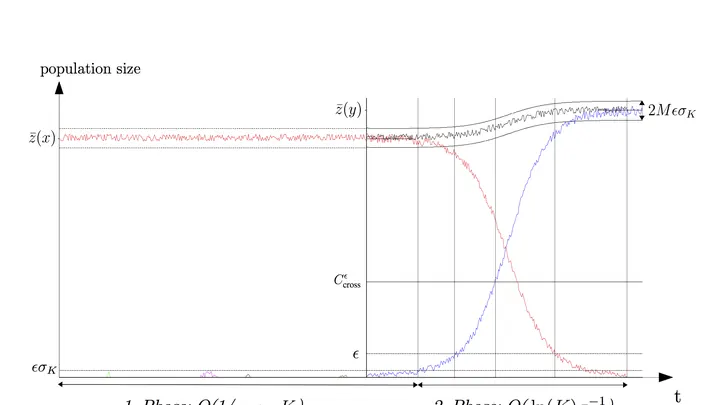
Эволюция течёт подобно воде. В широкой равнинной реке изменения плавны и почти незаметны, тогда как горный ручей бурлит, огибая каждый камень. Размер популяции и частота мутаций задают русло этого потока: широкое и спокойное или узкое, полное порогов.
Машинное обучение давно перестало быть просто инструментом — оно становится исследователем, самостоятельно выуживающим законы природы из данных. Но как кремниевый разум приходит к пониманию? Чтобы подсмотреть этот процесс, физики обратились к игрушечной, но глубокой модели — решётке Изинга, где спины танцуют под диктовку температуры.
Гравитационные сигналы от умирающих массивных звёзд — это шёпот, долетающий до нас из самых жестоких лабораторий Вселенной. Эйнштейн предсказал эти гравитационные волны более века назад, но лишь сегодня, с детекторами вроде LIGO, мы начинаем их слышать.
60 мышей, 1980 образцов, 234 пациента с раком лёгкого. За каждым числом — тысячи генов. Их активность измеряют, чтобы понять болезнь. Но данные не однородны: у одного больного оценивают уровень белка (непрерывное число), ставят диагноз (да/нет) и определяют подтип опухоли (категория). Смешать их в одной модели — как сложить градусы Цельсия и километры.
Статистические модели — это попытка натянуть идеальную математическую паутину на неровный ландшафт данных. Когда модель сопротивляется, она издаёт напряжение, но мы привыкли его игнорировать. Исследователи часами вглядываются в графики остатков, пытаясь угадать, где модель «трещит по швам». Сквилер переводит это сопротивление в звук.
Ученик, который годами решал задачи из чужих учебников, вдруг получает три тетради с настоящими наблюдениями за океаном. Задач мало, но он уже видел сотни похожих, и теперь ему хватает пары примеров, чтобы уловить почерк нового учителя.
На футбольном стадионе эмоции толпы складываются из разговоров отдельных болельщиков. Если бы настроение могло быть одновременно радостным и грустным, возникла бы квантовая суперпозиция. Но шёпот тысяч голосов мгновенно переводит эту смесь в одно определённое состояние.
Обучение точной аэродинамической модели сродни кулинарному искусству: сначала повар осваивает сотни рецептов, чтобы уловить общие принципы, а затем легко доводит до совершенства конкретное блюдо.
Ядро урана напоминает тугой кошелёк, защёлкнутый на две половинки. Чтобы он лопнул и высвободил энергию — то есть чтобы ядро разделилось, — нужно перевалить через энергетический барьер. Высота этого порога определяет, стабильно вещество или готово распасться в любой момент.
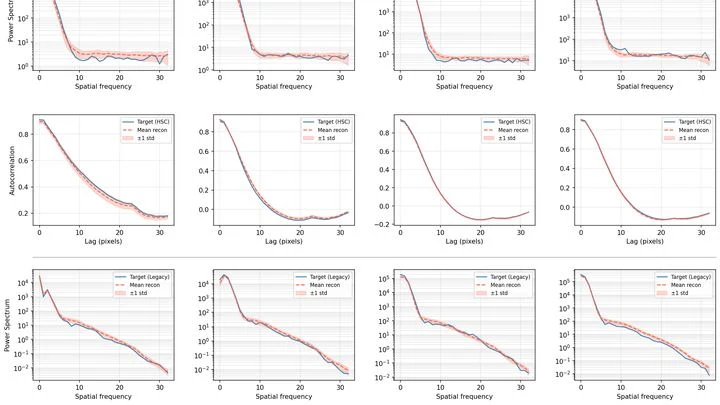
Если сфотографировать одну и ту же гору на плёночный фотоаппарат и на современный смартфон, получатся разные изображения: где-то цвета ярче, где-то детали размыты. Так и с телескопами: каждый инструмент видит небо по-своему, добавляя к настоящему свету галактик собственные искажения — как фильтр, через который мы смотрим.
Новая работа предлагает способ убрать этот «фильтр».
Квантовый компьютер похож на оркестр, где каждый музыкант играет свою партию. Если дирижёр даёт сбой, музыка рассыпается. В цифровых квантовых симуляциях роль дирижёра играет последовательность простых операций, а ошибки накапливаются, как фальшивые ноты. Но иногда оркестр звучит чисто, даже если дирижёр не идеален.
Авторы статьи нашли объяснение такому везению.
Турбулентный поток воды в трубе и колебания маятника кажутся непохожими. Но внутри у них есть общее: оба подчиняются своим законам движения, которые можно описать числами. Нейросеть, обученная только на одном таком «танце» чисел, вдруг начинает понимать другой — без единого дополнительного примера. Это как музыкант, который выучил одну мелодию, а потом с листа играет незнакомую пьесу, уловив её гармонию.
Нейросеть можно сравнить с общежитием, где каждому жильцу полагается своя комната. Обычно каждый признак в данных занимает отдельный нейрон, и обучение идёт по очереди: сначала один признак, потом другой. Это медленно и зависит от того, какие именно данные попались.
Но если разрешить нескольким признакам жить в одной комнате — наложить их друг на друга, — картина меняется.
Кукловод дёргает за нити, и марионетка пляшет. В предсказании будущего по временным рядам роль кукловодов играют немногие переменные, которые действительно управляют системой. Остальные показатели лишь повторяют их движения, создавая видимость сложности. Задача в том, чтобы найти этих кукловодов и следить только за их пальцами, а не за всей сценой.