تجميع K-means هو خوارزمية تعلم غير موجّه تقسم مجموعة بيانات إلى عدد محدد مسبقًا من العناقيد، كل عنقود يمثله مركزه (متوسط نقاطه). الهدف هو تقليل التباين داخل العنقود، مما يجعل النقاط في نفس العنقود متشابهة قدر الإمكان مع إبقاء العناقيد المختلفة متميزة. وهي واحدة من أبسط وأكثر طرق التجميع استخدامًا، وغالبًا ما تكون بمثابة خط أساس للطرق الأكثر تعقيدًا.
التاريخ
استُخدم مصطلح 'k-means' لأول مرة من قبل جيمس ماكوين في عام 1967، على الرغم من أن الفكرة الأساسية تعود إلى هوغو شتاينهاوس في عام 1956 وخوارزمية لويد (1957) لتعديل نبضات الترميز.
كيف يعمل
تبدأ الخوارزمية بتهيئة k مراكز بشكل عشوائي. ثم تكرر خطوتين: (1) تعيين كل نقطة بيانات إلى أقرب مركز، و(2) إعادة حساب كل مركز كمتوسط لجميع النقاط المعينة إليه. تتكرر هذه الخطوات حتى تتوقف المراكز عن التغير بشكل ملحوظ. تعتمد النتيجة على الموضع الأولي، لذا من الشائع تشغيل الخوارزمية عدة مرات ببذور مختلفة واختيار أفضل نتيجة. يجب اختيار عدد العناقيد k مسبقًا، غالبًا باستخدام طريقة الكوع أو تحليل الصورة الظلية.
في التطبيق
يُستخدم K-means لتقسيم العملاء في التسويق، وضغط الصور عن طريق تقليل لوحات الألوان، واكتشاف الشذوذ عن طريق تحديد النقاط البعيدة عن أي مركز.
حقيقة طريفة
K-means فعال جدًا لدرجة أنه يمكنه تجميع ملايين النقاط في ثوانٍ، لكنه يفترض أن العناقيد كروية ومتشابهة في الحجم، وهو أمر نادر في البيانات الحقيقية.
خزانا حبر يقفان على جانبي الحدود الخلوية. منهما يتدفق إلى الغشاء نوعان من المونومرات، التي عندما تلتقي تشكل قطرات لزجة من المعقدات. القطرات بالكاد تتحرك، بينما المونومرات الحرة تنتشر بسرعة، مثل جزيئات العطر في الغرفة. هكذا تبدأ قصة كيف ترسم الخلية على حدودها نقاطًا، وهي تجمعات بروتينية منفصلة، ستحدد لاحقًا اتجاه نمو النسيج بأكمله.
مترجم في قاعة يتحدث فيها الناس بثلاث لغات في وقت واحد، يسمع في البداية ضجيجًا عامًا فقط. لكن إذا بدأ بإعادة الأسئلة، والإنصات إلى النغمات، والتأكد مرارًا من الذي أجاب بأي عبارة، ستظهر تدريجيًا أصوات منفردة من وسط الفوضى.
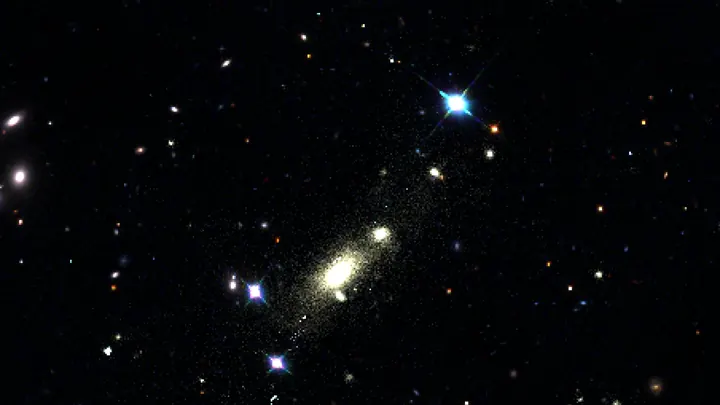
تبعد المجرة NGC 4254 عن مركز عنقود العذراء المجري مسافة مليون ونصف سنة ضوئية. تجر خلفها ذيلاً طويلاً من الهيدروجين المبرد — علامة على أنها تصطدم بسرعة عالية بـ الغاز الساخن. فقدان الوقود البارد يخمد ولادة نجوم جديدة.
تصل درجة الحرارة في مركز العنقود المجري إلى مئة مليون درجة. هذه الأنظمة، الأكبر في الكون المرتبطة بالجاذبية، هي مختبرات طبيعية تخبئ فيها الطبيعة 85% من كتلتها في المادة المظلمة غير المرئية.
عادةً ما يُقيَّم تعقيد الأنظمة - من حركة الأقمار الصناعية إلى إيقاعات القلب - باستخدام الإنتروبيا المتوسطة (مقياس عدم القدرة على التنبؤ، كما فهمها بولتزمان). لكن هذا يشبه تقييم المحيط بناءً على ارتفاع الأمواج فقط: فالرقم المتوسط يخفي كل ثراء التيارات تحت الماء.
تغوص طريقة CWMMSE أعمق.
الذكاء الاصطناعي التقليدي ينظر إلى الصور الطبية كما لو كانت أحجية من قطع غير مألوفة — فهو يعتبر أي صورتين غير متطابقتين مختلفتين تمامًا. هذا أشبه بمحاولة التمييز بين توأمين دون معرفة قرابتهما. أما في الطب، فالمرضى المصابون بنفس المرض يبدون متشابهين تقريبًا في صور الرنين المغناطيسي، فيخطئ الخوارزم ويخلط بين "الأقارب".
الدماغ يتحدث عبر طقطقات كهربائية قصيرة. في السابق، لتعلم هذه اللغة، كانت هناك حاجة إلى آلاف الأمثلة المترجمة من قبل المجرِّب. طريقة MOJO تسلك مسارًا مختلفًا: كما يحدث عند تعلم لغة عن طريق الانغماس، فهي أولاً 'تستمع' إلى 'تيار الوعي' دون أي تلميحات وتجد بنفسها الأنماط المتكررة.
الطفل، وهو يستكشف شقة غير مألوفة، يزحف من شيء إلى آخر ويتذكر ما يراه من كل زاوية. هكذا يبني الدماغ خريطة ذهنية — نموذجاً داخلياً للفضاء. خوارزمية gradCSCG تعمل بالمبدأ نفسه: تستقبل بثاً من الكاميرا وترسم مخطط المكان بنفسها، معتمدة فقط على تغير الصور. في السابق، كانت الآلات تحتاج إلى تلميحات — مثل كائنات محددة مسبقاً في الصور. أما الطريقة الجديدة فتستغني عنها.
لطالما كان تحديد الأطوار الكمومية أشبه باستجواب شاهد: كان لا بد من الوصول إلى كل زاوية من النظام لانتزاع سره. في عصر ليف لانداو، كان الربط بين الترتيب وكسر التناظر والمعامل المحلي واضحًا وضوح الشمس. لكن اكتشاف الأطوار الطوبولوجية قلب المعادلة: تخفي هذه الحالات ترتيبها في أعماق الترابطات غير المحلية، مثل وصفة لا يمكن قراءتها حتى تتذوق الطبق بأكمله.
العدسية التجاذبية الميكروية هي أثر كوني مذهل، تنبأ به أينشتاين وطوّره تسفيكي. جسم ضخم، يمر بيننا وبين نجم بعيد، يحني ضوءه كالعدسة، مُحدِثاً تضخيمات وتشوهات مميزة.
العديد من الحسابات المتقدمة في الفيزياء تصطدم بجدار حجري — لا يعيقها نقص الأفكار، بل الحسابات. يتعلق الأمر بتكاملات تعبّر عن احتمال تصادم الجسيمات أو شكل موجة الجاذبية. للحصول على رقم، يجب تبسيط هذه التكاملات — اختزالها إلى حفنة من «التكاملات الأساسية»، تشبه جدول الضرب. الإجراء معروف: خوارزمية لابورتا (Laporta) تستعرض التركيبات بشكل منهجي حتى لا تبقى سوى اللبنات الأساسية.
الشبكة الاجتماعية تشبه المدينة: فيها أحياء عملاقة وأزقة صغيرة. عندما يبحث خوارزمي عن مجموعات متماسكة فيها، غالبًا ما يميز زوجًا من المجموعات الضخمة والكثير من الشظايا الصغيرة. لكن العميل — مثل البلدية — يحتاج إلى أحياء متقاربة الحجم لتوزيع العيادات أو المدارس بالتساوي.
الحيلة المعتادة هي تدوير مقبض "السماح" الذي يجعل جميع المجتمعات في المتوسط أكبر أو أصغر.
ثلاثة أشخاص يجلسون في زوايا غرفة ثلاث. يتلقى كل واحد منهم ظرفًا مختومًا من ساعي غير مرئي — لكن السعاة لا يتواطؤون ولم يلتقوا أبدًا. يفتح الأشخاص الأظرف ويجدون ورقة بكلمة واحدة: «نعم» أو «لا». هم أنفسهم لا يختارون شيئًا — يقرؤون فقط. بعد آلاف الجولات، يتبين أن مجموعات الإجابات تخضع لإحصاءات لا يمكن الحصول عليها دون تواطؤ سري بين السعاة. إلا إذا افترضنا أن الأوراق تؤثر على بعضها البعض فورًا، عبر الغرفة بأكملها.
إذا عرضت نفس صورة قطة على شبكتين عصبيتين مختلفتين، فغالبًا ما تصلان إلى استنتاج مماثل: «قطة». ولكن إذا سألتهما بمزيد من التفاصيل، فقد تتباين الإجابات. نموذج واحد سيلاحظ الشاربين، وآخر سيلاحظ اللون، وثالث سيلاحظ الوضعية. يتبين أنه حتى داخل عالم الشبكات العصبية «البصري» لا يوجد اتحاد كامل.
ابتكر العلماء طريقة لقياس هذا الاتحاد لكل صورة على حدة. أخذوا عدة شبكات عصبية بصرية بمهام تعلم مختلفة وقارنوا تمثيلاتها الداخلية.
قفلان شبه متطابقين يفتحهما نفس المفتاح الرئيسي. يبدوان متشابهين من الخارج، لكن الآلية الداخلية مختلفة. هكذا يبدو النوعان الرئيسيان لسرطان الرئة غير صغير الخلايا: السرطان الغدي وسرطان الخلايا الحرشفية. تحت المجهر يمكن الخلط بينهما، لكن العلاج المطلوب مختلف. هنا تأتي "العدسة المكبرة" الكمية للإنقاذ.
في مسرّع الجسيمات، تتحطم النوى إلى شظايا، مثلما ينكسر فنجان خزفي عند سقوطه. تمر كل شظية عبر ألواح السيليكون، التي تسجّل الاصطدام وقوته. ولكن للتمييز بين الإشارة الحقيقية والضوضاء العشوائية، يجب ضبط عتبة: أي قراءة أقل منها تُعتبر تداخلًا.
تستخدم تجربة FOOT ستة ألواح سيليكون بسماكة 150 ميكرومترًا، مكدسة في ثلاث طبقات.
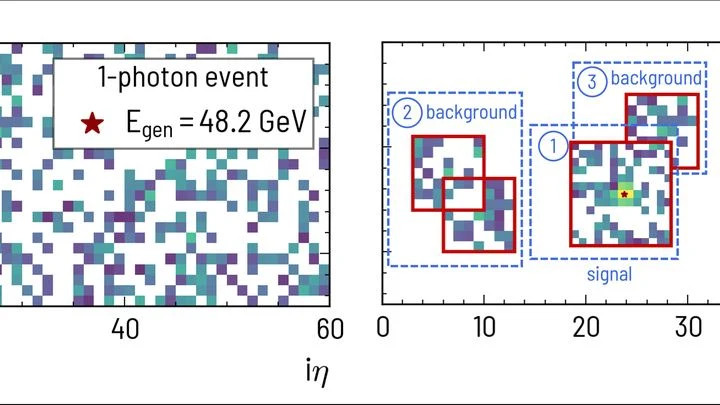
في كاشف مصادم الهادرونات الكبير، تولد ملايين الجسيمات كل ثانية. ومضات الطاقة التي تنتجها في المسعّر (calorimeter) تشبه قطرات المطر على زجاج النافذة: القطرات المنفردة مرئية، لكن عندما تكثر وتندمج، يصعب تمييز كل واحدة منها. والفيزيائيون بحاجة إلى معرفة مقدار الطاقة التي حملها كل جسيم وإلى أين وصل بدقة.
النهج الجديد يوكل هذه المهمة إلى شبكة عصبية.
صور المجرات البعيدة المجرات تزخر بأقواس وبقع منحنية — إنه ضوء تشوه في طريقه إلينا. هذا التأثير، الذي تنبأ به ألبرت أينشتاين في إطار النسبية العامة، يعمل كمرآة مشوهة عملاقة: فالتجمع المجري الضخم تجمع المجرات بجاذبيته يشوه صور المصادر الخلفية — وهي ظاهرة تُعرف باسم العدسة…
نقاط مضيئة على خلفية داكنة — هكذا تبدو صور الجزيئات المفردة الملتقطة بتقنية MINFLUX. هذا المجهر قادر على إظهار تفاصيل أصغر من خمسة نانومترات: أي أنحف بحوالي عشرة آلاف مرة من شعرة الإنسان. لكن الصورة لا تظهر مكتملة، بل تشبه حفنة من الأضواء في زينة عيد الميلاد حيث احترق بعض المصابيح وتشابكت الأسلاك.
الحاسوب الكمومي ينسج من الكيوبتات ما يشبه الخيط، حيث كل عقدة هي جسيم، والرابط بينها هو تشابك. عندما يقيس الفيزيائي كيوبتًا، يتغير الخيط: يتمزق في مكان، ويُخاط في آخر، وأحيانًا تظهر عليه لفة. وجد مؤلفو العمل الجديد قواعد دقيقة لهذه التحولات لأبسط سلسلة — الخطية، حيث تُرتب الكيوبتات في صف.
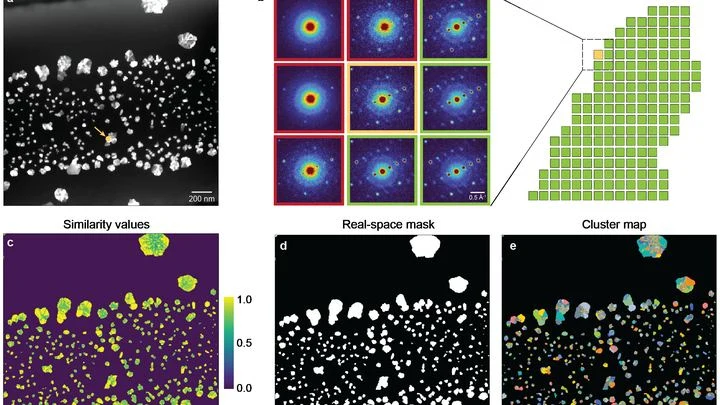
يمسح المجهر الإلكتروني العينة ويسجل في كل نقطة كيفية تشتت الإلكترونات على الذرات. النتيجة كومة ضخمة من الصور — صورة لكل نقطة. فيها معلومات مشفرة عن ترتيب الذرات: في صفوف منتظمة أو بخلل، وإلى أين تتجه الشبكة البلورية، وهل توجد إجهادات داخلية.
المشكلة أن هذه الصور بالملايين، ولا يمكن فرزها يدويًا. يقترح مؤلفو العمل إيجاد تلقائيًا للمناطق التي يكون فيها نمط التشتت متطابقًا تقريبًا.
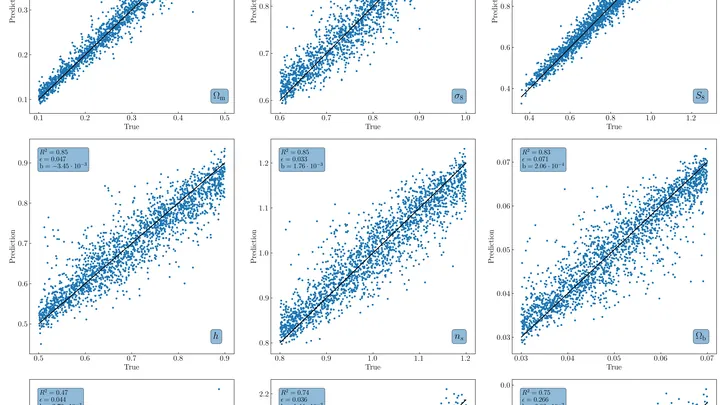
وُلدت آلاف الأكوان داخل الحاسوب لكي تحكي يومًا ما عن كوننا. كلٌّ منها يحمل عناقيد مجراته الخاصة، موزعة وفق قوانين الجاذبية، مثل حبات البازلاء في وعاء هزّته قوة مختلفة. من طريقة استقرار الحبات يمكننا أن نفهم أي يد هزّت الوعاء. وهكذا هنا: من نمط توزيع العناقيد، يريد العلماء تحديد كمية المادة المظلمة في الكون ومدى سرعة تجمعها في كتل.
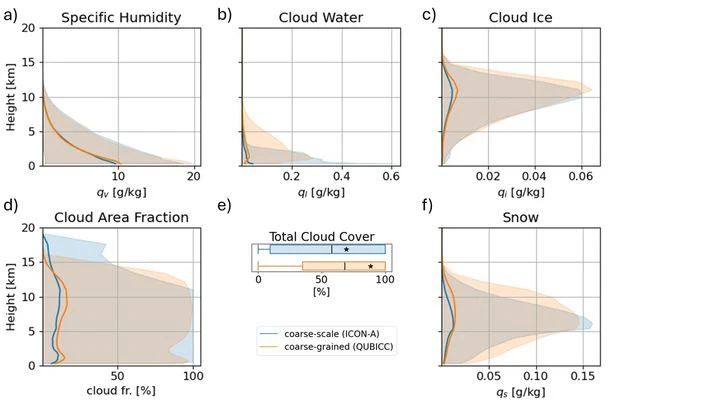
يشبه التنبؤ بالمناخ وصفة طهي معقدة: رشة خاطئة واحدة تفسد الطبق بأكمله. وكذلك الحال مع السحب، فهي مكونات صغيرة لكنها حاسمة. تقسم النماذج المناخية التقليدية الغلاف الجوي إلى خلايا بحجم 50-100 كم ولا تميز السحب الفردية. هذا يشبه رش الفلفل بحفنات عندما تتطلب الوصفة رشة دقيقة. التبسيط يبعد عن الواقع: في النماذج، يؤدي فقدان المعلومات حول السحب إلى تراكم الأخطاء في حساب انعكاس ونفاذية الإشعاع الشمسي.