En la inferencia estadística, a menudo te interesa un parámetro (por ejemplo, la masa de una partícula), pero también debes tener en cuenta otros parámetros 'molestos' (como la calibración del detector) que no te importan pero que afectan tus datos. La verosimilitud de perfil es una forma de centrarse en el parámetro de interés: para cada valor posible de ese parámetro, encuentras los valores de ajuste óptimo de todos los parámetros molestos maximizando la verosimilitud, y luego registras solo el valor máximo de la verosimilitud. Esto produce un 'perfil' de la verosimilitud en función del parámetro de interés, que puedes usar para construir intervalos de confianza o probar hipótesis.
Historia
El concepto fue introducido por estadísticos a mediados del siglo XX, notablemente por Jerzy Neyman y luego formalizado por otros; el término 'verosimilitud de perfil' se estandarizó en la década de 1970.
Cómo funciona
Imagina una función de verosimilitud que depende tanto del parámetro de interés θ como de los parámetros molestos ν. Para un θ fijo, maximizas sobre ν, obteniendo L_perfil(θ) = max_ν L(θ, ν). Repitiendo esto para muchos valores de θ se obtiene una curva unidimensional. El cociente de este perfil con su máximo sigue una distribución chi-cuadrado aproximada (teorema de Wilks) bajo ciertas condiciones de regularidad, lo que permite derivar intervalos de confianza. Esto es computacionalmente eficiente porque no tienes que integrar sobre los parámetros molestos, solo optimizar.
En la práctica
Se usa ampliamente en física de partículas (por ejemplo, en mediciones de la masa del bosón de Higgs y de la intensidad de la señal) y en cosmología para la estimación de parámetros a partir de datos del fondo cósmico de microondas.
Dato curioso
La verosimilitud de perfil puede dar intervalos engañosamente estrechos cuando los parámetros molestos están mal restringidos, un fenómeno conocido como el 'problema de la verosimilitud de perfil'.
Un ingeniero de proteínas se parece a un cocinero que intenta hacer un plato que sea a la vez sabroso, saludable y barato. Al cambiar un ingrediente, corre el riesgo de estropear otro. Antes, los asistentes informáticos solo podían evaluar las propiedades de las proteínas por separado, sin ver cómo se relacionan entre sí.
La gravedad no es solo la fuerza que nos mantiene en el suelo. A escala del universo, dirige a las galaxias, curva los rayos de luz y determina el destino de todo lo que existe. Hace cien años, Einstein la describió como la curvatura del espacio y el tiempo.
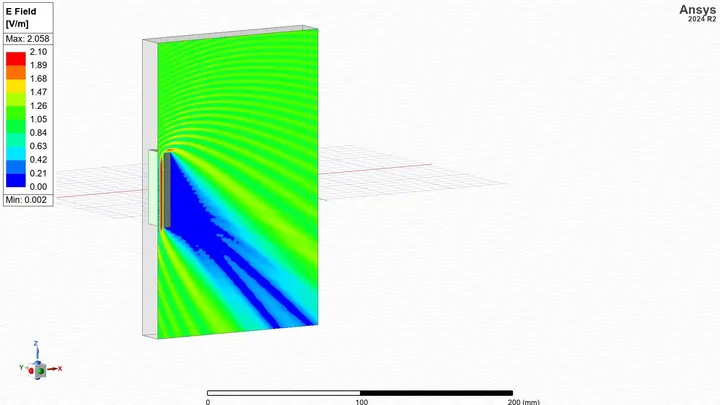
Cuando una onda de radio encuentra un edificio en su camino, no solo se refleja o se absorbe: lo rodea, igual que las olas del mar bordean una roca dejando agua tranquila detrás. En radiofísica, este fenómeno crea una sombra de radio: un patrón complejo de zonas de refuerzo y atenuación de la señal que los científicos llaman retrato de radio.
Imagina a un chef experimentado en hora punta: de repente falla una placa o se acaba un ingrediente clave. En lugar de entrar en pánico, reconfigura la receta al instante: acelera la preparación de unos platos, ralentiza otros, reasignando recursos sobre la marcha. Este principio de adaptación dinámica es la base de la nueva generación de redes ultra fiables.
Los neurochips funcionan de manera distinta a los ordenadores convencionales, construidos según los planos de von Neumann con memoria y procesador separados.
La luz fluye como un río invisible. Si colocas un obstáculo en el camino del flujo, el agua se arremolina en remolinos. Así, las superficies especiales crean 'torbellinos' de luz que atrapan nanopartículas como astillas.
El oro no está en la superficie: se esconde en toneladas de roca estéril. Para extraer un gramo del metal precioso, los buscadores tamizan metros cúbicos de tierra.
Los modelos estadísticos son un intento de tender una telaraña matemática perfecta sobre el paisaje irregular de los datos. Cuando el modelo se resiste, emite tensión, pero nos hemos acostumbrado a ignorarla. Los investigadores pasan horas escudriñando gráficos de residuos, tratando de adivinar dónde el modelo «cruje por las costuras». Squealer traduce esa resistencia en sonido.
Una red social se parece a una ciudad: hay barrios gigantes y callejones diminutos. Cuando un algoritmo busca grupos cohesionados, a menudo identifica un par de grupos enormes y muchos fragmentos pequeños. Pero el cliente —por ejemplo, un municipio— necesita barrios de tamaño similar para distribuir uniformemente centros de salud o escuelas.
Un patinador gira sobre el hielo acercándose poco a poco al centro. Su trayectoria no es una espiral perfecta: a veces entra en el ritmo de la música y da una vuelta extra, cambiando ligeramente la velocidad. Algo parecido hace un agujero negro pequeño cuando cae hacia uno supermasivo.
Una orquesta donde cada músico toca su parte pero solo oye al vecino. En cuanto uno se equivoca, una ola de errores recorre toda la sala. Así funcionan las máquinas de Ising: dispositivos especiales para resolver problemas donde hay que elegir la mejor opción entre muchas.
Una pinza láser es un haz de luz que atrapa y mueve objetos diminutos, como bacterias o motas de polvo. Si hay que llevar una partícula del punto A al punto B, se podría tirar de ella directamente. Pero eso gastaría más energía que una ruta ingeniosa con rodeos.
Una partícula activa es un objeto microscópico que se impulsa a sí mismo, como un nadador diminuto.
Para distinguir una proteína de otra, es necesario describir su forma y composición. Existen decenas de estas descripciones: longitud de la molécula, carga, solubilidad. Pero no todas son igualmente útiles. Un método llamado Differentiable Information Imbalance (DII) sabe seleccionar las características más informativas, descartando las superfluas.
Un laboratorio de ensayos mecánicos se parece a una cocina donde el chef prueba un plato para adivinar la receta. Para un material anisótropo, uno que es más rígido a lo largo de las fibras que a través de ellas, una sola prueba no basta. Se necesitan tres, o incluso más, ensayos separados, cada uno con su propia probeta.