La regularización es una técnica utilizada para ajustar modelos a datos cuando el problema está mal planteado o es indeterminado, es decir, cuando hay demasiados parámetros en relación con los datos, o los datos son ruidosos. Sin regularización, el ajuste puede producir soluciones con oscilaciones extremas que coinciden perfectamente con los datos pero carecen de poder predictivo (sobreajuste). La regularización añade un término de penalización a la función objetivo (por ejemplo, la suma de errores al cuadrado) que desalienta valores extremos de los parámetros, intercambiando efectivamente un pequeño aumento en el sesgo por una gran reducción en la varianza.
Historia
El concepto se remonta a la década de 1940 con los trabajos de Tijonov sobre problemas mal planteados, y fue popularizado en estadística por Hoerl y Kennard (1970) como regresión ridge.
Cómo funciona
En lugar de minimizar la pérdida habitual L(θ) (por ejemplo, chi-cuadrado), se minimiza L(θ) + λ R(θ), donde R es una penalización (por ejemplo, la suma de los cuadrados de los parámetros para la regresión ridge, o la suma de los valores absolutos para lasso) y λ es un parámetro de ajuste que controla la intensidad de la penalización. Un λ mayor obliga a los parámetros a acercarse a cero o entre sí, suavizando la solución. La elección de λ suele realizarse mediante validación cruzada para equilibrar el ajuste y la simplicidad.
En la práctica
Esencial en el aprendizaje automático (por ejemplo, para prevenir el sobreajuste en redes neuronales), en la reconstrucción de imágenes (como en las tomografías computarizadas) y en geofísica para invertir datos sísmicos.
Dato curioso
La regularización es matemáticamente equivalente a asumir una distribución a priori sobre los parámetros en la inferencia bayesiana: la regresión ridge corresponde a una prior gaussiana, y lasso a una prior de Laplace.
Una piedra cae en aguas tranquilas y se extienden círculos por la superficie. Algo parecido le ocurre a un agujero negro cuando algo cae en él o cuando se fusiona con otro. El agujero comienza a oscilar y esas oscilaciones se escapan al espacio en forma de ondas gravitacionales. Los astrofísicos llaman a este proceso el «tañido» del agujero negro.
El algoritmo de mejora de fotografías se parece a un navegador que, paso a paso, guía una imagen borrosa hacia una vista nítida. El ruido y las distorsiones las elimina moviéndose de píxel en píxel siguiendo un mapa habitual. Pero si la foto se tomó en condiciones desconocidas —por ejemplo, con un desenfoque inusual—, el mapa no coincide con el terreno.
El enfoque estándar para una clase de problemas de aprendizaje automático se asemeja a un resorte que se estira y se olvida soltar: los métodos estándar inflan artificialmente el tamaño del problema, convirtiendo los cálculos en un agujero negro de memoria y tiempo.
Las antenas convencionales, para determinar la dirección con precisión, deben trabajar de forma coordinada: captan no solo la intensidad, sino también la fase de la onda en cada instante. El más mínimo error de calibración y la dirección se pierde. El nuevo método se basa únicamente en la intensidad de la señal.
Las estrellas de neutrones son los últimos grumos de materia visible antes de caer en un agujero negro. En sus entrañas, la materia se comprime hasta densidades de billones de veces. Aquí, las fuerzas nucleares y la gravedad se entrelazan en una sustancia exótica, inaccesible para cualquier acelerador terrestre.
Un copo de nieve crece, una mancha de petróleo se extiende, una multitud se mueve: las ecuaciones para cada caso son distintas. Pero el final suele ser el mismo: la forma, la velocidad, el patrón obedecen a un esquema simple que se repite a diferentes escalas. Esto es la universalidad: cuando tras los detalles se esconde una ley común.
En la pantalla, el resultado de un modelado complejísimo: dos planetas colisionan, se expande una onda de choque. Un par de clics en el editor y las sombras duras se suavizan, el ruido se atenúa, el fondo se oscurece. Este retoque digital (edición de imagen para mejorar la apariencia) forma parte desde hace tiempo del arsenal de los científicos.
El oro no está en la superficie: se esconde en toneladas de roca estéril. Para extraer un gramo del metal precioso, los buscadores tamizan metros cúbicos de tierra.
Los modelos estadísticos son un intento de tender una telaraña matemática perfecta sobre el paisaje irregular de los datos. Cuando el modelo se resiste, emite tensión, pero nos hemos acostumbrado a ignorarla. Los investigadores pasan horas escudriñando gráficos de residuos, tratando de adivinar dónde el modelo «cruje por las costuras». Squealer traduce esa resistencia en sonido.
El robot de laboratorio cuenta moléculas y se equivoca. En un tubo hay 0, en otro 12, en un tercero 3, aunque en realidad en todos hay aproximadamente lo mismo. Estas cifras "crudas" son algo habitual en biología: secuenciación de ADN, recuento de especies en una muestra de agua, actividad génica. Hay muchos datos, pero son dispersos y varían más de lo que permitiría el azar simple.
Un agujero negro no es solo una mancha oscura en el cielo. Es un objeto complejo cuyas propiedades dependen de la geometría del espacio-tiempo que lo rodea.
Una red social se parece a una ciudad: hay barrios gigantes y callejones diminutos. Cuando un algoritmo busca grupos cohesionados, a menudo identifica un par de grupos enormes y muchos fragmentos pequeños. Pero el cliente —por ejemplo, un municipio— necesita barrios de tamaño similar para distribuir uniformemente centros de salud o escuelas.
La cámara toma una foto, pero el sensor introduce ruido, la óptica desenfoca y parte de los píxeles quedan sobreexpuestos. Recuperar la imagen original es como adivinar una melodía a partir de un disco rayado: hay muchas posibilidades y no está claro cuál es la verdadera.
Un programador escribe código, lo ejecuta, ve el error y lo corrige. Ahora, ese proceso se puede delegar en el propio programa. El aprendizaje profundo en imagenología médica ya sabe mejorar algoritmos, pero normalmente requiere muchos datos y ejemplos preparados.
Una red neuronal se puede comparar con una residencia estudiantil donde cada residente tiene su propia habitación. Normalmente, cada característica de los datos ocupa una neurona separada, y el aprendizaje se realiza de forma secuencial: primero una característica, luego otra. Esto es lento y depende de los datos específicos que se encuentren.
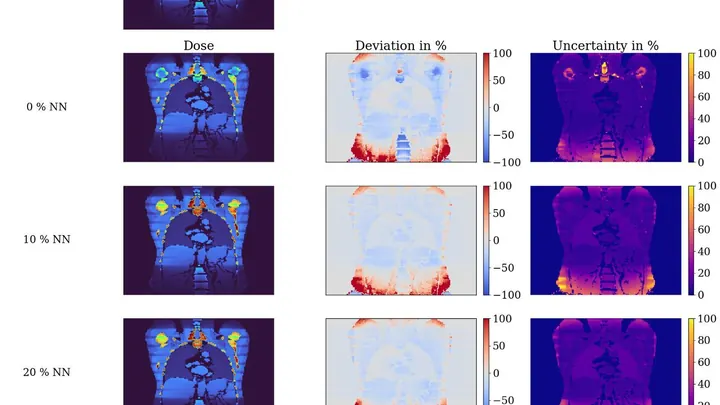
La tomografía computarizada es como una radiografía que toma cientos de imágenes desde distintos ángulos y con ellas construye una imagen tridimensional del cuerpo. Pero cada imagen implica una pequeña dosis de radiación, y los médicos necesitan saber cuánta recibe cada órgano.
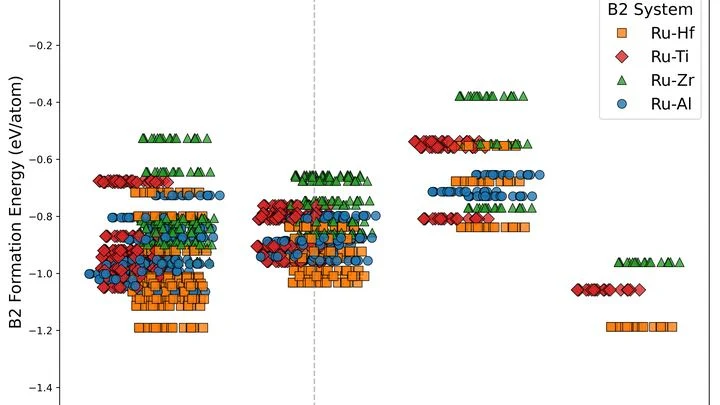
Ladrillos de diferentes tamaños colocados en una misma pared dejan grietas en ella. Algo similar ocurre con los átomos en las aleaciones resistentes al calor: cuando dos metales distintos forman una red cristalina común y sus átomos difieren ligeramente en tamaño, aparece una tensión dentro del material. Esta se acumula y finalmente destruye la aleación al calentarse.
Un intérprete en una sala ruidosa intenta captar el discurso en medio del murmullo de voces. El método habitual es memorizar un conjunto de frases y usarlas según una plantilla. Pero si el ruido aumenta, la plantilla se rompe.
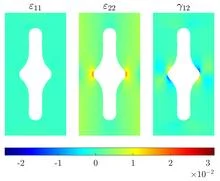
Un laboratorio de ensayos mecánicos se parece a una cocina donde el chef prueba un plato para adivinar la receta. Para un material anisótropo, uno que es más rígido a lo largo de las fibras que a través de ellas, una sola prueba no basta. Se necesitan tres, o incluso más, ensayos separados, cada uno con su propia probeta.