Le clustering par k-moyennes est un algorithme d'apprentissage non supervisé qui partitionne un ensemble de données en un nombre prédéfini de groupes, chacun étant représenté par son centroïde (la moyenne de ses points). L'objectif est de minimiser la variance intra-groupe, rendant les points d'un même groupe aussi similaires que possible tout en maintenant les différents groupes distincts. C'est l'une des méthodes de regroupement les plus simples et les plus utilisées, servant souvent de référence pour des approches plus complexes.
Histoire
Le terme « k-moyennes » a été utilisé pour la première fois par James MacQueen en 1967, bien que l'idée centrale remonte à Hugo Steinhaus en 1956 et à l'algorithme de Lloyd (1957) pour la modulation par impulsions codées.
Comment ça marche
L'algorithme commence par initialiser aléatoirement k centroïdes. Il itère ensuite deux étapes : (1) assigner chaque point de données au centroïde le plus proche, et (2) recalculer chaque centroïde comme la moyenne de tous les points qui lui sont assignés. Ces étapes se répètent jusqu'à ce que les centroïdes cessent de changer de manière significative. Le résultat dépend du placement initial, il est donc courant d'exécuter l'algorithme plusieurs fois avec des graines différentes et de choisir le meilleur résultat. Le nombre de groupes k doit être choisi à l'avance, souvent en utilisant la méthode du coude ou l'analyse de silhouette.
En pratique
Le k-moyennes est utilisé pour la segmentation de la clientèle en marketing, la compression d'images en réduisant les palettes de couleurs, et la détection d'anomalies en identifiant les points éloignés de tout centroïde.
Anecdote
Le k-moyennes est si efficace qu'il peut regrouper des millions de points en quelques secondes, mais il suppose que les groupes sont sphériques et de taille similaire, ce qui est rarement vrai dans les données réelles.
Deux réservoirs d'encre se tiennent de part et d'autre de la jonction cellulaire. De là, deux types de monomères s'écoulent sur la membrane et, lorsqu'ils se rencontrent, forment des gouttes visqueuses de complexes. Les gouttes bougent à peine, tandis que les monomères libres filent rapidement, comme des molécules de parfum dans une pièce.
Un interprète dans une salle où l'on parle simultanément trois langues n'entend d'abord qu'un brouhaha général. Mais s'il se met à faire répéter, à tendre l'oreille vers les intonations et à préciser sans cesse qui a répondu par quelle phrase, peu à peu des voix distinctes émergent de la cacophonie.
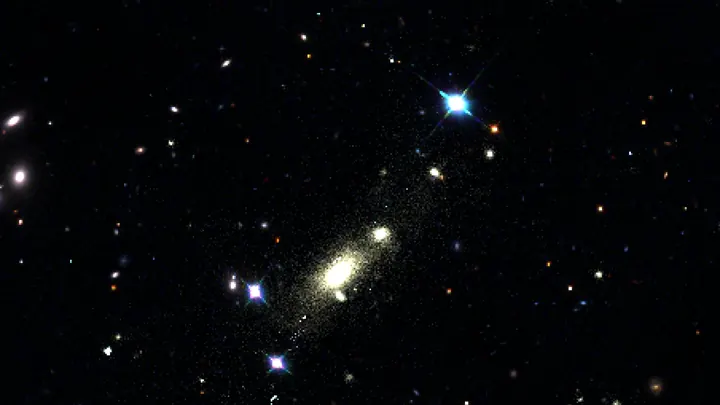
La galaxie NGC 4254 se trouve à un million et demi d'années-lumière du centre de l'amas de la Vierge. Elle traîne derrière elle un long filament d'hydrogène en refroidissement – signe qu'elle s'engouffre à pleine vitesse dans le gaz surchauffé.
La température au centre d'un amas de galaxies atteint cent millions de degrés. Ces systèmes, les plus grands liés gravitationnellement, sont des laboratoires naturels où la nature cache 85% de sa masse dans la matière noire invisible.
D'habitude, la complexité des systèmes — du mouvement des satellites aux rythmes cardiaques — est évaluée par l'entropie moyenne (une mesure de l'imprévisibilité, telle que la concevait Ludwig Boltzmann).
Une IA classique regarde les images médicales comme des puzzles faits de pièces inconnues : elle considère que deux images non appariées sont complètement différentes. C'est comme essayer de distinguer des jumeaux sans connaître leur lien de parenté. Or, en médecine, les patients atteints d'une même maladie présentent des IRM presque identiques, et l'algorithme se trompe en confondant les « parents ».
Le cerveau communique par de brefs clics électriques. Autrefois, pour apprendre cette langue, il fallait des milliers d'exemples traduits par l'expérimentateur. La méthode MOJO suit une autre voie : comme dans l'apprentissage par immersion, elle écoute d'abord le « flux de conscience » sans aucune indication et repère elle-même les motifs récurrents.
Un enfant qui explore un appartement inconnu rampe d'un objet à l'autre et mémorise ce qu'il voit depuis chaque coin. C'est ainsi que le cerveau construit une carte mentale — un modèle interne de l'espace. L'algorithme gradCSCG fonctionne sur le même principe : il reçoit un flux vidéo d'une caméra et dessine lui-même le plan du lieu, en s'appuyant uniquement sur le changement des images.
Pendant longtemps, identifier les phases quantiques ressemblait à un interrogatoire : il fallait explorer chaque recoin du système pour en soutirer le secret. À l'époque de Lev Landau, l'ordre était lié à la brisure de symétrie et à un paramètre local — tout était clair comme de l'eau de roche.
Le microlentillage gravitationnel est un effet cosmique fascinant, prédit par Einstein et développé par Zwicky. Un corps massif, passant entre nous et une étoile lointaine, courbe sa lumière comme une lentille, créant des amplifications et distorsions caractéristiques.
De nombreux calculs de pointe en physique se heurtent à un mur : ce qui les freine n'est pas un manque d'idées, mais l'arithmétique. Il s'agit d'intégrales qui expriment la probabilité de collision de particules ou la forme d'une onde gravitationnelle.
Un réseau social ressemble à une ville : il y a des quartiers géants et des ruelles minuscules. Quand un algorithme y cherche des groupes soudés, il sort souvent deux ou trois énormes ensembles et beaucoup de petits fragments. Mais le client — par exemple, une municipalité — a besoin de quartiers à peu près de la même taille pour répartir équitablement les cliniques ou les écoles.
Trois personnes sont assises aux trois coins d'une pièce. Chacune reçoit une enveloppe scellée d'un coursier invisible — mais les coursiers ne se concertent pas et ne se sont jamais rencontrés. Les gens ouvrent les enveloppes et voient un mot : « oui » ou « non ». Ils ne choisissent rien eux-mêmes — ils lisent simplement.
Si l'on montre la même photo de chat à deux réseaux de neurones différents, ils arrivent souvent à une conclusion similaire : « chat ». Mais si on leur demande plus de détails, les réponses peuvent diverger. Un modèle remarquera les moustaches, un autre la robe, un troisième la posture.
Deux serrures presque identiques s'ouvrent avec le même passe-partout. Extérieurement, elles se ressemblent, mais le mécanisme intérieur est différent. C'est à peu près le cas des deux principaux types de cancer du poumon non à petites cellules : l'adénocarcinome et le carcinome épidermoïde. Au microscope, on peut les confondre, mais le traitement requis est différent.
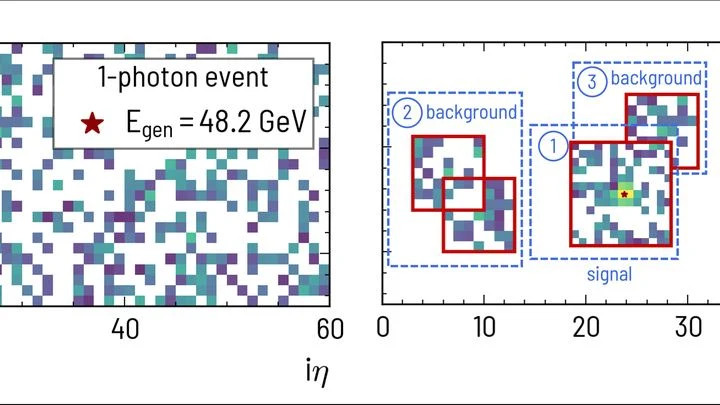
Dans un accélérateur de particules, les noyaux se brisent en fragments, comme une tasse en porcelaine qui tombe. Chaque fragment traverse des plaques de silicium qui enregistrent l'impact et sa force. Mais pour distinguer un vrai signal du bruit aléatoire, il faut fixer un seuil : en dessous de ce seuil, les lectures sont considérées comme du bruit.
Dans le détecteur du Grand collisionneur de hadrons, des millions de particules naissent chaque seconde. Leurs éclairs d'énergie dans le calorimètre ressemblent à des gouttes de pluie sur une vitre : on voit les gouttes individuelles, mais quand elles sont nombreuses et se fondent, il devient difficile de distinguer chacune.
Les images de galaxies lointaines sont parsemées d'arcs et de taches incurvés : c'est la lumière qui a été déformée en chemin vers nous. Cet effet, prédit par Albert Einstein, agit comme un miroir déformant géant : un amas de galaxies massif déforme les images des sources en arrière-plan.
Des points lumineux sur fond sombre : voilà à quoi ressemblent les images de molécules uniques obtenues par MINFLUX. Ce microscope peut révéler des détails de moins de cinq nanomètres, soit environ dix mille fois plus fins qu'un cheveu humain.
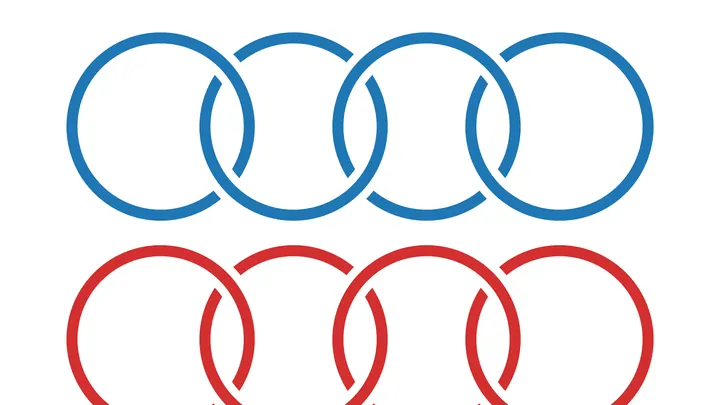
Un ordinateur quantique tisse avec les qubits une sorte de fil, où chaque nœud est une particule et le lien entre eux est un entrelacement. Lorsqu'un physicien mesure un qubit, le fil se modifie : par endroits il se rompt, par endroits il se recoud, et parfois il apparaît une torsion.
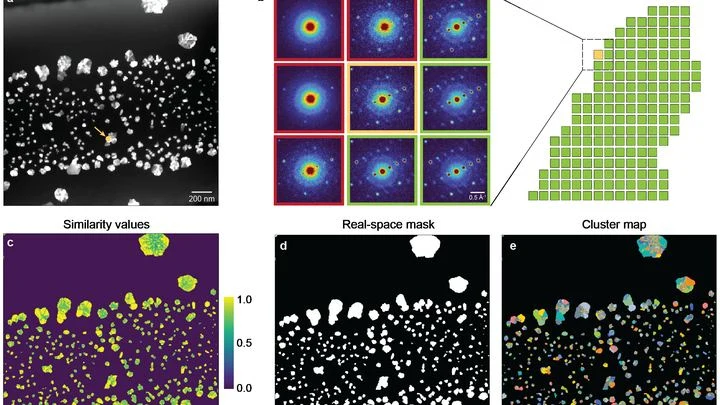
Le microscope électronique balaie l'échantillon et enregistre en chaque point la façon dont les électrons sont diffusés par les atomes. On obtient une pile gigantesque d'images – une par point.
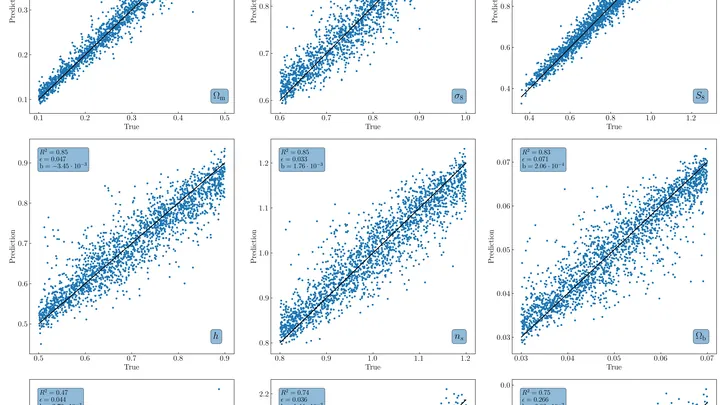
Des milliers d'univers sont nés dans un ordinateur pour, un jour, parler du nôtre. Chacun avec ses amas de galaxies, disposés selon les lois de la gravitation, comme des petits pois dans un bocal secoué avec plus ou moins de force. La façon dont les petits pois se répartissent permet de deviner quelle main a secoué le bocal.
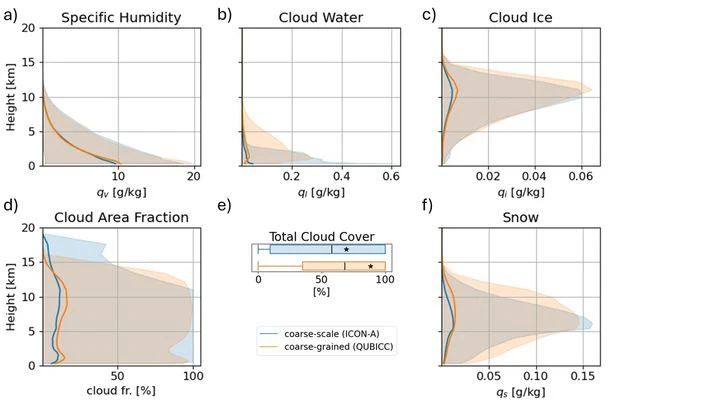
Prédire le climat, c'est un peu comme suivre une recette compliquée : une pincée de trop, et tout est gâché. C'est le cas avec les nuages — petits, mais décisifs. Les modèles climatiques découpent le ciel en cellules de 50 à 100 km et ne voient pas les nuages individuellement.