Un test de permutation est une méthode non paramétrique pour tester une hypothèse statistique sans faire d'hypothèses sur la distribution sous-jacente des données. Au lieu de s'appuyer sur des distributions théoriques (comme la distribution normale), il construit la distribution nulle directement à partir des données observées en mélangeant aléatoirement les étiquettes ou les affectations de groupe. Cela est particulièrement utile lorsque la taille de l'échantillon est petite ou que les données ne suivent pas des distributions standard.
Histoire
La méthode a été introduite par R. A. Fisher dans les années 1930, bien qu'elle ne soit devenue pratiquement réalisable qu'avec l'avènement des ordinateurs modernes.
Comment ça marche
La procédure est simple. Tout d'abord, on calcule une statistique de test (par exemple, la différence des moyennes entre deux groupes) sur les données originales. Ensuite, on mélange à plusieurs reprises les étiquettes des points de données de manière aléatoire, en recalculant à chaque fois la statistique de test. Ces valeurs mélangées forment la distribution nulle — la distribution de la statistique s'il n'y avait pas d'effet réel. La valeur p est la proportion de statistiques mélangées qui sont aussi extrêmes ou plus extrêmes que la statistique observée. Si cette proportion est très faible, le résultat observé est peu susceptible de s'être produit par hasard.
En pratique
Il est utilisé en génomique pour tester l'expression différentielle des gènes, en neurosciences pour les données d'imagerie cérébrale, et dans tout domaine où les petits échantillons ou les données non normales rendent les tests traditionnels peu fiables.
Anecdote
Les tests de permutation sont exacts : ils ne reposent pas sur des approximations asymptotiques, ce qui signifie que la valeur p est correcte même pour de très petits échantillons.
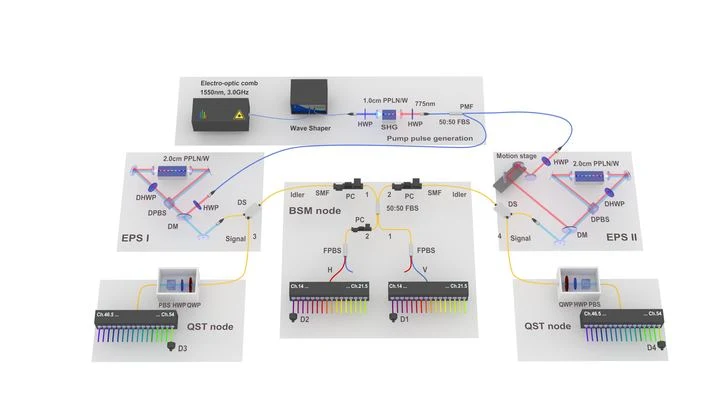
La communication quantique ressemble à l'envoi d'une lettre secrète qui se déchire à la moindre tentative d'espionnage. Jusqu'à présent, on ne pouvait envoyer cette lettre que par une seule route, ce qui est lent.
Un lecteur de glycémie qui ne pique pas le doigt, mais se contente de regarder le poignet — c'est le rêve de millions de personnes diabétiques. C'est précisément ce que promettent les algorithmes qui extraient le niveau de glucose du signal de pouls ordinaire — le photopléthysmogramme (celui-là même qui mesure le pouls dans les montres connectées).
Imaginez un conducteur sur une route verglacée : il ne connaît pas la réaction exacte de sa voiture aux mouvements du volant et doit apprendre en conduisant, en gardant intuitivement une marge de manœuvre pour une éventuelle erreur. C'est ainsi que fonctionne un algorithme de contrôle adaptatif.
Sur une carte topographique, les gouttes de pluie choisissent leur chemin : tombées sur un versant, elles s'écoulent vers la rivière A ; sur l'autre, vers la rivière B. L'observateur ne voit que les méandres des rivières (variables de réponse Y) et sait de quel versant provient l'eau (instrument Z), mais il ne voit pas les gouttes elles-mêmes (facteurs inobservés ε).
L'enchevêtrement quantique se comporte souvent comme une danse synchronisée qui n'est visible que sous un certain angle. Dès que l'on change la façon d'observer, les particules semblent désunies. Cela limite les communications sécurisées.
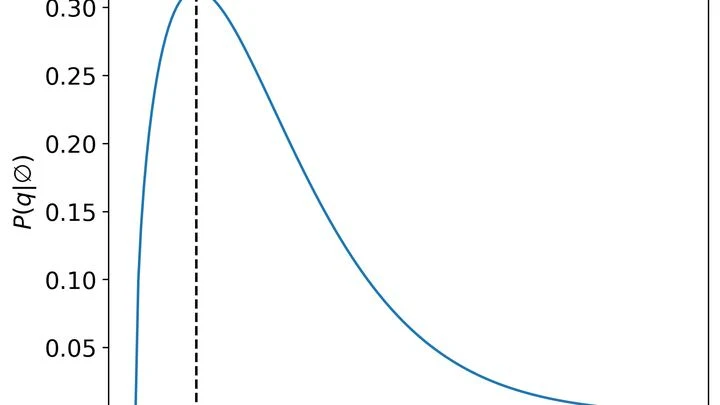
Le robot de laboratoire compte les molécules — et se trompe. Dans un tube, 0 ; dans un autre, 12 ; dans un troisième, 3, alors qu'en réalité, il y en a à peu près autant partout. Ces chiffres « bruts » sont monnaie courante en biologie : séquençage de l'ADN, comptage des espèces dans un échantillon d'eau, activité des gènes.
Deux jumeaux entrent dans une pièce par des portes différentes. Chacun reçoit une boîte avec un bouton — et chaque fois qu'ils appuient sur le bouton, une ampoule rouge ou verte s'allume. Si les jumeaux sont absolument identiques, on peut s'attendre à ce que leurs ampoules s'allument selon les mêmes règles internes.
Quand on entreprend des travaux, on n'achète pas la peinture au jugé, mais en fonction de la surface des murs. En science, le calcul du nombre d'échantillons est une estimation similaire, mais les enjeux sont plus élevés. En dessous du compte, l'étude devient une loterie : on peut passer à côté d'un effet réel, ou prendre du bruit pour une découverte.
Beaucoup de transformations chimiques ressemblent au montage d'un meuble dans l'obscurité totale : on voit les pièces de départ et l'armoire finie, mais le montage lui-même reste un mystère. Les états intermédiaires — comme les positions maladroites des mains de l'artisan — disparaissent trop vite pour être observés.
Dans l'espace, on rencontre souvent des paires de trous noirs en fusion où l'un est nettement plus massif que l'autre. Cette différence de poids n'est pas qu'un simple chiffre : c'est une clé pour comprendre leur histoire commune.
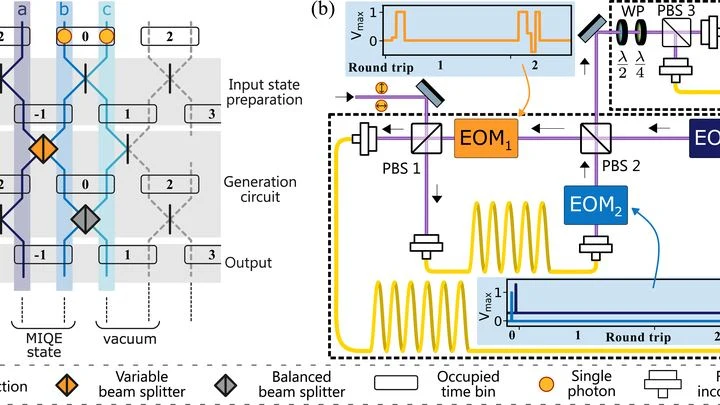
Deux dés tombent toujours du même côté, où qu'on les lance. En physique quantique, ce comportement est appelé intrication, et c'est la ressource clé pour les ordinateurs du futur et les communications sécurisées. Mais le problème, c'est que toute intrication n'est pas facile à repérer.
Le thé chaud refroidit, et sa température est la même dans toute la tasse. Mais dans de nombreux systèmes — par exemple, dans le gaz raréfié entre les étoiles ou dans le plasma — la température n'est pas constante : à un endroit, les particules sont plus rapides, à un autre, plus lentes.
Dans un laboratoire, on mesure un signal très faible — par exemple, une infime variation du champ magnétique. L'instrument vibre à cause des voitures qui passent, de la respiration de l'expérimentateur, de l'échauffement des fils. Ce bruit technique ne peut pas être éliminé complètement, et il fixe une limite à la précision.
Chaque cellule est un minuscule diapason. Une impulsion magnétique brève la fait « sonner », et l'amortissement de ce son dépend de ce qu'elle contient : viscosité, densité, composition.
Tous les corps tombent de la même façon – c'est ce qu'avait déjà remarqué Galilée. Einstein a transformé cette observation en principe d'équivalence : la pesanteur et l'accélération sont indiscernables, d'où est née la courbure de l'espace-temps.