Una matriz de confusión es una disposición de tabla específica que permite visualizar el rendimiento de un algoritmo de aprendizaje supervisado, típicamente un clasificador. Cada fila de la matriz representa las instancias de una clase real, mientras que cada columna representa las instancias de una clase predicha (o viceversa). El nombre proviene del hecho de que facilita ver si el sistema está confundiendo dos clases (es decir, etiquetando comúnmente una como otra).
Historia
El término se popularizó en el campo del aprendizaje automático en la década de 1960, aunque el concepto de tabla de contingencia en estadística es anterior. El origen exacto no está claro.
Cómo funciona
Para un problema de clasificación con N clases, la matriz es de N×N. Las celdas diagonales muestran el número de predicciones correctas para cada clase, mientras que las celdas fuera de la diagonal muestran clasificaciones erróneas. A partir de esta tabla, se pueden derivar métricas como exactitud, precisión, exhaustividad y puntuación F1. Para la clasificación binaria, la matriz es de 2×2 con entradas típicamente llamadas verdadero positivo, falso positivo, verdadero negativo y falso negativo.
En la práctica
Se utiliza en la evaluación y comparación de clasificadores en campos como el diagnóstico médico, la detección de spam y el reconocimiento de imágenes, donde comprender los tipos de errores importa más que la exactitud general.
Dato curioso
Una matriz de confusión puede usarse para calcular el coeficiente de correlación de Matthews, que es una métrica única que resume toda la matriz y suele ser más informativa que la exactitud para conjuntos de datos desequilibrados.
Cuatro mapas viejos dormían en cajones distintos. En cada uno había marcados genes relacionados con el envejecimiento celular, pero los mapas no coincidían: nombres diferentes, escalas diferentes, leyendas diferentes. El científico que buscaba un gen para su experimento tenía que cotejarlos a mano, con el riesgo de pasar por alto una marca importante.
Un radiólogo mira una tomografía abdominal y no ve solo órganos, sino su disposición mutua: qué riñón es más grande, dónde está el tumor respecto al vaso. Es como leer un mapa, donde no basta con saber dónde suele estar una ciudad, sino que hay que poder medir la distancia entre dos puntos del terreno.
Perderse en una sala de espejos es facilísimo: cada pared refleja a la otra y parece que ya has estado allí. Más o menos así se confunde el cerebro cuando hay muchos lugares parecidos alrededor. Las neuronas encargadas del mapa espacial pueden emitir la misma señal para dos esquinas distintas de una habitación. Esto se llama ambigüedad espacial.
En el almacén hay cajas con manzanas y peras. Hay muchas manzanas y pocas peras. Pero cuando el encargado dice «fruta con piel lisa», por alguna razón recordamos más a menudo la rara pera que la frecuente manzana. Eso es el efecto de la tasa base inversa: un fallo persistente en cómo el cerebro resuelve la ambigüedad entre categorías.
Cien mil estrellas en el denso núcleo de un cúmulo globular se mueven como bolas de acero en una gigantesca máquina de pinball. Cada «empujón» —un encuentro gravitacional entre un sistema binario y una estrella solitaria— desencadena una cascada de eventos impredecibles.
Un niño que explora un apartamento desconocido gatea de un objeto a otro y recuerda lo que se ve desde cada rincón. Así, el cerebro construye un mapa mental: un modelo interno del espacio. El algoritmo gradCSCG funciona con el mismo principio: recibe un flujo de video de una cámara y dibuja de forma autónoma el esquema de la habitación, basándose únicamente en el cambio de las imágenes.
Cuando una estrella gigante colapsa en una supernova o dos bolas de neutrones se fusionan en una danza cósmica, billones de neutrinos se llevan la energía del cataclismo.
Un enjambre de robots se asemeja a una bandada de luciérnagas: cada uno se mueve por instinto 'hacia donde hay más espacio', y el caos se convierte en orden. Durante mucho tiempo fue un misterio cómo surge la coordinación sin comunicación ni órdenes.
El microlente gravitacional es un asombroso efecto cósmico, predicho por Einstein y desarrollado por Zwicky. Un cuerpo masivo que pasa entre nosotros y una estrella lejana curva su luz como una lente, creando amplificaciones y distorsiones características.
La luz de galaxias lejanas galaxias viaja miles de millones de años hacia nosotros, pero en el camino la invisible telaraña de materia oscura la dobla y distorsiona. Este efecto, predicho por Einstein en el marco de la relatividad general, se conoce como lente gravitacional.
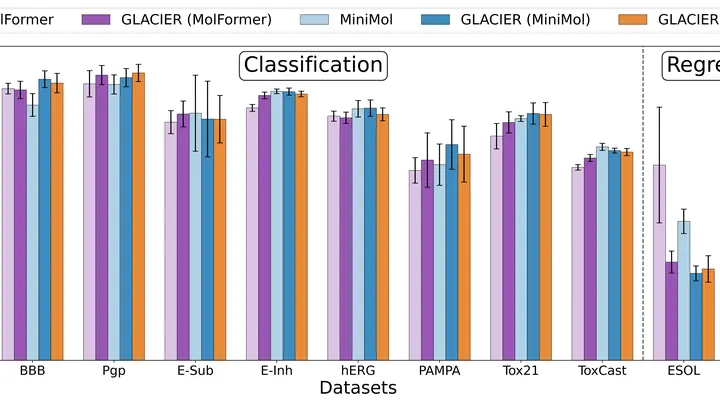
Buscar la molécula adecuada entre miles de millones de opciones es como buscar un grano de arroz en un saco lleno. Para no revisarlo todo a mano, los químicos recurren cada vez más a las redes neuronales. Pero los modelos grandes requieren ordenadores potentes, y a los pequeños a menudo les falta visión de conjunto.
El espacio-tiempo a menudo se representa como una tela lisa. Pero en el nivel más microscópico, esta tela podría no ser continua, sino estar formada por "átomos" individuales: eventos conectados por causalidad. Esta imagen del mundo se llama teoría de conjuntos causales.
Pruebas un plato en un restaurante, pero no has visto el menú. Le haces preguntas al camarero: ¿está muy salado? ¿qué especias tiene? — y por las respuestas intentas adivinar qué chef lo preparó.
Si le muestras la misma foto de un gato a dos redes neuronales diferentes, a menudo llegan a una conclusión similar: «gato». Pero si les preguntas con más detalle, las respuestas pueden divergir. Un modelo se fijará en los bigotes, otro en el pelaje, un tercero en la postura. Resulta que incluso dentro del mundo «visual» de las redes neuronales no hay una unidad total.
Una aleación de siete metales es como un equipo donde cada jugador tira de la manta hacia sí. Los átomos de hierro, cobalto, níquel, aluminio, titanio, tantalio y vanadio pueden colocarse en un patrón estricto o dispersarse en posiciones aleatorias. De ello depende que el material sea tan resistente como el acero o tan ligero como el aluminio.
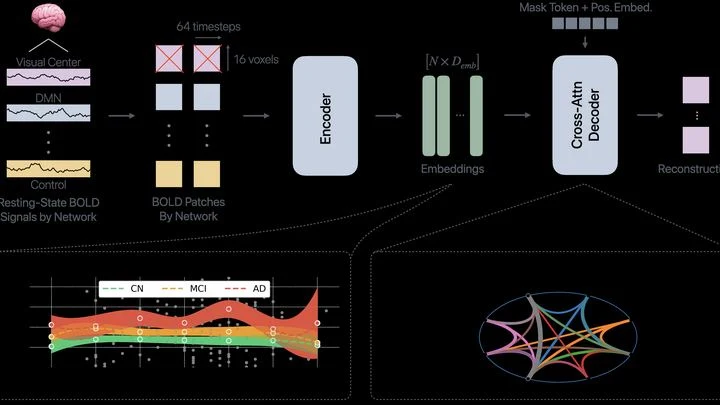
El cerebro no es una sola computadora grande, sino más bien una orquesta donde diferentes grupos de músicos tocan sus partes. Las redes de neuronas encargadas de la memoria, la atención o las emociones están constantemente conversando entre sí. En la enfermedad de Alzheimer, esta orquesta comienza a desafinar: algunos grupos se callan, otros tocan fuera de tiempo.
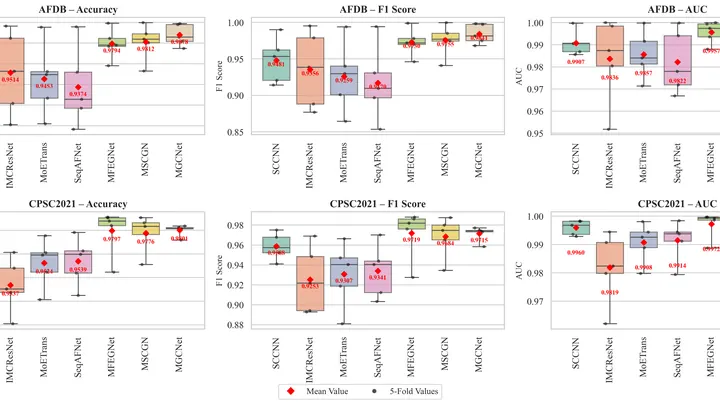
El corazón no late como un metrónomo, sino como un batería de jazz: a veces se descompasa, salta latidos, se acelera. La fibrilación auricular es uno de los fallos más traicioneros: las aurículas tiemblan en lugar de contraerse, y la sangre puede estancarse y formar coágulos.