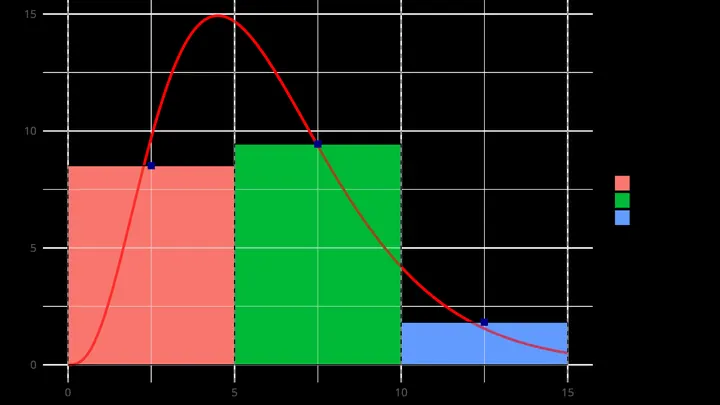
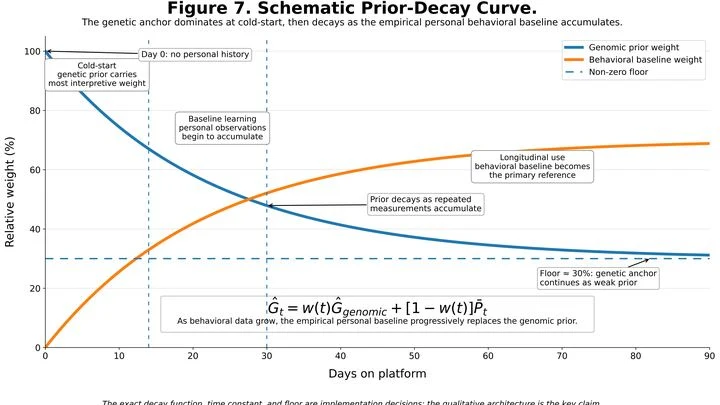
Una distribución previa codifica lo que se supone sobre un parámetro antes de recopilar cualquier dato. En la estadística bayesiana, la previa se combina con la verosimilitud de los datos observados para producir la distribución posterior, que representa la creencia actualizada tras ver los datos. La elección de la previa es a menudo el aspecto más debatido del análisis bayesiano porque puede influir fuertemente en el resultado final, especialmente cuando los datos son escasos o poco informativos.
Historia
El concepto se remonta a Thomas Bayes en el siglo XVIII, pero el tratamiento formal y el debate sobre las previas fueron desarrollados por Pierre-Simon Laplace y más tarde por estadísticos modernos como Harold Jeffreys en el siglo XX.
Cómo funciona
La previa asigna una probabilidad a cada valor posible del parámetro. Una previa 'plana' o uniforme da el mismo peso a todos los valores, pero esto no siempre es la elección más neutral; por ejemplo, una previa uniforme sobre un parámetro de tasa no es uniforme sobre su logaritmo. Las previas informativas pueden incorporar restricciones físicas conocidas, como la positividad o límites de experimentos anteriores. La posterior es proporcional a la previa multiplicada por la verosimilitud, por lo que la previa actúa como un factor de ponderación que atrae la estimación hacia regiones de alta probabilidad previa.
En la práctica
Las previas se utilizan en física de partículas para establecer límites sobre nuevas partículas, en cosmología para estimar parámetros cosmológicos a partir de datos del fondo cósmico de microondas, y en aprendizaje automático para regularizar modelos.
Dato curioso
En física de altas energías, la elección de la previa puede ser tan trascendental que el campo ha desarrollado métodos 'independientes de la previa', como el método CLs, para evitar depender de previas subjetivas al reclamar descubrimientos.
Dos corredores parten en una pista con pendiente variable. Uno sale antes, el otro después, y el juez mide sus velocidades sin saber que hubo diferencia en la salida. Algo parecido ocurre con las variantes del virus: los datos llegan con retraso, y si esos retrasos no son iguales, la estimación de la ventaja competitiva puede ser gravemente errónea.
Un ingeniero de proteínas se parece a un cocinero que intenta hacer un plato que sea a la vez sabroso, saludable y barato. Al cambiar un ingrediente, corre el riesgo de estropear otro. Antes, los asistentes informáticos solo podían evaluar las propiedades de las proteínas por separado, sin ver cómo se relacionan entre sí.
Un pez solitario ve una sombra sobre su cabeza. ¿Huir? Si es solo una hoja, habrá gastado energía en vano y se habrá delatado ante un depredador. Si es una garza, la demora es mortal. Así es el eterno compromiso del solitario: reaccionar rápido significa muchas falsas alarmas; ser cauto significa arriesgarse a ser devorado.
En un banco, todo es diferente.
Un coágulo crece como una bola de nieve que rueda montaña abajo: al principio es pequeño, va atrapando capas nuevas, y cuándo se convertirá en una avalancha es difícil de adivinar. En la sangre se desencadena una larga cadena de reacciones —la cascada de coagulación—, donde una sustancia despierta a otra y el coágulo gana masa.
Un «calibrador» cósmico pronto medirá una estrella de neutrones con una precisión de cien metros. Para un objeto de un par de decenas de kilómetros de diámetro, es como medir el grosor de un cabello humano desde un kilómetro de distancia.
Una estrella de neutrones es el remanente de una supernova que explotó.
En 1998, el matemático David Boyd notó algo extraño. Estudiaba la medida de Mahler de un polinomio —una cantidad que mide la "complejidad" de sus raíces— y descubrió que para una familia de curvas siempre se expresa como un número racional especial racional multiplicado por el valor de la derivada de la función L.
La célula de la ameba Dictyostelium se arrastra sobre el vidrio. Su camino queda registrado: una cadena de puntos en el plano. Pero, ¿qué fuerzas la empujan? Dentro de la célula trabaja un motor molecular: las proteínas tiran, la membrana se estira, el agua presiona.
El 23 de noviembre de 2023, los detectores de LIGO captaron algo extraño. La señal de ondas gravitacionales de la fusión de dos agujeros negros, denominada GW231123, apuntaba a masas récord — 137 y 101 masas solares — y una rotación anómalamente rápida. Sería la pareja más masiva y de rotación más rápida jamás registrada.
Una estrella de neutrones es el núcleo que fue de una estrella masiva, comprimido hasta el tamaño de una ciudad. Una cucharadita de su materia pesa como una montaña. Pero dentro de esta esfera ultradensa puede esconderse una sorpresa: bajo una presión inimaginable, los neutrones se descomponen en quarks y la estrella adquiere un núcleo nuevo, más compacto.
En combate, un piloto necesita entender al instante qué objeto es y cuáles son sus intenciones. Los sistemas convencionales esperan datos completos del radar, como un portero que solo reacciona después del disparo. El nuevo algoritmo funciona como un portero experimentado: a partir de los primeros movimientos del delantero, predice la maniobra del objetivo.
Los modelos habituales consideran que el contagio es como un flujo uniforme de agua que siempre baña a todos por igual. En realidad, del enfermo emana un flujo cambiante: justo después del contagio apenas gotea, luego se convierte en un aguacero torrencial y después se calma.
Las células de un mismo organismo son como panaderos gemelos en una cocina compartida. Tienen el mismo libro de recetas (ADN), pero al copiar la receta en un apunte y al montar el plato, surgen errores aleatorios. Esta imprevisibilidad —la entropía— hace que en células idénticas a veces haya mucha proteína y a veces poca.
Los audífonos tradicionales se parecen a un cocinero que sigue una receta a ciegas. Analizan el desorden sonoro del micrófono y, basándose en él, amplifican el habla. En una cafetería ruidosa, este enfoque a menudo falla. El nuevo sistema se comporta como un chef experimentado: primero procesa la señal y luego prueba el resultado.
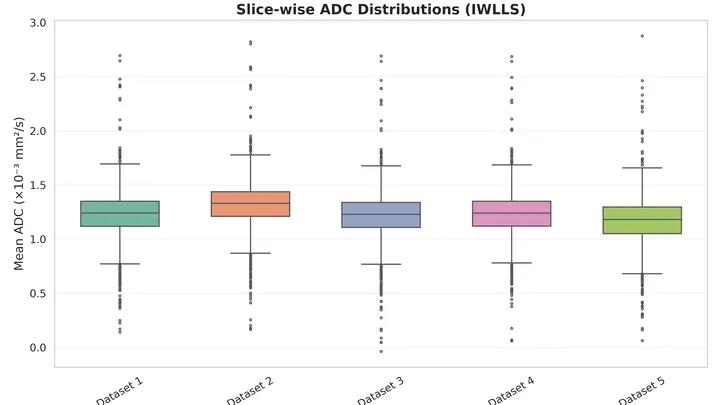
Las imágenes de resonancia magnética de la próstata a menudo se parecen a fotos a través de un cristal sucio: ruido, contornos borrosos, curvatura por imperfecciones del campo. Los científicos comprobaron qué sucede si «lavamos» esa ventana: eliminar lo superfluo, corregir las distorsiones y alinear con precisión los diferentes tipos de escaneos.
Las señales gravitacionales de estrellas masivas moribundas son susurros que nos llegan desde los laboratorios más violentos del Universo. Einstein predijo estas ondas gravitacionales hace más de un siglo, pero solo hoy, con detectores como LIGO, comenzamos a escucharlas.
Imagina un baile en un salón desconocido: dos invitados comienzan desde esquinas opuestas. Sus movimientos no son un vals suave, sino una improvisación caótica en busca de tesoros raros. Contrariamente a la intuición, el resultado no lo decidirá el ritmo, sino la geometría del parqué.
Las máquinas zumban dentro de la presa de hormigón, funcionando en vacío. Tres de las diez turbinas permanecen en silencio. El nivel del agua en el mayor embalse del sureste de Brasil ha caído tanto que las palas están a punto de empezar a girar en el aire.
El Universo no está en silencio: está lleno de un continuo rumor de ondas gravitacionales. Dentro de una década, el observatorio espacial LISA afinará sus «oídos» al rango de milihercios, y la fuente más rica resultará ser nuestra Galaxia: decenas de miles de pares de enanas blancas girando en una danza…
Estamos acostumbrados a pensar que notar solo las confirmaciones de nuestras suposiciones es un error. Pero cálculos recientes, inspirados en el comportamiento de las ondas, le dan la vuelta a esta visión. Resulta que el hábito de buscar lo familiar es la mejor manera de reducir el ruido informativo (los científicos lo llaman entropía).
Compras una báscula de cocina nueva, pero en lugar de mostrar el peso exacto, solo indica la desviación respecto a una "norma". Para saber cuánto pesa una manzana, primero tienes que pesar decenas de otras manzanas y calcular el promedio.
A través de las ondulaciones del agua, las piedras en el fondo de la piscina parecen desplazadas y distorsionadas. De manera similar, la gravedad de la materia oscura invisible curva la luz de las galaxias lejanas: este fenómeno se conoce como lente gravitacional débil.
La búsqueda de vida en planetas lejanos es como diagnosticar una enfermedad rara con una prueba de precisión desconocida. Un resultado positivo aislado no significa nada: ¿y si es un fallo?
La mano descansa sobre la mesa y llegan dos vibraciones cortas a la muñeca, una tras otra. Hay que decir cuál es más fuerte. La tarea parece simple, pero la respuesta depende de cuál vibración fue primero. Si la primera es débil y la segunda fuerte, la diferencia parece mayor que cuando se invierten.
Un álbum con cientos de fotos familiares guarda muchas historias. Si miras cada foto por separado, es fácil pensar que el tío es un verdadero gigante: ese día estaba un escalón más arriba que los demás. Pero basta con hojear todo el álbum para darse cuenta de que su estatura es normal; simplemente el escalón apareció en un par de fotos.
Una red neuronal médica típica ve al paciente como un punto en un mapa: hay estatura, presión, análisis de sangre, y el modelo coloca una única etiqueta: «sano» o «enfermo». Pero en un hospital real, el mapa siempre está roto. Un análisis se hace el lunes, otro un mes después, y el tomógrafo es de otra marca. Un punto en ese mapa es un autoengaño.
Cuando revuelves el té con una cuchara, se ve cómo los grandes remolinos se descomponen gradualmente en otros más pequeños, hasta que el movimiento se detiene. Los físicos llaman a este proceso turbulencia en decadencia.
Antes de cada arranque de un tokamak —el dispositivo donde un gas sobrecalentado se mantiene confinado por un campo magnético—, los operadores pasan horas calculando cómo se comportará el plasma. Equivocarse es demasiado caro: un solo parámetro incorrecto puede arruinar el experimento.
En el interior de una estrella de neutrones, la materia está comprimida a densidades inimaginables. Antes, los científicos especulaban sobre cómo estaban organizadas las cosas allí, probando posibles ecuaciones que relacionan presión y densidad. El nuevo enfoque descarta las conjeturas: vincula directamente la masa y el radio, que son medibles, con la estructura interna.