Пермутационный тест — это непараметрический метод проверки статистической гипотезы, не требующий предположений о распределении данных. Вместо опоры на теоретические распределения (например, нормальное) он строит нулевое распределение непосредственно из наблюдаемых данных, случайным образом перемешивая метки или групповые принадлежности. Это особенно полезно, когда объём выборки мал или данные не подчиняются стандартным распределениям.
История
Метод был предложен Р. А. Фишером в 1930-х годах, однако вычислительно реализуемым он стал лишь с появлением современных компьютеров.
Как это работает
Процедура проста. Сначала вычисляют тестовую статистику (например, разность средних между двумя группами) на исходных данных. Затем многократно случайным образом перемешивают метки точек данных, каждый раз заново вычисляя тестовую статистику. Эти перемешанные значения образуют нулевое распределение — распределение статистики при отсутствии реального эффекта. p-значение — это доля перемешанных статистик, которые столь же экстремальны или более экстремальны, чем наблюдаемая статистика. Если эта доля очень мала, наблюдаемый результат вряд ли мог получиться случайно.
Где применяется
Метод применяется в геномике для проверки дифференциальной экспрессии генов, в нейронауках для анализа данных нейровизуализации, а также в любых областях, где малые выборки или ненормальные данные делают традиционные тесты ненадёжными.
Любопытный факт
Пермутационные тесты являются точными: они не опираются на асимптотические приближения, то есть p-значение корректно даже для очень малых объёмов выборки.
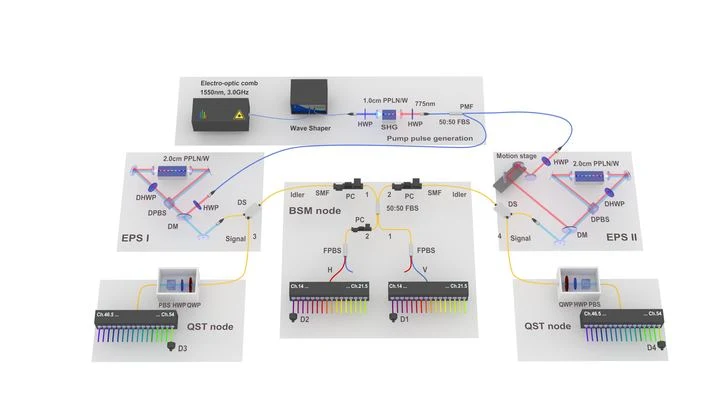
Квантовая связь похожа на передачу секретного письма, которое рвётся при любой попытке подглядеть. Пока такое письмо можно послать только по одной дороге, и это медленно. Учёные придумали, как пустить сразу 16 курьеров по 16 параллельным дорогам — разным частотам света — и проверили, что письма доходят целыми.
Глюкометр, которому не нужно прокалывать палец, а достаточно лишь «взглянуть» на запястье, — мечта миллионов людей с диабетом. Именно её обещают алгоритмы, извлекающие уровень глюкозы из обычного сигнала пульса — фотоплетизмограммы (ФПГ), той самой кривой, что измеряет частоту сердечных сокращений в умных часах.
Представьте водителя на обледенелой трассе: он не знает точной реакции машины на поворот руля и вынужден учиться в процессе, интуитивно сохраняя запас пространства для возможной ошибки. Сходным образом действует адаптивный алгоритм управления.
На топографической карте дождевые капли выбирают путь: упав на один склон, они стекают в реку А, на другой — в реку Б. Наблюдатель видит лишь извивы рек (переменные отклика Y) и знает, с какого склона пришла вода (инструмент Z), но не видит самих капель (ненаблюдаемых факторов ε).
Квантовая запутанность — это явление, при котором частицы ведут себя как партнёры в синхронном танце, но видимом лишь под определённым углом. Стоит изменить способ наблюдения, и их согласованность исчезает, что ограничивает применение в защищённой связи.
Лабораторный робот отсчитывает молекулы — и сбивается. В одной пробирке 0, в другой 12, в третьей 3, хотя на самом деле везде примерно поровну. Такие «сырые» цифры — обычное дело в биологии: секвенирование ДНК, подсчёт видов в пробе воды, активность генов. Данных много, но они разрежены и разбросаны сильнее, чем допускает простая случайность.
Два близнеца входят в комнату с разных дверей. Каждый получает по коробке с кнопкой — и каждый раз, когда они нажимают на кнопку, загорается либо красная, либо зелёная лампочка. Если близнецы абсолютно одинаковы, можно ожидать, что и лампочки у них загораются по одним и тем же внутренним правилам. Но что, если правила разные, хотя сами близнецы — точные копии?
Именно такую ситуацию изучали авторы работы.
Затевая ремонт, краску покупают не на глаз, а по площади стен. В науке счёт образцов — такая же прикидка, только ставки выше. Недобор — и работа превращается в лотерею: можно пропустить реальный эффект, а можно случайно принять шум за открытие. Перебор — лишние пробирки, потраченные месяцы и, в опытах с животными, напрасные жизни.
В микробиоме эта задачка особенно хитрая.
Многие химические превращения напоминают сборку мебели в полной темноте: видны исходные детали и готовый шкаф, но сама сборка остаётся загадкой. Промежуточные состояния — словно неудачные положения рук мастера — исчезают слишком быстро, чтобы их разглядеть.
В космосе часто встречаются пары сливающихся чёрных дыр, где одна заметно массивнее другой. Эта разница в весе — не просто цифра, а ключ к их общей истории.
Астрофизики изучили канал стабильного переноса массы — процесс, при котором вещество с одной звезды плавно перетекает на другую, не разрушая систему.
Два игральных кубика всегда выпадают одинаково, как бы далеко их ни раскидали. В квантовой физике такое поведение называют запутанностью, и она — главный ресурс для компьютеров будущего и защищённой связи. Но беда в том, что не всякую запутанность легко заметить.
Горячий чай остывает, и его температура одинакова во всей чашке. Но во многих системах — например, в разреженном газе между звёздами или в плазме — температура не постоянна: в одном месте частицы быстрее, в другом медленнее. Физики называют такие системы «суперстатистическими»: это как если бы чай состоял из множества маленьких областей, каждая со своей температурой.
В лаборатории измеряют очень слабый сигнал — например, крошечное изменение магнитного поля. Прибор дрожит от проезжающих машин, от дыхания экспериментатора, от нагрева проводов. Этот технический шум не убрать полностью, и он ставит предел точности. Обычный датчик работает как весы, которые качаются от любого сквозняка.
Каждая клетка — миниатюрный камертон. Резкий магнитный импульс заставляет её «звучать»: ядра водорода, входящие в состав клеточной воды, возбуждаются и, возвращаясь в равновесие, порождают слабый магнитный сигнал. Затухание этого «звука» зависит от свойств внутриклеточной среды — вязкости, плотности, молекулярного состава.
Все тела падают одинаково — это подметил ещё Галилей. Эйнштейн возвёл наблюдение в фундаментальный принцип эквивалентности: гравитация и ускорение неразличимы, из чего родилось искривлённое пространство-время.
Черновой набросок портрета: несколько уверенных линий задают форму, но детали ещё не проработаны. Так параметрическая модель, например векторная авторегрессия (VAR), описывает временной ряд: она улавливает основную структуру, но если реальные данные отклоняются от её предположений, портрет получается искажённым.
Переводчик, который отвлекается на каждый шорох в зале, к концу совещания начинает путаться в словах. Его уверенность в собственной правоте растёт, а точность падает. Примерно так ведут себя плохо откалиброванные вероятностные прогнозы: модель заявляет высокую вероятность события, но реальность с ней не согласна.
Оркестр играет сложную пьесу, и каждая группа инструментов вступает по своему расписанию. Скрипки могут замедлиться, пока духовые держат прежний темп, а ударные вдруг взорвутся дробью. Дирижёр слышит всё сразу, но определить, в какой именно момент изменился ритм у флейт, а не у виолончелей, почти невозможно.
Переводчик учится не по словарю, а по речам. Он слушает, как говорят носители, и улавливает правила, которые не записаны ни в одном учебнике. Так и новый метод прогнозирования сложных систем, таких как климат или турбулентность, не требует знать их уравнения. Вместо этого он смотрит на данные и учится предсказывать их поведение.