Una prueba de permutación es un método no paramétrico para contrastar una hipótesis estadística sin hacer suposiciones sobre la distribución subyacente de los datos. En lugar de depender de distribuciones teóricas (como la distribución normal), construye la distribución nula directamente a partir de los datos observados, reordenando aleatoriamente las etiquetas o asignaciones de grupo. Esto resulta especialmente útil cuando el tamaño de la muestra es pequeño o los datos no siguen distribuciones estándar.
Historia
El método fue introducido por R. A. Fisher en la década de 1930, aunque solo se volvió computacionalmente práctico con la llegada de las computadoras modernas.
Cómo funciona
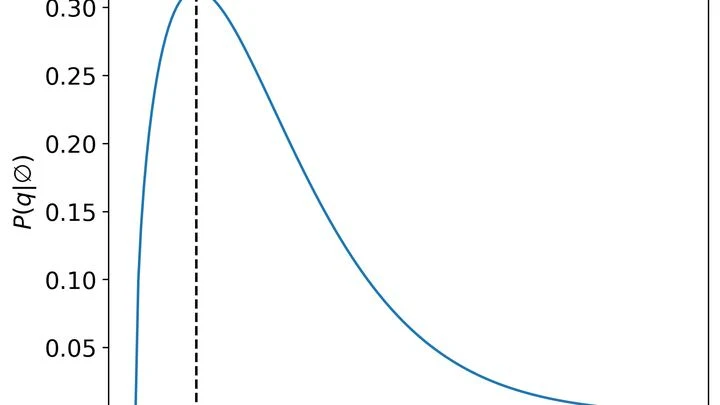
El procedimiento es sencillo. Primero, se calcula un estadístico de prueba (por ejemplo, la diferencia de medias entre dos grupos) con los datos originales. Luego, se reordenan aleatoriamente las etiquetas de los puntos de datos en repetidas ocasiones, recalculando el estadístico cada vez. Estos valores reordenados forman la distribución nula: la distribución del estadístico si no hubiera un efecto real. El valor p es la proporción de estadísticos reordenados que son tan extremos o más extremos que el estadístico observado. Si esta proporción es muy pequeña, es poco probable que el resultado observado haya ocurrido por azar.
En la práctica
Se utiliza en genómica para probar la expresión diferencial de genes, en neurociencia para datos de imágenes cerebrales y en cualquier campo donde las muestras pequeñas o los datos no normales hagan que las pruebas tradicionales no sean fiables.
Dato curioso
Las pruebas de permutación son exactas: no se basan en aproximaciones asintóticas, lo que significa que el valor p es correcto incluso para tamaños de muestra muy pequeños.
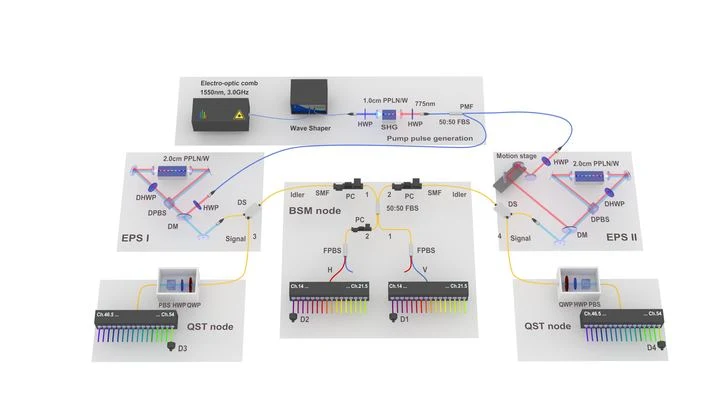
La comunicación cuántica es como enviar una carta secreta que se destruye si alguien intenta leerla. Hasta ahora, esa carta solo podía enviarse por un único camino, y eso era lento. Los científicos han ideado la manera de enviar 16 mensajeros por 16 caminos paralelos —diferentes frecuencias de luz— y han comprobado que las cartas llegan intactas.
Un glucómetro que no pincha el dedo, sino que simplemente mira la muñeca: el sueño de millones de personas con diabetes. Eso es lo que prometen los algoritmos que extraen el nivel de glucosa de la señal habitual del pulso, la fotopletismografía (esa misma que mide el pulso en los relojes inteligentes).
Un conductor en una carretera resbaladiza no sabe exactamente cómo reaccionará el coche al volante, y aprende sobre la marcha, dejando margen para el error. De manera similar se comporta un algoritmo de control inteligente.
En un mapa topográfico, las gotas de lluvia eligen su camino: al caer en una ladera, fluyen hacia el río A; en otra, hacia el río B. El observador solo ve los meandros de los ríos (variables de respuesta Y) y sabe de qué ladera proviene el agua (instrumento Z), pero no ve las gotas en sí (factores no observables ε).
El entrelazamiento cuántico a menudo se comporta como una danza sincronizada, visible solo desde un ángulo. Basta cambiar la forma de observar y las partículas parecen desordenadas. Esto limita la comunicación segura. Ahora, físicos han creado un par de fotones cuya 'danza' es impecable desde cualquier perspectiva.
El robot de laboratorio cuenta moléculas y se equivoca. En un tubo hay 0, en otro 12, en un tercero 3, aunque en realidad en todos hay aproximadamente lo mismo. Estas cifras "crudas" son algo habitual en biología: secuenciación de ADN, recuento de especies en una muestra de agua, actividad génica. Hay muchos datos, pero son dispersos y varían más de lo que permitiría el azar simple.
Dos gemelos entran en una habitación por puertas distintas. Cada uno recibe una caja con un botón, y cada vez que pulsan el botón, se enciende una luz roja o verde. Si los gemelos son absolutamente idénticos, cabría esperar que sus luces se enciendan según las mismas reglas internas.
Cuando uno emprende una reforma, no compra la pintura a ojo, sino según la superficie de las paredes. En ciencia, contar muestras es una estimación parecida, solo que las apuestas son más altas. Si te quedas corto, el trabajo se convierte en una lotería: puedes pasarte por alto un efecto real, o puedes confundir el ruido con un descubrimiento.
Muchas transformaciones químicas se asemejan al ensamblaje de muebles en la oscuridad total: se ven las piezas iniciales y el armario terminado, pero el ensamblaje en sí sigue siendo un misterio. Los estados intermedios, como las posiciones fallidas de las manos del artesano, desaparecen demasiado rápido para distinguirlos.
En el espacio son frecuentes las parejas de agujeros negros que se fusionan, donde uno es notablemente más masivo que el otro. Esa diferencia de peso no es solo un número, sino la clave de su historia común.
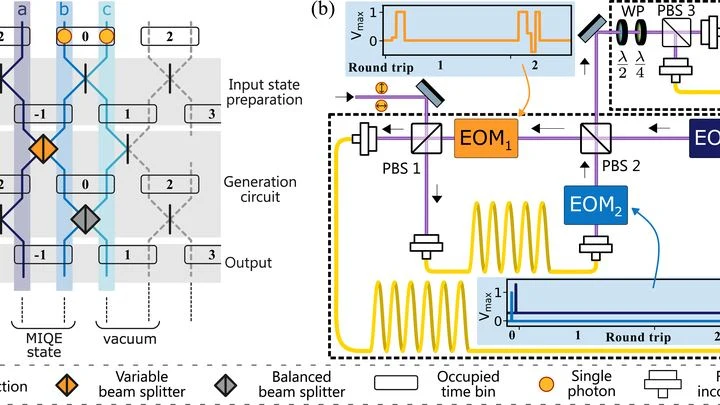
Dos dados siempre caen del mismo lado, sin importar cuán lejos se lancen. En física cuántica, este comportamiento se llama entrelazamiento, y es el recurso principal para las computadoras del futuro y las comunicaciones seguras. Pero el problema es que no todo entrelazamiento es fácil de detectar.
El té caliente se enfría y su temperatura es la misma en toda la taza. Pero en muchos sistemas —por ejemplo, en el gas enrarecido entre las estrellas o en el plasma— la temperatura no es constante: en un lugar las partículas van más rápido, en otro más lento.
En el laboratorio se mide una señal muy débil, por ejemplo, un cambio diminuto en el campo magnético. El instrumento tiembla por los coches que pasan, por la respiración del experimentador, por el calentamiento de los cables. Ese ruido técnico no se puede eliminar por completo y limita la precisión.
Cada célula es un diapasón en miniatura. Un fuerte pulso magnético la hace "sonar", y la atenuación de ese sonido depende de lo que hay dentro: viscosidad, densidad, composición. Un diminuto diamante con un defecto en su estructura funciona como un micrófono ultrasensible, captando los ecos magnéticos de células individuales.
Todos los cuerpos caen de la misma manera — lo notó Galileo. Einstein convirtió esta observación en el principio de equivalencia: la gravedad y la aceleración son indistinguibles, de lo cual nació el espacio-tiempo curvado.