El tamaño de muestra es el número de observaciones individuales, participantes o puntos de datos incluidos en un estudio. Es un parámetro fundamental en estadística porque influye directamente en la precisión de las estimaciones y en la potencia de las pruebas de hipótesis. Un tamaño de muestra mayor generalmente reduce el error de muestreo, haciendo que los resultados sean más fiables y con mayor probabilidad de reflejar el efecto real de la población, mientras que un tamaño de muestra menor aumenta el riesgo de no detectar efectos reales o de producir efectos espurios.
Historia
El concepto formal de tamaño de muestra y su papel en la inferencia se desarrolló a principios del siglo XX, notablemente a través del trabajo de Ronald Fisher en las décadas de 1920 y 1930, quien estableció el marco para el diseño experimental y la prueba de hipótesis.
Cómo funciona
La inferencia estadística se basa en la idea de que una muestra se aproxima a la población de la que se extrae. El error estándar de una estimación disminuye a medida que aumenta la raíz cuadrada del tamaño de muestra, por lo que duplicar el tamaño de muestra reduce aproximadamente a la mitad el margen de error. El análisis de potencia, que determina el tamaño de muestra mínimo necesario para detectar un efecto de una magnitud dada, equilibra el nivel de significancia deseado, el tamaño del efecto y la potencia estadística.
En la práctica
Los cálculos de tamaño de muestra son habituales en ensayos clínicos, encuestas de ciencias sociales y control de calidad para garantizar que los estudios no tengan potencia insuficiente ni sean innecesariamente grandes.
Dato curioso
En algunos campos, el problema del 'p-hacking' —donde los investigadores recopilan datos hasta que los resultados se vuelven significativos— aprovecha el hecho de que aumentar el tamaño de muestra puede convertir un resultado no significativo en uno significativo, incluso cuando el efecto real es nulo.
Una orquesta de treinta y seis instrumentos toca casi al unísono. El director intenta distinguir qué voz lleva la melodía, pero los sonidos se funden y cada compás añade nuevas dudas.
Un pez solitario ve una sombra sobre su cabeza. ¿Huir? Si es solo una hoja, habrá gastado energía en vano y se habrá delatado ante un depredador. Si es una garza, la demora es mortal. Así es el eterno compromiso del solitario: reaccionar rápido significa muchas falsas alarmas; ser cauto significa arriesgarse a ser devorado.
En un banco, todo es diferente.
En invierno, en un barrio de la ciudad cae el triple de nieve que en el vecino. Un año hace calor, otro frío. Son los caprichos del tiempo. Pero a lo largo de décadas se observa otro cambio, más lento: los inviernos, en promedio, se vuelven más suaves. Distinguir uno de otro es la tarea principal de los climatólogos.
Un frasco de perfume no es solo vidrio con líquido. Es una huella del tiempo, una melodía congelada hecha de notas aromáticas. Desde 1900 hasta 2024 se han acumulado decenas de miles de estas «melodías», y ahora pueden estudiarse como un organismo único.
Normalmente la complejidad de los sistemas –desde el movimiento de satélites hasta los ritmos cardíacos– se evalúa con la entropía promedio (medida de imprevisibilidad, tal como la entendía Boltzmann).
Los modelos habituales consideran que el contagio es como un flujo uniforme de agua que siempre baña a todos por igual. En realidad, del enfermo emana un flujo cambiante: justo después del contagio apenas gotea, luego se convierte en un aguacero torrencial y después se calma.
La evolución fluye como el agua. En un río ancho los cambios son suaves y lentos, mientras que un arroyo de montaña bulle con cada piedra. El tamaño de la población y la frecuencia de las mutaciones determinan el cauce: ancho y tranquilo o estrecho y lleno de rápidos.
Imagina un baile en un salón desconocido: dos invitados comienzan desde esquinas opuestas. Sus movimientos no son un vals suave, sino una improvisación caótica en busca de tesoros raros. Contrariamente a la intuición, el resultado no lo decidirá el ritmo, sino la geometría del parqué.
Los 120 habitantes de Montelago no son personas, sino personajes digitales. Cada uno, además de un nombre y una biografía, tiene tres coordenadas ocultas: la confianza en las autoridades municipales, la evaluación de la fiabilidad de la fuente y la percepción de lo adecuada que es la información. Estos números los conocen los creadores, pero no el propio sistema.
Cuando uno emprende una reforma, no compra la pintura a ojo, sino según la superficie de las paredes. En ciencia, contar muestras es una estimación parecida, solo que las apuestas son más altas. Si te quedas corto, el trabajo se convierte en una lotería: puedes pasarte por alto un efecto real, o puedes confundir el ruido con un descubrimiento.
En 1948, el ingeniero Claude Shannon sentó las bases de la teoría de la información. El teorema de Nyquist-Shannon dio la primera respuesta: para no perder la señal, debe haber el doble de mediciones que el detalle más rápido de la misma. En 2006, el método de muestreo comprimido (compressed sensing) relajó este requisito.
Esparce un puñado de monedas sobre la mesa. Cada moneda es un resultado posible: cara, cruz o algo más. Si sabemos cuán caótico es este conjunto (su entropía), ¿qué combinaciones de probabilidades encontraremos con más frecuencia? Resulta que la respuesta depende de cuánto caos permitamos.
Diminutos imanes en una red, el clásico modelo de Ising, suelen describir cómo los vecinos se influyen entre sí. Pero, ¿qué ocurre cuando el sistema es observado de cerca? Cada medición de la energía de un enlace es como una mirada que obliga a los imanes a 'decidir' su estado.
La mano descansa sobre la mesa y llegan dos vibraciones cortas a la muñeca, una tras otra. Hay que decir cuál es más fuerte. La tarea parece simple, pero la respuesta depende de cuál vibración fue primero. Si la primera es débil y la segunda fuerte, la diferencia parece mayor que cuando se invierten.
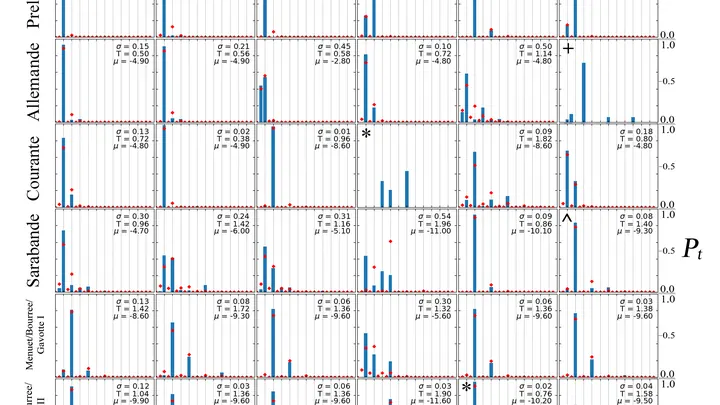
La música se sostiene sobre la repetición: esperamos que el acento vuelva, como vuelve el estribillo. Pero si se repite lo mismo durante demasiado tiempo, llega el aburrimiento. El compositor parece caminar sobre la cuerda floja entre lo familiar y lo inesperado.
Los científicos tradujeron ese equilibrio al lenguaje de la física.
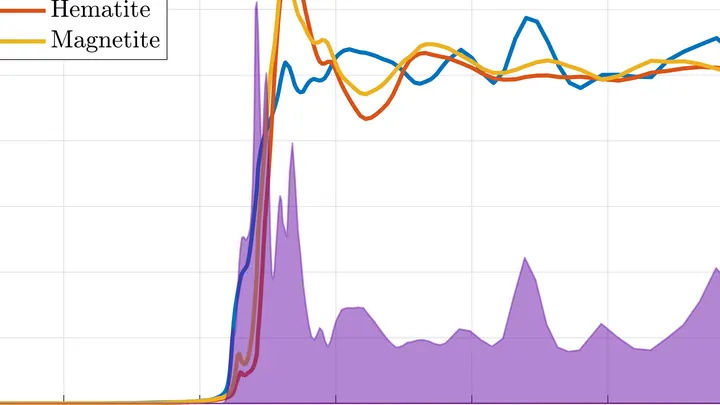
El mapa químico de una muestra se parece a un mosaico: cada punto tiene su propio color, su propia composición química. Para armar ese mosaico, el espectromicroscopio escanea la muestra punto por punto, registrando en cada uno un espectro, la "huella" de cómo la materia absorbe o emite luz.
Un químico que busca un nuevo fármaco se parece a un cocinero sin receta: tiene una lista de propiedades deseadas, pero millones de ingredientes posibles. Cada prueba cuesta caro y lleva tiempo, así que hay que probar con inteligencia.
El nuevo programa SEISMO actúa como un cocinero que prueba el plato tras cada paso y decide al instante qué añadir después.
El diagnóstico genético se parece a comparar dos fotografías tomadas con cámaras distintas. Si una cámara altera un poco los colores, en la imagen aparecen «defectos» que no existen en la realidad.