Le taux d'apprentissage est un hyperparamètre en apprentissage automatique qui contrôle la taille du pas lors de la mise à jour des paramètres d'un modèle pendant l'entraînement. Il détermine la vitesse à laquelle l'erreur (perte) du modèle diminue au fil des itérations sur les données. Un taux d'apprentissage élevé fait apprendre le modèle rapidement mais risque de dépasser la solution optimale ; un taux faible rend l'apprentissage lent mais plus stable. Le taux d'apprentissage est l'un des réglages les plus critiques dans l'entraînement des réseaux de neurones, car il influence directement la convergence et la performance finale.
Histoire
Le concept de taux d'apprentissage est apparu avec le développement de l'optimisation par gradient dans les années 1950 et 1960, notamment dans le cadre de l'apprentissage du perceptron et des premiers réseaux de neurones. Il est devenu un terme standard dans les années 1980 avec la rétropropagation.
Comment ça marche
Pendant l'entraînement, le modèle calcule le gradient de la fonction de perte par rapport à ses paramètres. Les paramètres sont ensuite mis à jour en soustrayant le gradient multiplié par le taux d'apprentissage. C'est la règle standard de descente de gradient. Le taux d'apprentissage ajuste l'ampleur du pas : une valeur plus grande signifie des sauts plus importants dans l'espace des paramètres, tandis qu'une valeur plus petite permet des ajustements plus fins. Les optimiseurs modernes comme Adam ajustent de manière adaptative le taux d'apprentissage pour chaque paramètre, mais le taux de base doit toujours être défini par le praticien.
En pratique
La planification du taux d'apprentissage — c'est-à-dire son ajustement au cours de l'entraînement — est utilisée dans pratiquement toutes les applications d'apprentissage profond, de la reconnaissance d'images au traitement du langage naturel, pour améliorer la convergence et éviter les minima locaux.
Anecdote
Un taux d'apprentissage trop élevé peut faire diverger la perte vers l'infini, tandis qu'un taux trop faible peut faire stagner l'apprentissage sur un palier, rendant la durée d'entraînement impraticablement longue.
Une vieille canalisation résonne différemment d'une neuve. Un tuyau qui a perdu sa souplesse répond à chaque poussée d'eau par un écho sec, qui revient vers la pompe plus vite que dans un système jeune.
Une protéine dans une cellule ne reste pas immobile comme un mannequin en vitrine. Ses atomes tremblent, s'étirent et se plient constamment, un peu comme une corde de guitare tendue qui continue de vibrer après qu'on l'a pincée. Pour comprendre comment une protéine fonctionne, il faut savoir à quel point chaque partie est fermement liée à ses voisines.
Un ingénieur en protéines ressemble à un cuisinier qui essaie de préparer un plat à la fois savoureux, sain et économique. En modifiant un ingrédient, il risque d'en gâcher un autre. Autrefois, les assistants informatiques ne pouvaient évaluer les propriétés des protéines qu'individuellement, sans voir comment elles sont liées entre elles.
Une batterie solaire à pérovskite, c'est comme une jeune athlète : au début, elle donne d'excellents résultats, mais avec l'âge, elle se fatigue. En huit heures, ses performances chutent nettement, et aucune cause visible comme des fissures ou de la poussière n'apparaît. Des scientifiques ont pris une batterie et ont relevé ses mesures à la 0e, 90e, 280e et 480e minute de sa vie.
Un col de montagne relie deux vallées. Dans l'une, la protéine est repliée, dans l'autre, elle est dépliée. Pour passer de l'une à l'autre, il faut franchir la selle, le point le plus haut du chemin. En science des protéines, ce point est appelé état de transition, et la coordonnée qui indique la distance jusqu'à lui est le committor.
Un réseau de neurones prédit l'avenir d'un système — par exemple, comment le plasma va tourbillonner dans un champ magnétique ou comment un visage va changer dans une vidéo. Les erreurs sont inévitables, et plus il regarde loin, plus elles s'accumulent.
Un artiste fait un croquis rapide au fusain – et le visage sur le portrait est déjà reconnaissable. Les astrophysiciens résolvent un problème similaire : le spectre d'une étoile est son portrait individuel, révélant température, composition, gravité.
Cent mille étoiles dans le noyau dense d’un amas globulaire se déplacent comme des billes d’acier dans un flipper géant. Chaque « choc » — une rencontre gravitationnelle entre un couple binaire et une étoile isolée — déclenche une cascade d’événements imprévisibles.
Communiquer avec un satellite, c'est comme essayer d'entendre un murmure dans une tempête : le signal se noie dans les parasites. Des ingénieurs ont créé un algorithme d'IA qui fonctionne directement sur le satellite et qui, avec une consommation d'énergie minimale, identifie les distorsions plus précisément que les méthodes précédentes.
L'intelligence artificielle qui prédit l'acoustique d'une salle fait penser à un étudiant qui triche à l'examen avec une antisèche. Si les points de validation sont les mêmes que ceux de l'entraînement, le modèle se contente de mémoriser l'« empreinte » sonore de chaque position, comme un étudiant qui reconnaît un sujet grâce à un coin de page plié.
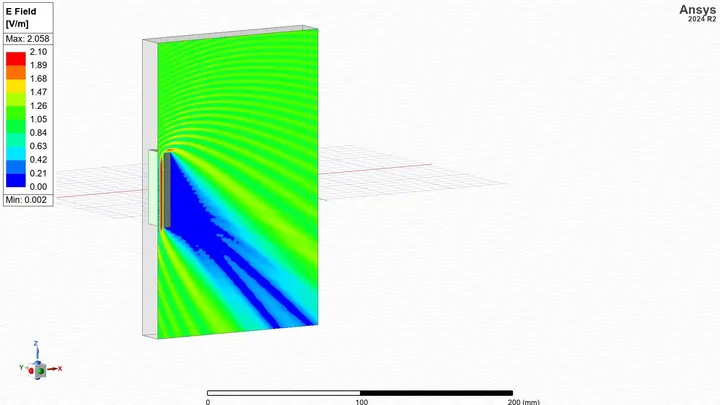
Lorsqu'une onde radio rencontre un bâtiment sur son chemin, elle ne se contente pas de se réfléchir ou d'être absorbée : elle le contourne, un peu comme les vagues de la mer épousent un rocher, laissant derrière lui une eau calme.
Les juges automatiques de la parole sont des algorithmes qui évaluent la prononciation et les émotions. Cependant, ils fonctionnent souvent comme un critique culinaire qui rend son verdict après avoir lu le menu, sans avoir goûté le plat.
Un panneau intelligent pour contrôler les ondes radio qui se déplacent à la vitesse de la lumière fonctionne comme un orchestre : des centaines d'éléments miniatures, véritables « instruments », modifient leur phase (le moment où ils entrent en jeu) sur commande via une tension.
Imaginez un chef expérimenté en heure de pointe : soudain, une cuisinière tombe en panne ou un ingrédient clé vient à manquer. Au lieu de paniquer, il réorganise instantanément la recette — accélère la préparation de certains plats, ralentit d'autres, en redéployant les ressources à la volée. Ce principe d'adaptation dynamique est à la base de la nouvelle génération de réseaux ultra-fiables.
Après qu'une pierre a été jetée, les cercles à la surface de l'eau disparaissent, mais le liquide conserve des vibrations microscopiques. Le moindre souffle – et la ride renaît. Les réseaux de neurones se comportent de manière similaire.
Dans une casserole de soupe, deux thermomètres suffisent pour connaître la température partout — à condition de savoir que la chaleur se propage en cercles depuis le fond. De même en science : à partir de mesures éparses, il faut reconstruire l'image complète du champ thermique.
En général, les algorithmes apprennent à agir dans des conditions prédéfinies, comme l'eau qui coule dans un lit déjà creusé. La nouvelle méthode renverse cette logique : elle permet au système d'apprendre à la fois à agir et à modifier son environnement.
La préparation d'un plat complexe exige une recette claire : d'abord couper, puis faire revenir, ajouter les épices au bon moment. Les transformations chimiques suivent aussi des recettes pas à pas — des mécanismes où les atomes de carbone et d'hydrogène se réarrangent strictement dans l'ordre.
Les assistants logiciels d'écriture de code agissent souvent comme un cuisinier qui, pour faire cuire un seul œuf, relit tout son livre de recettes. Face à une demande de correction minuscule, ils rouvrent des dizaines de fichiers et vérifient des liens connus depuis longtemps. C'est du travail inutile — de l'énergie gaspillée.
Un photographe prend en photo une forêt de nuit et tente de capturer des lucioles. Les flashs sont rares, faibles, et autour, il y a le bruit du vent et des lumières lointaines.
Les calculs quantiques sont une recette avec des ingrédients parfaits, mais le chef nature cuisine à sa façon. Les modèles de machine des atomes apprennent la recette par cœur et prédisent les propriétés de la matière en quelques secondes au lieu de semaines.
Dans toute bande, il y a des trios implicites : trois amis qui sont toujours ensemble. Et il y a des paires qui existent par elles-mêmes. Il s'avère que la mesure dans laquelle les trios « contiennent » les paires détermine la façon dont tout se propage dans le groupe — d'un virus à une nouvelle idée.
Former un modèle aérodynamique précis, c'est un peu comme la cuisine : d'abord, le chef apprend des centaines de recettes pour saisir les principes généraux, puis il perfectionne facilement un plat particulier.
Le noyau d'uranium ressemble à un portefeuille bien rempli, fermé par deux moitiés qui s'emboîtent. Pour qu'il éclate et libère de l'énergie — c'est-à-dire pour que le noyau se divise — il faut franchir une barrière d'énergie. La hauteur de ce seuil détermine si la matière est stable ou prête à se désintégrer à tout moment.
Un ordinateur quantique ressemble à un orchestre où chaque musicien joue sa partition, mais une seule fausse note peut gâcher toute la symphonie. Pour éviter cela, il faut un auditeur qui capte instantanément la fausse note sans gêner les musiciens.
L'apprentissage d'un réseau de neurones ressemble à une descente en luge : il faut la bonne vitesse pour ne pas rester coincé ni sortir de la piste. Dans la méthode populaire d'apprentissage avec moment (comme l'inertie), on prend généralement une valeur constante de 0,9.
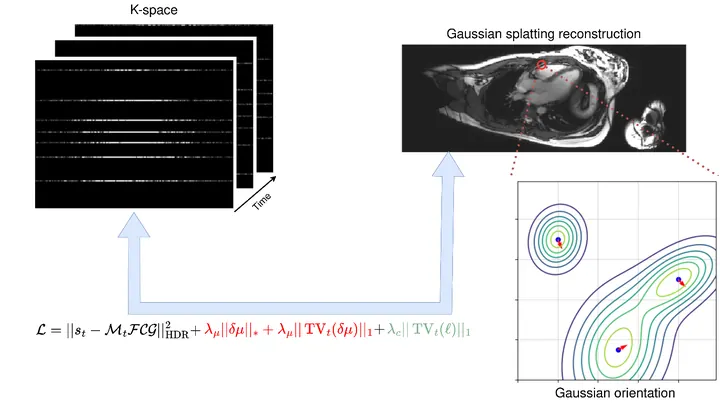
L'IRM, c'est un peu comme un appareil photo qui photographie l'intérieur du corps, mais très lentement. Le patient doit rester immobile plusieurs minutes, pendant que le cœur, lui, continue de battre. Si la personne bouge ou si le rythme s'emballe, l'image devient floue. Les médecins doivent alors recommencer l'examen, perdre du temps et s'énerver.
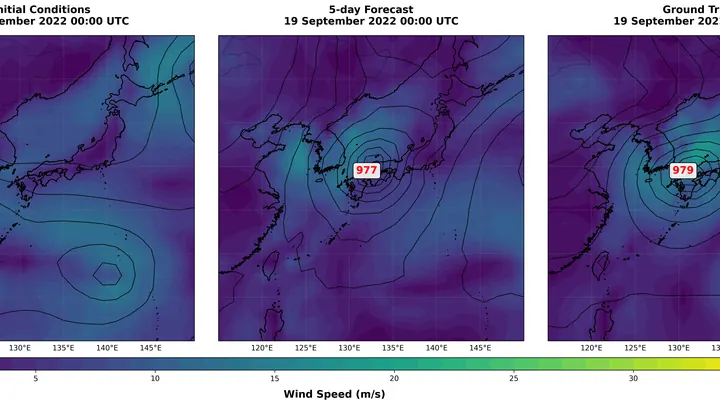
Prévoir la météo, c'est un peu comme essayer de prédire où roulera une pierre sur une pente en connaissant la forme de chaque bosse et la force du vent. On se trompe au départ, et une semaine plus tard, l'erreur s'est transformée en véritable tempête. Avant, pour des prévisions précises, il fallait d'énormes ordinateurs et des calculs de plusieurs jours.
Avant chaque lancement d'un tokamak — l'installation où un gaz surchauffé est maintenu par un champ magnétique — les opérateurs passent des heures à calculer comment le plasma se comportera. L'erreur coûte trop cher : un seul paramètre incorrect peut faire échouer l'expérience.
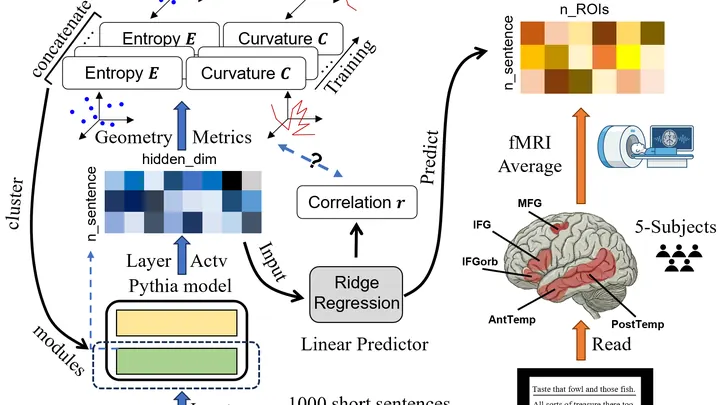
Un modèle de langage est une construction multicouche où chaque couche traite les mots à sa manière. Au début de l'apprentissage, les couches sont chaotiques, mais elles s'organisent progressivement en deux équipes. La première équipe fonctionne simplement : sa géométrie interne s'aplatit, devient moins enchevêtrée. La seconde reste complexe et sinueuse.
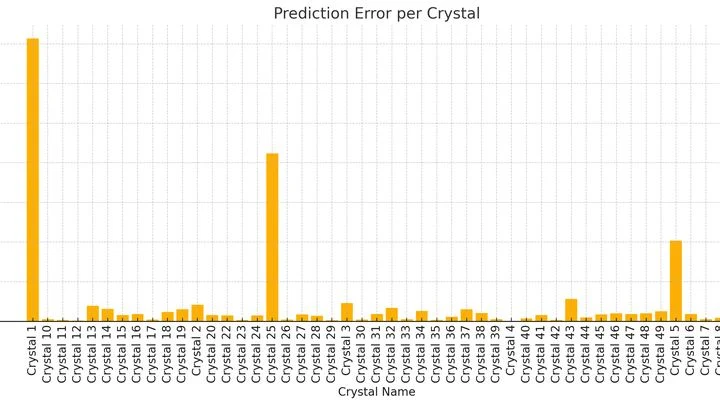
La croissance d'un cristal de germanium ultra-pur évoque la cuisson d'un soufflé capricieux : un léger excès de chaleur ou un grain d'impureté en trop, et tout le lingot ne vaut plus que pour être refondu.
Dans une pièce sombre, sur une table, se trouvent un pointeur laser, un morceau de verre avec du tissu et une caméra de téléphone ordinaire. La lumière traverse l'échantillon, et sur l'image apparaissent non pas des cellules, mais un motif de bandes claires et sombres, comme l'ombre du feuillage sur un mur.
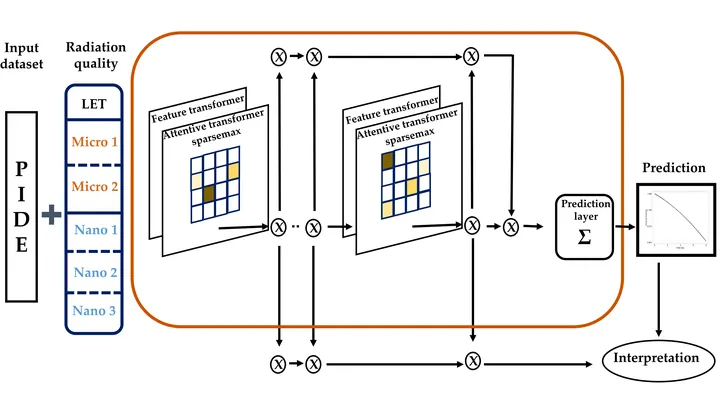
Une cellule prise dans un faisceau de protons ressemble à une ville après un bombardement ciblé : ici des quartiers entiers sont détruits, là seulement des vitres sont brisées. La survie de la ville dépend des bâtiments touchés et de la répartition des impacts.
Affiner un réseau de neurones, c'est un peu comme essayer de modifier un trou noir sans toucher à son horizon des événements : on ne change qu'une petite partie des paramètres.
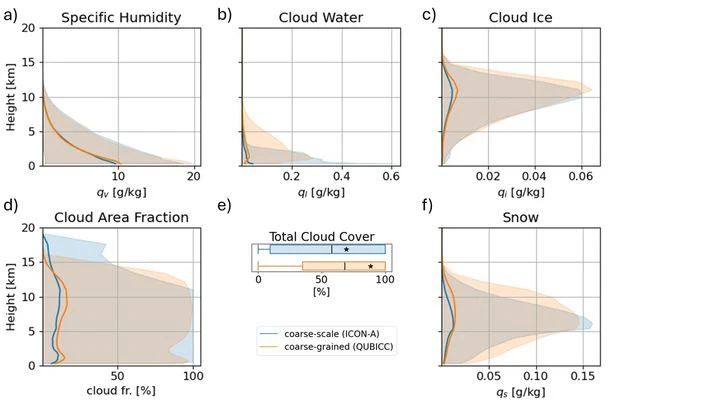
Prédire le climat, c'est un peu comme suivre une recette compliquée : une pincée de trop, et tout est gâché. C'est le cas avec les nuages — petits, mais décisifs. Les modèles climatiques découpent le ciel en cellules de 50 à 100 km et ne voient pas les nuages individuellement.