Un processus gaussien est un outil statistique puissant utilisé pour modéliser des fonctions inconnues en gérant naturellement l'incertitude. Au lieu de fournir une seule meilleure estimation d'une fonction, il propose une distribution de probabilité complète sur les fonctions possibles qui correspondent aux données observées. Cela en fait une pierre angulaire des méthodes bayésiennes non paramétriques, où la complexité du modèle croît avec la quantité de données, plutôt que d'être fixée à l'avance.
Histoire
Le concept a été formalisé dans les années 1940 par le mathématicien Norbert Wiener et d'autres, mais son usage moderne en apprentissage automatique a été popularisé par Carl Edward Rasmussen et Christopher K. I. Williams dans leur livre de 2006.
Comment ça marche
Un processus gaussien définit une distribution sur les fonctions en spécifiant une fonction moyenne et une fonction de covariance (noyau). Le noyau encode des hypothèses sur la régularité, la périodicité ou d'autres propriétés de la fonction. Lorsque des points de données sont observés, le processus met à jour la distribution, produisant une distribution a posteriori qui peut prédire des valeurs en de nouveaux points ainsi qu'une mesure de l'incertitude. Cette incertitude est essentielle : elle se réduit près des données observées et augmente dans les régions inexplorées, permettant une prise de décision fondée sur des principes.
En pratique
Les processus gaussiens sont utilisés en optimisation bayésienne pour le réglage des hyperparamètres, en géostatistique pour l'interpolation de données spatiales (krigeage), et en robotique pour apprendre des politiques de contrôle à partir de données.
Anecdote
Les processus gaussiens peuvent être vus comme une généralisation en dimension infinie de la distribution normale multivariée, où tout ensemble fini de points suit une distribution gaussienne jointe.
L'orchestre joue sans chef. Chaque instrument entre selon son propre calendrier : le violon le lundi, la flûte le mercredi, les timbales le samedi. Les astronomes n'entendent pas la musique, mais des notes isolées, éparpillées sur le calendrier. Le télescope ne voit l'étoile que lorsqu'elle est au-dessus de l'horizon et que le calendrier lui a accordé du temps.
Un cuisinier goûte de minuscules morceaux aux différents bords de l'assiette et tente de reconstituer la recette d'un plat complexe. Chaque morceau ne donne qu'un indice sur la saveur, et en plus les échantillons sont un peu flous – tantôt trop salés, tantôt pas assez sucrés.
En tournant lentement le bouton de réglage d'un vieux poste de radio, vous entendez le son émerger du bruit non pas progressivement, mais par un saut brusque, au moment où l'antenne entre en résonance avec l'onde. C'est à peu près ainsi que se comportent les gènes dans une cellule vivante.
Le cerveau ne se contente pas de réagir au monde – il ne cesse de deviner ce qui va se passer l'instant d'après. Ce principe porte le nom de codage prédictif : les neurones comparent leurs attentes à la réalité et mettent à jour leur représentation interne lorsqu'une erreur survient. Mais comment un système aussi complexe peut-il être organisé dans le tissu vivant du cortex ?
Un bac de sable mouillé. Vous appuyez dans un coin — et l'eau se met en mouvement. Mais comment exactement ? Au lieu d'un cercle régulier, elle peut s'étaler en langues, s'attarder longtemps à certains endroits et filer rapidement à travers d'autres.
Un filigrane délicat sur du papier humide, et une vitre embuée devant les yeux. C'est à peu près à cela que ressemble la lecture des états quantiques de la lumière : les fragiles motifs de photons sont déformés par les pertes, et les détecteurs ne capturent qu'une petite partie du signal.
Une molécule ressemble à un couple de danseurs : les électrons virevoltent rapidement, tandis que les noyaux lourds se déplacent plus lentement. Mais parfois, les partenaires perdent le rythme — un électron saute entre les états, et la danse change. C'est ce qu'on appelle une transition non adiabatique.
Imaginez un vieux théâtre dans un brouillard humide. Sur scène, une poignée d'acteurs, mais un seul est saisi par le faisceau du projecteur, figé dans une tache lumineuse. Les autres tourbillonnent dans la pénombre, prêts à s'évanouir à tout moment.
Le microlentillage gravitationnel est un effet cosmique fascinant, prédit par Einstein et développé par Zwicky. Un corps massif, passant entre nous et une étoile lointaine, courbe sa lumière comme une lentille, créant des amplifications et distorsions caractéristiques.
Les modèles statistiques sont une tentative de tendre une toile mathématique idéale sur le paysage accidenté des données. Lorsque le modèle résiste, il émet une tension, mais nous avons pris l'habitude de l'ignorer. Les chercheurs passent des heures à scruter les graphiques de résidus, essayant de deviner où le modèle « craque ». Squealer traduit cette résistance en son.
L'Univers n'est pas silencieux : il est parcouru d'un bourdonnement continu d'ondes gravitationnelles. Dans une décennie, l'observatoire spatial LISA accordera ses « oreilles » sur la gamme des millihertz, et notre Galaxie s'avérera être la source la plus riche — des dizaines de milliers de paires de naines…
Les observatoires d'ondes gravitationnelles évoquent une oreille attentive aux grondements lointains des catastrophes cosmiques. Pour percevoir le faible chuchotement des trous noirs qui fusionnent, les détecteurs d'ondes gravitationnelles utilisent une lumière spécialement préparée, appelée vide comprimé.
Les réseaux de neurones génératifs qui créent des images s'appuient généralement sur le hasard numérique. Mais une équipe de chercheurs a construit un système où le hasard naît non pas dans le code, mais dans une minuscule cavité optique contenant un colorant organique.
Une poignée de sable tombe sur une table — et chaque grain roule vers le bas jusqu'à ce qu'il se fige dans un creux. C'est ainsi que fonctionne le potentiel : la surface de la table indique aux particules où aller. Mais dans une rivière avec des tourbillons, il n'y a pas un seul creux vers lequel tout converge. L'eau tourne, revient, serpente.
Deux points sur la surface d'un ballon — voilà tous les repères dont on dispose quand on essaie de comprendre comment il se gonfle. C'est à peu près ainsi que les cosmologistes reconstruisent l'histoire de l'expansion de l'univers.
L'appareil photo prend une image, mais le capteur bruit, l'optique floute, et une partie des pixels est surexposée. Reconstituer l'image d'origine, c'est un peu comme deviner une mélodie sur un disque rayé : les possibilités sont nombreuses, et l'on ne sait pas laquelle est la bonne.
Plongez votre doigt dans l'eau une seule fois — et, à partir de cette unique sensation, essayez de deviner sa température. Dans le monde quantique, de telles mesures uniques sont monnaie courante, sauf qu'il faut deviner des paramètres invisibles : par exemple, la force de compression d'un faisceau laser.
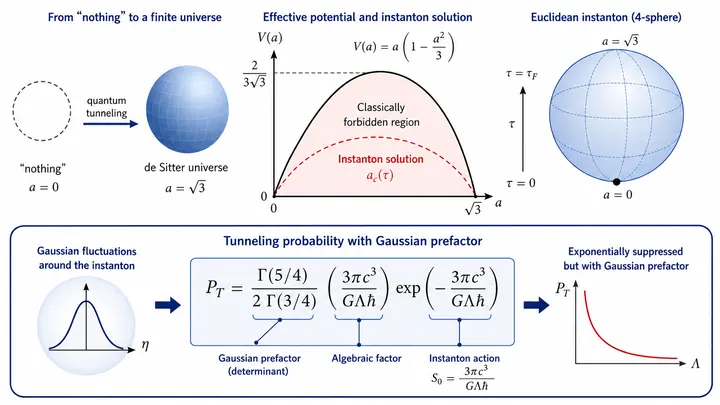
Le néant quantique ressemble à de l'eau dans une casserole avant l'ébullition. De temps en temps, une bulle y gonfle spontanément – non pas de vapeur, mais d'un univers entier. Cette bulle ne s'effondre pas ; elle se dilate en un espace-temps, déclenchant son propre Big Bang. La question est de savoir à quelle fréquence cela se produit.
La main repose sur la table, et deux courtes vibrations arrivent au poignet, l'une après l'autre. Il faut dire laquelle est la plus forte. La tâche semble simple, mais la réponse dépend de la vibration qui vient en premier. Si la première est faible et la seconde forte, la différence paraît plus grande que lorsqu'on les inverse.
Un album contenant des centaines de photos de famille renferme de nombreuses histoires. Si l'on examine chaque cliché séparément, on pourrait facilement croire que l'oncle est un véritable géant : ce jour-là, il se tenait sur une marche plus haute que les autres. Mais en feuilletant tout l'album, on comprend vite que sa taille est tout à fait ordinaire, c'est juste que la marche apparaît sur quelques photos.
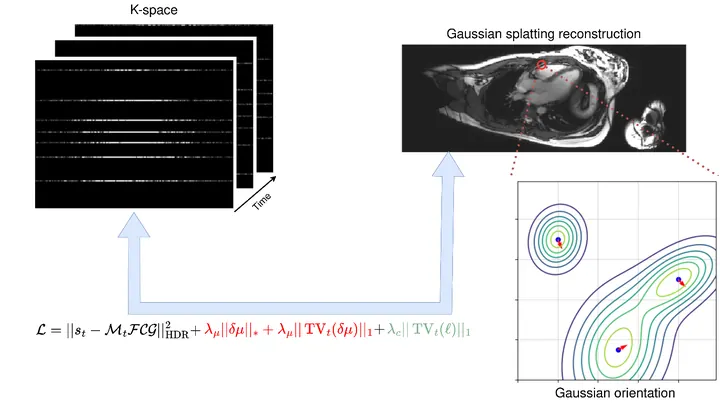
L'IRM, c'est un peu comme un appareil photo qui photographie l'intérieur du corps, mais très lentement. Le patient doit rester immobile plusieurs minutes, pendant que le cœur, lui, continue de battre. Si la personne bouge ou si le rythme s'emballe, l'image devient floue. Les médecins doivent alors recommencer l'examen, perdre du temps et s'énerver.
Dans un laboratoire, on mesure un signal très faible — par exemple, une infime variation du champ magnétique. L'instrument vibre à cause des voitures qui passent, de la respiration de l'expérimentateur, de l'échauffement des fils. Ce bruit technique ne peut pas être éliminé complètement, et il fixe une limite à la précision.
La lumière née au moment du Big Bang a voyagé vers nous pendant près de 14 milliards d'années. Mais en chemin, elle a traversé les champs gravitationnels des galaxies et des amas de matière noire, qui ont courbé ses rayons.
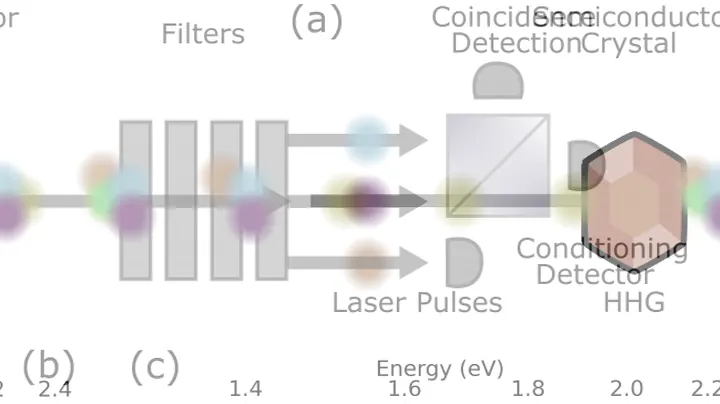
Un laser puissant frappe un semi-conducteur, et celui-ci répond par une lumière à de nombreuses fréquences — telle une corde qui vibre en un chœur d'harmoniques. Auparavant, on utilisait cela en spectroscopie pour observer des processus ultrarapides.
Les étoiles situées en périphérie des galaxies tournent plus vite que ne le prévoient les lois de la physique si l'on ne compte que la matière visible. Ce paradoxe a été mis en évidence au XXe siècle par Vera Rubin et Fritz Zwicky.
Le champ magnétique à mesurer ressemble à une mélodie jouée dans une salle bruyante. Le capteur quantique est un microphone capable de capter les notes les plus faibles, mais il n'entend pas que la musique : des bruissements, des grincements, la respiration des voisins. Tout cela se mêle au signal et gâche l'enregistrement.
Une étoile à neutrons est une boule de la taille d'une ville, mais elle pèse autant qu'une fois et demie le Soleil. À l'intérieur d'une telle boule, la matière est si comprimée qu'une cuillère à café pèserait des milliards de tonnes. Mais de quoi est exactement faite cette matière, les physiciens ne le savent pas encore.
L'idée de la téléportation quantique a été proposée par Charles Bennett, puis réalisée par Anton Zeilinger. Elle repose sur l'intrication — deux particules synchrones, comme deux feuilles qui reproduisent instantanément le même dessin.
Une impulsion laser d'une durée d'une nanoseconde et demie frappe un cristal non linéaire, et naît un flux de lumière comprimée. C'est ainsi que commence l'expérience sur le processeur quantique « Jiuzhang 4.0 » en Chine.
Un interprète assiste à une réunion où l'on parle une langue inconnue. Il ne connaît pas les mots, mais il remarque que lorsqu'une personne élève la voix, une autre se met à hocher la tête une minute plus tard. Au début, cela semble être le fait du hasard, mais avec le temps, l'interprète apprend à comprendre qui influence qui.
Des lunettes à verres plans montrent un monde symétrique : la montée et la descente, le chaud et le froid paraissent identiques. Pendant des décennies, les climatologues ont observé El Niño à travers de telles lunettes, les modèles inverses linéaires.
À une conférence, l'interprète entend le bruit de la salle, mais continue de traduire. Il ne répète pas chaque mot, il trouve une langue intermédiaire où les phrases complexes deviennent simples, sans perdre le sens.