La tasa de aprendizaje es un hiperparámetro en el aprendizaje automático que controla el tamaño del paso que se da al actualizar los parámetros de un modelo durante el entrenamiento. Determina la rapidez con la que disminuye el error (pérdida) del modelo a medida que itera sobre los datos. Una tasa de aprendizaje alta hace que el modelo aprenda rápido, pero corre el riesgo de sobrepasar la solución óptima; una tasa baja hace que el aprendizaje sea lento pero más estable. La tasa de aprendizaje es uno de los ajustes más críticos en el entrenamiento de redes neuronales, ya que influye directamente en la convergencia y en el rendimiento final.
Historia
El concepto de tasa de aprendizaje surgió con el desarrollo de la optimización basada en gradientes en las décadas de 1950 y 1960, particularmente en el contexto del aprendizaje del perceptrón y las primeras redes neuronales. Se convirtió en un término estándar en la década de 1980 con la retropropagación.
Cómo funciona
Durante el entrenamiento, el modelo calcula el gradiente de la función de pérdida con respecto a sus parámetros. Luego, los parámetros se actualizan restando el gradiente multiplicado por la tasa de aprendizaje. Esta es la regla estándar de actualización del descenso de gradiente. La tasa de aprendizaje escala el paso del gradiente: un valor más grande implica saltos más grandes en el espacio de parámetros, mientras que un valor más pequeño implica ajustes más finos. Los optimizadores modernos como Adam ajustan adaptativamente la tasa de aprendizaje por parámetro, pero la tasa base aún debe ser establecida por el profesional.
En la práctica
La programación de la tasa de aprendizaje —ajustar la tasa durante el entrenamiento— se utiliza en prácticamente todas las aplicaciones de aprendizaje profundo, desde el reconocimiento de imágenes hasta el procesamiento del lenguaje natural, para mejorar la convergencia y evitar mínimos locales.
Dato curioso
Una tasa de aprendizaje demasiado alta puede hacer que la pérdida diverja hasta el infinito, mientras que una demasiado baja puede quedar atrapada en una meseta, haciendo que el tiempo de entrenamiento sea impracticablemente largo.
Una tubería vieja suena distinto que una nueva. El tubo que ha perdido flexibilidad responde a cada empujón del agua con un eco seco, que vuelve a la bomba más rápido que en una instalación joven. Algo parecido ocurre con nuestras arterias: con los años sus paredes se endurecen, y la onda del pulso, al llegar a los vasos pequeños, se refleja de vuelta hacia el corazón casi sin demora.
Una proteína en la célula no permanece inmóvil, como un maniquí en un escaparate. Sus átomos tiemblan, se estiran y se doblan constantemente, como una cuerda de guitarra tensa que sigue sonando después de que la rozas con el dedo. Para entender cómo funciona una proteína, hay que saber con qué firmeza cada parte se aferra a sus vecinas.
Un ingeniero de proteínas se parece a un cocinero que intenta hacer un plato que sea a la vez sabroso, saludable y barato. Al cambiar un ingrediente, corre el riesgo de estropear otro. Antes, los asistentes informáticos solo podían evaluar las propiedades de las proteínas por separado, sin ver cómo se relacionan entre sí.
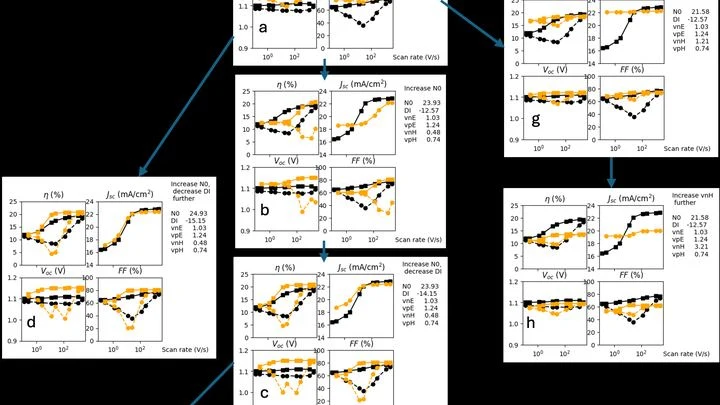
Una batería solar de perovskita es como una atleta joven: al principio rinde excelente, pero con la edad se cansa. En ocho horas, sus características caen notablemente, y no hay causas visibles como grietas o polvo. Los científicos tomaron una batería y registraron lecturas a los 0, 90, 280 y 480 minutos de vida.
Un puerto de montaña conecta dos valles. En uno, la proteína está plegada; en el otro, desplegada. Para pasar de uno a otro, hay que cruzar la silla, el punto más alto del camino. En la ciencia de las proteínas, este punto se llama estado de transición, y la coordenada que indica la distancia hasta él se denomina commitador.
La red neuronal predice el futuro de un sistema, por ejemplo, cómo se arremolina el plasma en un campo magnético o cómo cambia un rostro en un video. Los errores son inevitables, y cuanto más lejos mira hacia adelante, más se acumulan. En el momento de la operación es imposible contrastar con la respuesta correcta: simplemente no existe.
Un artista hace un boceto rápido al carboncillo — y el rostro en el retrato ya es reconocible. Los astrofísicos se enfrentan a una tarea similar: el espectro de una estrella es su retrato individual, que revela temperatura, composición, gravedad superficial.
Cien mil estrellas en el denso núcleo de un cúmulo globular se mueven como bolas de acero en una gigantesca máquina de pinball. Cada «empujón» —un encuentro gravitacional entre un sistema binario y una estrella solitaria— desencadena una cascada de eventos impredecibles.
La comunicación con un satélite es como intentar oír un susurro en medio de una tormenta: la señal se ahoga en interferencias. Unos ingenieros han creado un algoritmo de IA que funciona directamente en el satélite y, con un consumo mínimo de energía, reconoce las distorsiones con más precisión que los métodos anteriores.
La inteligencia artificial que predice la acústica de una sala se parece a un estudiante en un examen con una chuleta. Si los puntos de prueba son los mismos que los de entrenamiento, el modelo simplemente memoriza la 'huella sonora' de cada posición, como un estudiante que reconoce el examen por una esquina doblada.
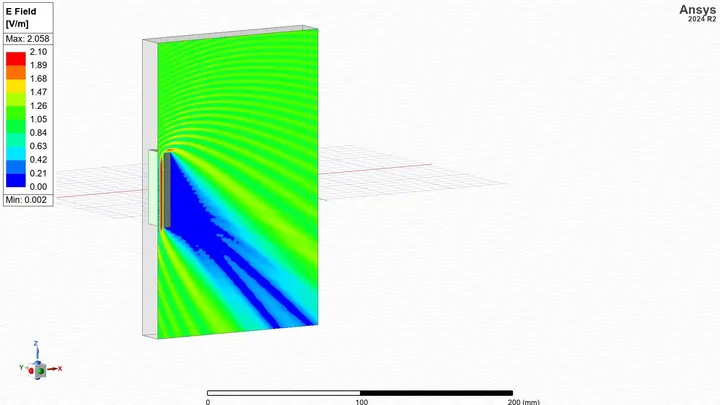
Cuando una onda de radio encuentra un edificio en su camino, no solo se refleja o se absorbe: lo rodea, igual que las olas del mar bordean una roca dejando agua tranquila detrás. En radiofísica, este fenómeno crea una sombra de radio: un patrón complejo de zonas de refuerzo y atenuación de la señal que los científicos llaman retrato de radio.
Los jueces automáticos del habla son algoritmos que evalúan la pronunciación y las emociones. Sin embargo, a menudo funcionan como un crítico culinario que emite un veredicto tras leer el menú, pero sin probar el plato.
Un panel inteligente para controlar las ondas de radio, que viajan a la velocidad de la luz, funciona como una orquesta: cientos de elementos diminutos, los «instrumentos», cambian la fase (el momento de entrada) según las órdenes del voltaje. De esta manera, toda la superficie dirige el haz hacia la dirección deseada, como el sonido en una sala.
Imagina a un chef experimentado en hora punta: de repente falla una placa o se acaba un ingrediente clave. En lugar de entrar en pánico, reconfigura la receta al instante: acelera la preparación de unos platos, ralentiza otros, reasignando recursos sobre la marcha. Este principio de adaptación dinámica es la base de la nueva generación de redes ultra fiables.
Tras lanzar una piedra, los círculos en el agua desaparecen, pero el líquido conserva vibraciones microscópicas. El más leve soplo y las ondas reaparecen. Las redes neuronales se comportan de forma similar. Cuando las señales eléctricas se calman, su memoria perdura en los puntos de contacto: las sinapsis.
En una olla de sopa, bastan dos termómetros para saber la temperatura en todas partes, si se sabe que el calor sube en círculos desde el fondo. Así ocurre en la ciencia: a partir de pocas mediciones hay que reconstruir la imagen completa del campo térmico.
Tradicionalmente, los algoritmos de aprendizaje automático operan en un entorno estático, como agua que fluye por un cauce ya trazado sin cambiar su forma. El nuevo método invierte este paradigma: permite que el agente aprenda acciones y, al mismo tiempo, modifique el entorno en el que existe.
Preparar un plato complejo exige una receta clara: primero cortar, luego sofreír, añadir las especias en el momento justo. Las transformaciones químicas también siguen recetas paso a paso, mecanismos donde los átomos de carbono e hidrógeno se reorganizan en un orden estricto.
Los asistentes de programación suelen actuar como un cocinero que, para hervir un solo huevo, relee el libro de cocina entero. Al recibir la tarea de hacer una pequeña corrección, vuelven a abrir decenas de archivos y verifican vínculos ya conocidos. Esto es trabajo innecesario: energía que se desperdicia.
Un fotógrafo fotografía un bosque nocturno e intenta capturar luciérnagas en el encuadre. Los destellos son raros, débiles, y alrededor hay ruido del viento y luces lejanas. Así funciona aproximadamente el enorme detector Hyper-Kamiokande en Japón: captura neutrinos —partículas casi intangibles— mediante diminutos destellos de luz en 260 mil toneladas de agua.
Los cálculos cuánticos son una receta con ingredientes perfectos, pero el chef naturaleza cocina a su manera. Los modelos de máquina de los átomos aprenden la receta de memoria y predicen las propiedades de la materia en segundos en lugar de semanas.
En cualquier grupo hay tríos no escritos: tres amigos que siempre están juntos. Y hay parejas que existen por su cuenta. Resulta que de cuánto "contienen" los tríos a las parejas depende cómo se propaga por el grupo todo, desde un virus hasta una idea nueva.
Los científicos introdujeron una medida que llamaron coeficiente de anidamiento.
Entrenar un modelo aerodinámico preciso se asemeja al arte culinario: primero el chef domina cientos de recetas para captar los principios generales, y luego perfecciona fácilmente un plato concreto. Los ingenieros crearon AeroTransformer y le «alimentaron» con 30 mil formas diferentes de alas: toda una galaxia de ideas culinarias galaxia.
El núcleo de uranio se asemeja a una cartera apretada, cerrada con dos mitades. Para que reviente y libere energía —es decir, para que el núcleo se divida— hay que superar una barrera energética. La altura de ese umbral determina si la materia es estable o está lista para desintegrarse en cualquier momento.
Una computadora cuántica es como una orquesta donde cada músico toca su parte, pero una sola nota falsa puede arruinar toda la sinfonía. Para evitar esto, se necesita un oyente que capte la desafinación al instante sin estorbar la interpretación.
Entrenar una red neuronal es como bajar una montaña en trineo: necesitas la velocidad adecuada para no quedarte atascado ni salirte de la pista. En el popular método de entrenamiento con momento (como la inercia), normalmente se usa un valor constante de 0,9.
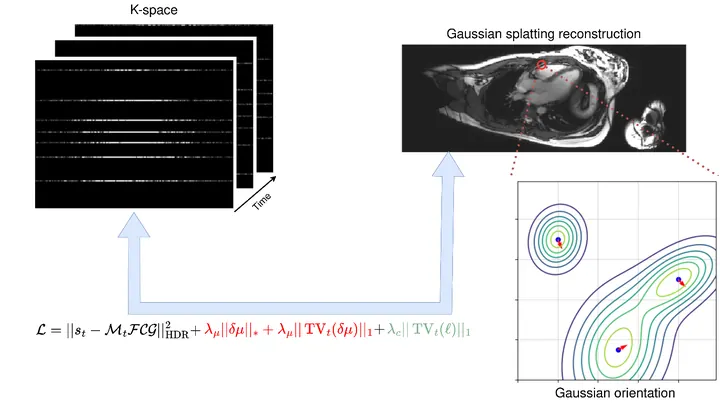
Un escáner de resonancia magnética es como una cámara que toma fotografías del interior del cuerpo, pero muy lentamente. El paciente debe permanecer inmóvil durante varios minutos, mientras el corazón sigue latiendo. Si la persona se mueve o el ritmo se altera, la imagen se ve borrosa. Los médicos tienen que repetir el escaneo, perdiendo tiempo y paciencia.
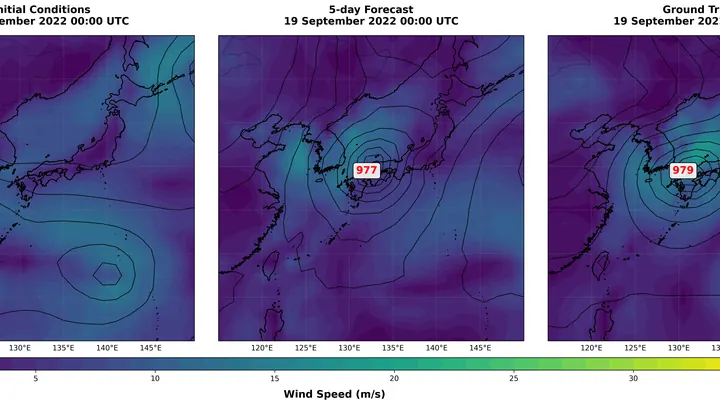
Pronosticar el tiempo es como intentar predecir hacia dónde rodará una piedra por una ladera, conociendo la forma de cada bulto y la fuerza del viento. Si te equivocas al principio, en una semana el error se convierte en toda una tormenta. Antes, para hacer pronósticos precisos se necesitaban enormes computadoras y cálculos de varios días.
Antes de cada arranque de un tokamak —el dispositivo donde un gas sobrecalentado se mantiene confinado por un campo magnético—, los operadores pasan horas calculando cómo se comportará el plasma. Equivocarse es demasiado caro: un solo parámetro incorrecto puede arruinar el experimento.
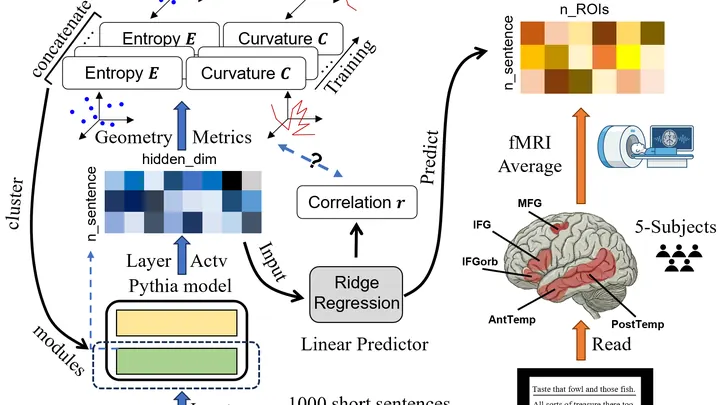
Un modelo de lenguaje es una construcción de múltiples capas, donde cada capa procesa las palabras a su manera. Al inicio del entrenamiento, las capas son caóticas, pero poco a poco se organizan en dos equipos. El primer equipo trabaja de forma simple: su geometría interna se suaviza y se vuelve menos enredada. El segundo permanece complejo y sinuoso.
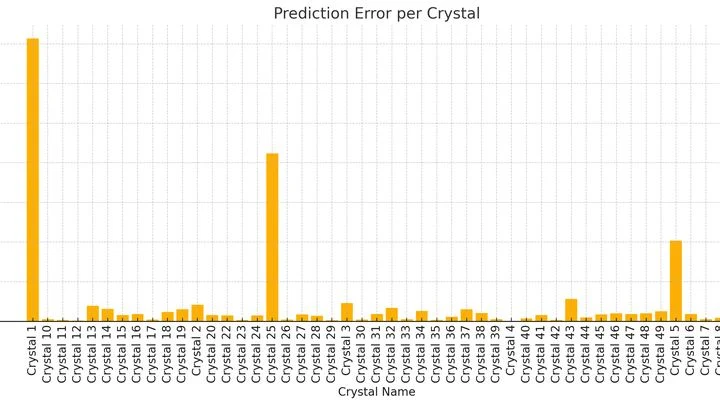
El crecimiento de un cristal de germanio ultrapuro se parece a hornear un soufflé caprichoso: el más mínimo sobrecalentamiento o una pizca extra de impureza, y todo el lingote solo sirve para refundirlo. Estos cristales son el corazón de los detectores que captan eventos rarísimos: desde materia oscura hasta doble desintegración beta.
En una habitación oscura, sobre la mesa hay un puntero láser, un trozo de vidrio con tejido y una cámara normal de teléfono. La luz atraviesa la muestra y en la imagen no aparecen células, sino un patrón de bandas claras y oscuras, como la sombra del follaje en una pared.
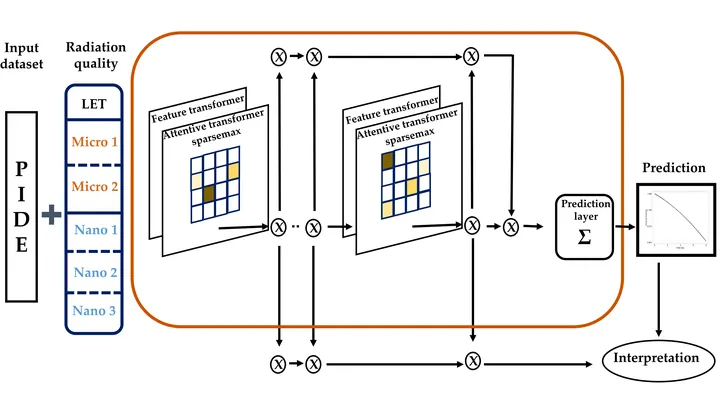
Una célula alcanzada por un haz de protones se parece a una ciudad tras un bombardeo selectivo: en algunos lugares hay manzanas enteras destruidas, y en otros solo cristales rotos. Que la ciudad sobreviva depende de qué edificios concretos hayan sido afectados y de cómo se distribuyeron los impactos.
Reentrenar una red neuronal es como intentar cambiar un agujero negro sin tocar su horizonte de eventos: solo se modifica una pequeña parte de los parámetros. Los investigadores miraron en su interior y vieron patrones sorprendentes — fuertes conexiones entre fragmentos del modelo, como en el entrelazamiento cuántico.
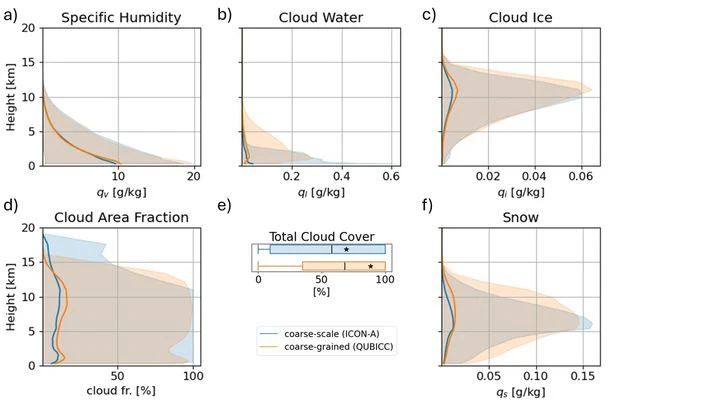
El pronóstico del clima se parece a una receta compleja: una pizca equivocada y todo el plato se arruina. Así pasa con las nubes: pequeñas pero decisivas. Los modelos climáticos dividen el cielo en celdas de 50 a 100 km y no ven las nubes individuales. Es como echar pimienta a puñados cuando la receta pide una pizca.