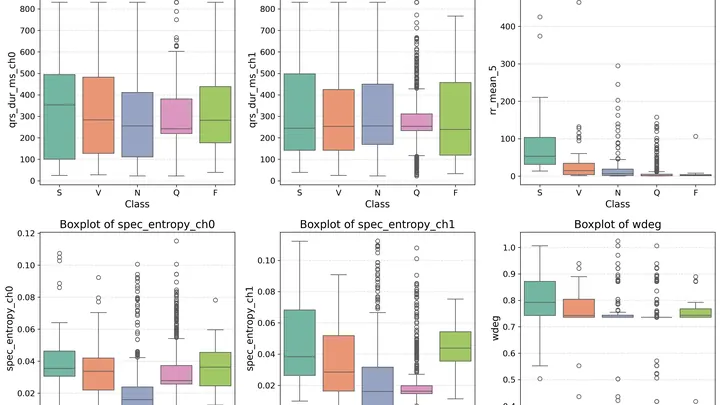
L'importance des caractéristiques désigne les techniques qui attribuent un score aux variables d'entrée selon leur utilité pour prédire une variable cible au sein d'un modèle entraîné. Cela aide à interpréter quelles variables sont les plus influentes dans les décisions du modèle, facilitant la compréhension du modèle, la sélection des caractéristiques et la compréhension du domaine.
Histoire
Le concept a été utilisé de manière informelle pendant des décennies, mais des méthodes formalisées comme l'importance de Gini ont été introduites avec les forêts aléatoires au début des années 2000 par Leo Breiman et Adele Cutler. L'importance par permutation a également été popularisée à cette époque.
Comment ça marche
Les méthodes varient selon le type de modèle. Pour les modèles basés sur les arbres (par exemple, les forêts aléatoires, le boosting de gradient), l'importance est souvent calculée en fonction de la diminution de l'impureté (par exemple, l'impureté de Gini ou l'entropie) apportée par chaque caractéristique à travers toutes les divisions. Pour les modèles linéaires, l'amplitude des coefficients peut servir de proxy. Des méthodes agnostiques au modèle, comme l'importance par permutation, mesurent la baisse de performance du modèle lorsque les valeurs d'une caractéristique sont mélangées aléatoirement, rompant ainsi son association avec la cible.
En pratique
Utilisée dans des domaines comme la génomique pour identifier les gènes les plus prédictifs d'une maladie, en marketing pour comprendre les principaux moteurs clients, et dans le débogage de modèles pour s'assurer que le modèle s'appuie sur des caractéristiques sensées plutôt que sur des corrélations fallacieuses.
Anecdote
Les scores d'importance des caractéristiques sont relatifs et peuvent être trompeurs si les caractéristiques sont corrélées ; une caractéristique réellement importante peut obtenir un score faible si une caractéristique corrélée est déjà utilisée dans le modèle.
Deux coureurs s'élancent sur une piste dont la pente varie. L'un part plus tôt, l'autre plus tard, et l'arbitre mesure leurs vitesses sans connaître la différence de départ. C'est la même chose avec les variants du virus : les données arrivent avec des retards, et si ces retards ne sont pas identiques, l'estimation de l'avantage compétitif peut être grossièrement erronée.
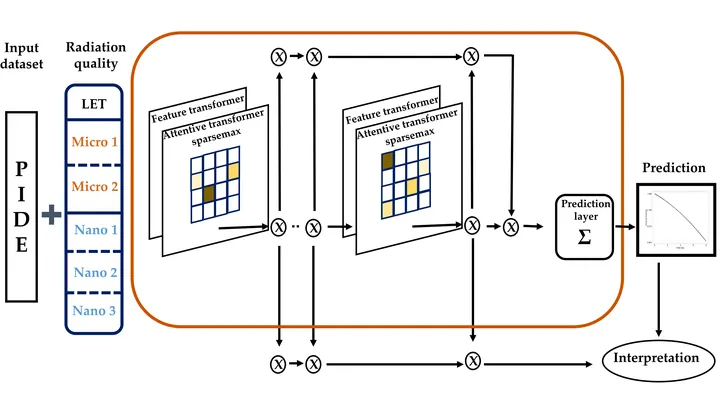
La nuit, dans la chambre, un orchestre joue, et le soliste, c'est la respiration. Sous le drap, un tapis de 512 capteurs capte les moindres mouvements du corps. Lorsque la respiration s'arrête pendant dix secondes, l'orchestre se tait. Le défi est d'entendre ce silence.
Jusqu'ici, on ne savait pas quelles notes de cette musique étaient les plus importantes.
Un billet de banque collé sur la ligne d'arrivée, et la main file plus vite. Au laboratoire, ce billet a été remplacé par une pièce de 50 pence, et la ligne d'arrivée par une cible à l'écran. Les chercheurs ont invité 28 jeunes et 28 personnes âgées, les ont installés devant la poignée d'un robot et leur ont demandé de conduire un curseur vers la cible.
Sur un bulletin scolaire, chaque note parle d'elle-même, mais pour comprendre comment un élève s'en sort globalement, il faut regarder l'ensemble du bulletin. Pour les médicaments qui agissent sur le cerveau, un tel bulletin a longtemps fait défaut.
On lance une pièce pour prendre une décision. On reste immobile — la pièce tombe sur pile. On fait quelques pas — et on relance. On pourrait penser que la marche n'influence pas la pièce. Mais que se passerait-il si la promenade elle-même modifiait la fréquence à laquelle on décide de simplement répéter le lancer précédent ?
C'est exactement ce que les chercheurs ont testé.
Le magnétoencéphalographe, un appareil qui ressemble à un casque muni de centaines de capteurs, capte les faibles champs magnétiques produits par les neurones en activité. Lorsqu'une personne écoute de la parole, ces signaux renferment des empreintes des mots entendus.
Un artiste fait un croquis rapide au fusain – et le visage sur le portrait est déjà reconnaissable. Les astrophysiciens résolvent un problème similaire : le spectre d'une étoile est son portrait individuel, révélant température, composition, gravité.
En plein combat, un pilote doit comprendre instantanément ce qu'est un objet et quelles sont ses intentions. Les systèmes conventionnels attendent des données radar complètes – c'est comme un gardien qui ne réagit qu'après le tir. Le nouvel algorithme, lui, agit comme un gardien chevronné : dès les premiers mouvements de l'attaquant, il anticipe la manœuvre de la cible.
Les signaux radio dans une pièce se comportent comme le son dans une salle de concert : en se réfléchissant sur les murs et les objets, ils créent une empreinte unique — la mélodie silencieuse de chaque lieu. Le téléphone, telle une oreille attentive, capte cette mélodie dans le bruit et les distorsions. Il mémorise quel accord correspond au coin du canapé, et lequel à l'embrasure de la porte.
L'intelligence artificielle qui prédit l'acoustique d'une salle fait penser à un étudiant qui triche à l'examen avec une antisèche. Si les points de validation sont les mêmes que ceux de l'entraînement, le modèle se contente de mémoriser l'« empreinte » sonore de chaque position, comme un étudiant qui reconnaît un sujet grâce à un coin de page plié.
Les juges automatiques de la parole sont des algorithmes qui évaluent la prononciation et les émotions. Cependant, ils fonctionnent souvent comme un critique culinaire qui rend son verdict après avoir lu le menu, sans avoir goûté le plat.
Un panneau intelligent pour contrôler les ondes radio qui se déplacent à la vitesse de la lumière fonctionne comme un orchestre : des centaines d'éléments miniatures, véritables « instruments », modifient leur phase (le moment où ils entrent en jeu) sur commande via une tension.
Les aides auditives traditionnelles ressemblent à un cuisinier qui prépare une recette à l'aveugle. Elles analysent le désordre sonore entropique capté par le microphone et, sur cette base, amplifient la parole. Dans un café bruyant, cette approche se trompe souvent.
En général, les algorithmes apprennent à agir dans des conditions prédéfinies, comme l'eau qui coule dans un lit déjà creusé. La nouvelle méthode renverse cette logique : elle permet au système d'apprendre à la fois à agir et à modifier son environnement.
Des chercheurs ont pris 16 activités quotidiennes — de la vaisselle aux squats — et ont décomposé les mouvements en composantes élémentaires, un peu comme un spectroscope décompose la lumière en spectre. En comparant trois approches, ils ont trouvé une clé inattendue pour la reconnaissance : une simple image moyenne suffit.
Un neurone ressemble à un instrument de musique complexe. Pour comprendre comment il réagit à une sollicitation, il fallait autrefois se connecter directement à chaque corde — une procédure délicate, lente et réservée à quelques cellules isolées.
À l'écran, le résultat d'une simulation complexe : deux planètes entrent en collision, une onde de choc se propage. Quelques clics dans l'éditeur – et les ombres dures s'adoucissent, le bruit s'estompe, l'arrière-plan s'assombrit. Cette retouche numérique (modification d'une image pour améliorer son apparence) fait depuis longtemps partie de l'arsenal des scientifiques.
Chaque semaine, les médecins posent des millions de questions aux assistants IA au chevet des patients. Mais ces outils sont généralement testés sur des exercices d'examen, pas sur ce qui est demandé dans une vraie clinique. Un groupe de chercheurs a décidé d'y remédier.
Les éruptions solaires sont de puissantes explosions sur le soleil, capables de mettre hors service des satellites et de priver des villes entières d'électricité. Leur prédiction est compliquée par l'enchevêtrement des champs magnétiques dans les taches solaires.
Quand on entreprend des travaux, on n'achète pas la peinture au jugé, mais en fonction de la surface des murs. En science, le calcul du nombre d'échantillons est une estimation similaire, mais les enjeux sont plus élevés. En dessous du compte, l'étude devient une loterie : on peut passer à côté d'un effet réel, ou prendre du bruit pour une découverte.
Une bouilloire qui bout avec son couvercle fermé ne montre pas l'ébullition, mais le son et les vibrations trahissent la puissance de chauffe de l'eau.
Un spectre, c'est un peu comme une photographie de la structure interne d'une substance, prise avec de la lumière. Lorsque le faisceau traverse l'échantillon ou s'y réfléchit, les molécules laissent sur ce cliché des bandes sombres caractéristiques : les pics. Mais si la photo est surexposée ou voilée de gris, distinguer les détails devient presque impossible.
Vous goûtez un plat au restaurant, mais vous n'avez pas vu le menu. Vous posez des questions au serveur — trop salé ? avec quelles épices ? — et à partir des réponses, vous essayez de deviner quel chef l'a préparé.
Un paysage tacheté n'est pas qu'une image de manuel de géographie. Pour les microbes, les cellules ou les animaux, le monde est fait de pièces : ici il fait plus chaud, là il y a plus de nourriture, et derrière ce rocher, c'est presque un poison. Quand, dans cette mosaïque, apparaît un mutant doté d'une nouvelle propriété, son sort dépend du « morceau » sur lequel il est tombé.
Les ingénieurs qui améliorent les réseaux de neurones agissent comme des sélectionneurs : ils essaient une variante, observent le résultat, conservent la meilleure. Ils ont rassemblé 935 de ces essais issus de 161 articles et mesuré à quelle fréquence une modification de code s'avère bénéfique, nuisible ou sans effet.
Le vieillissement du cerveau ressemble à l'usure d'un pont : les fissures apparaissent sans qu'on les remarque, mais si l'on renforce les piliers à temps, la structure tient plus longtemps. Ces piliers se sont révélés être trois choses ordinaires : la force de la poignée de main, la capacité à bouger longtemps sans essoufflement et la capacité pulmonaire.
Un réseau de neurones médical classique voit le patient comme un point sur une carte : il y a la taille, la tension, la prise de sang – et le modèle pose une étiquette unique « sain » ou « malade ». Mais dans un vrai hôpital, la carte est toujours en lambeaux. Une analyse faite lundi, une autre un mois plus tard, et le scanner est d'une autre marque. Un point sur une telle carte, c'est se mentir.
La démarche n'est pas qu'un moyen de se rendre d'un point A à un point B. Chaque pas, chaque balancement de bras, chaque inclinaison du buste est comme une signature que le corps laisse dans l'espace. Autrefois, les médecins remarquaient que la maladie modifiait la démarche, mais ils n'y voyaient qu'un symptôme d'un problème précis : si vous boitez, c'est que votre jambe vous fait mal.
Les généticiens lisent l'ADN comme une longue liste de lettres. Ils en tirent un « score de risque polygénique » — un nombre qui indique si une personne a un risque de maladie, comme le diabète, supérieur ou inférieur à la moyenne.
Une goutte de pluie qui tombe sur le sol frappe avec une certaine force. Mais que se passe-t-il si la goutte n'est pas ronde, mais allongée comme un cigare, ou aplatie comme une crêpe ? Il s'avère que la forme de la goutte est déterminante : la force de l'impact peut varier de plus de dix fois simplement à cause de l'apparence de la goutte au moment de la chute.
On peut comparer un réseau de neurones à une résidence où chaque locataire dispose de sa propre chambre. En général, chaque signal dans les données occupe un neurone distinct, et l'apprentissage se fait séquentiellement : d'abord un signal, puis un autre. C'est lent et cela dépend des données rencontrées.
Pour distinguer une protéine d'une autre, il faut décrire sa forme et sa composition. Ces descriptions sont des dizaines : longueur de la molécule, charge, solubilité. Mais elles ne sont pas toutes aussi utiles. La méthode appelée Differentiable Information Imbalance (DII) sait sélectionner les caractéristiques les plus informatives, en éliminant les superflues.
Les vieux bulletins météo réservent des surprises : la colonne du thermomètre bondit soudain d'un demi-degré, non pas à cause du temps, mais parce que la station a changé d'instrument. Ces sauts brusques dans les données sont appelés points de changement, et les distinguer des véritables signaux climatiques est un défi que les statisticiens peinent à relever.
En emménageant dans un nouvel appartement, on ne réapprend pas à ouvrir les portes ni à allumer la lumière. L'expérience de l'ancienne maison se transfère d'elle-même : la cuisine, c'est l'endroit avec la cuisinière et l'évier ; la chambre, celui avec le lit. Le cerveau ne stocke pas une carte exacte, mais un schéma flexible qu'il superpose à un espace inconnu.
Une cellule prise dans un faisceau de protons ressemble à une ville après un bombardement ciblé : ici des quartiers entiers sont détruits, là seulement des vitres sont brisées. La survie de la ville dépend des bâtiments touchés et de la répartition des impacts.
Une goutte de sang peut révéler comment se comporte une tumeur dans les poumons. Les médecins avaient déjà remarqué que lorsque la maladie recule, certains marqueurs sanguins augmentent, d'autres diminuent. Mais relier ces variations dans un tableau cohérent restait un défi.
Le tendon de l'épaule, c'est comme un câble qui maintient le bras et lui permet de pivoter. Lorsqu'un tel câble est blessé, sa structure interne change et il commence à s'étirer différemment. Dans cette étude, les chercheurs ont prélevé le tendon du muscle supra-épineux d'un rat et l'ont étiré le long de ses fibres, tout en enregistrant comment chaque point à l'intérieur se déplaçait.
Affiner un réseau de neurones, c'est un peu comme essayer de modifier un trou noir sans toucher à son horizon des événements : on ne change qu'une petite partie des paramètres.
L'électrocardiogramme ressemble à une partition où chaque note est un battement de cœur. Le médecin entend la mélodie et repère les fausses notes — l'arythmie. Mais écouter la partition pendant des heures est épuisant, c'est pourquoi on place un capteur intelligent au chevet du patient.
Une plaque d'acier avec un réseau de 8×8 cellules atténue les ondes élastiques dans deux couloirs de fréquences à la fois. Ce n'est pas un coup de chance, mais le résultat d'un calcul selon un nouveau schéma : d'abord un motif grossier pour la basse fréquence, puis un affinage fin dans les pixels libres pour la haute fréquence.